可演进性 - 如何让 Agent 上线后持续变强?
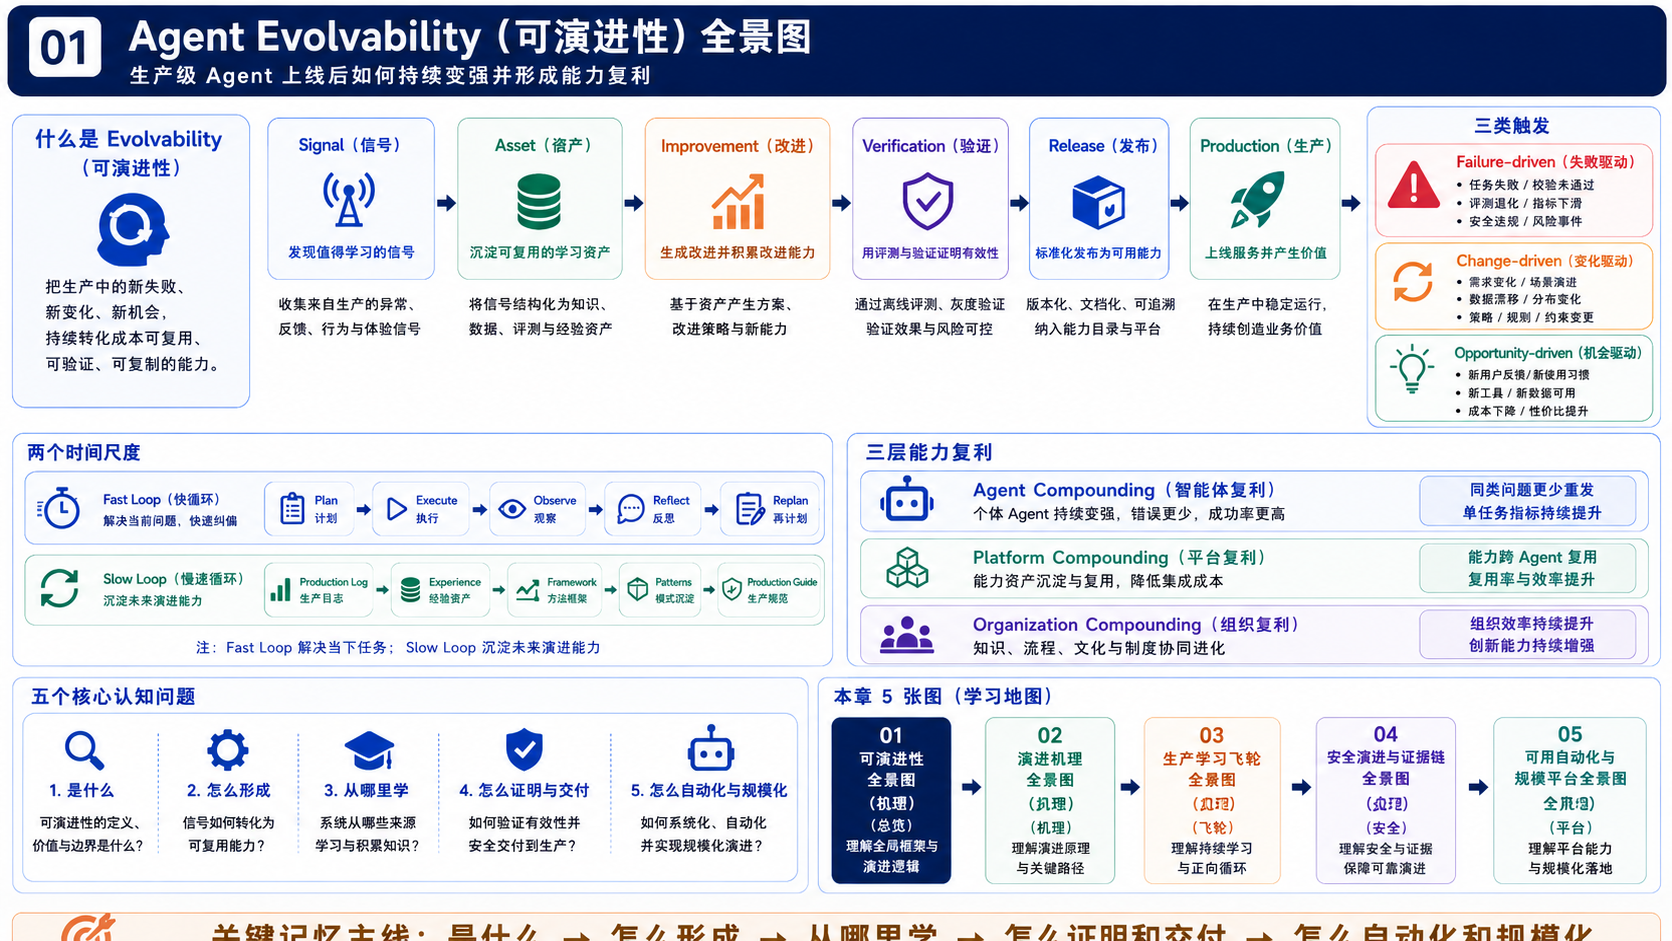
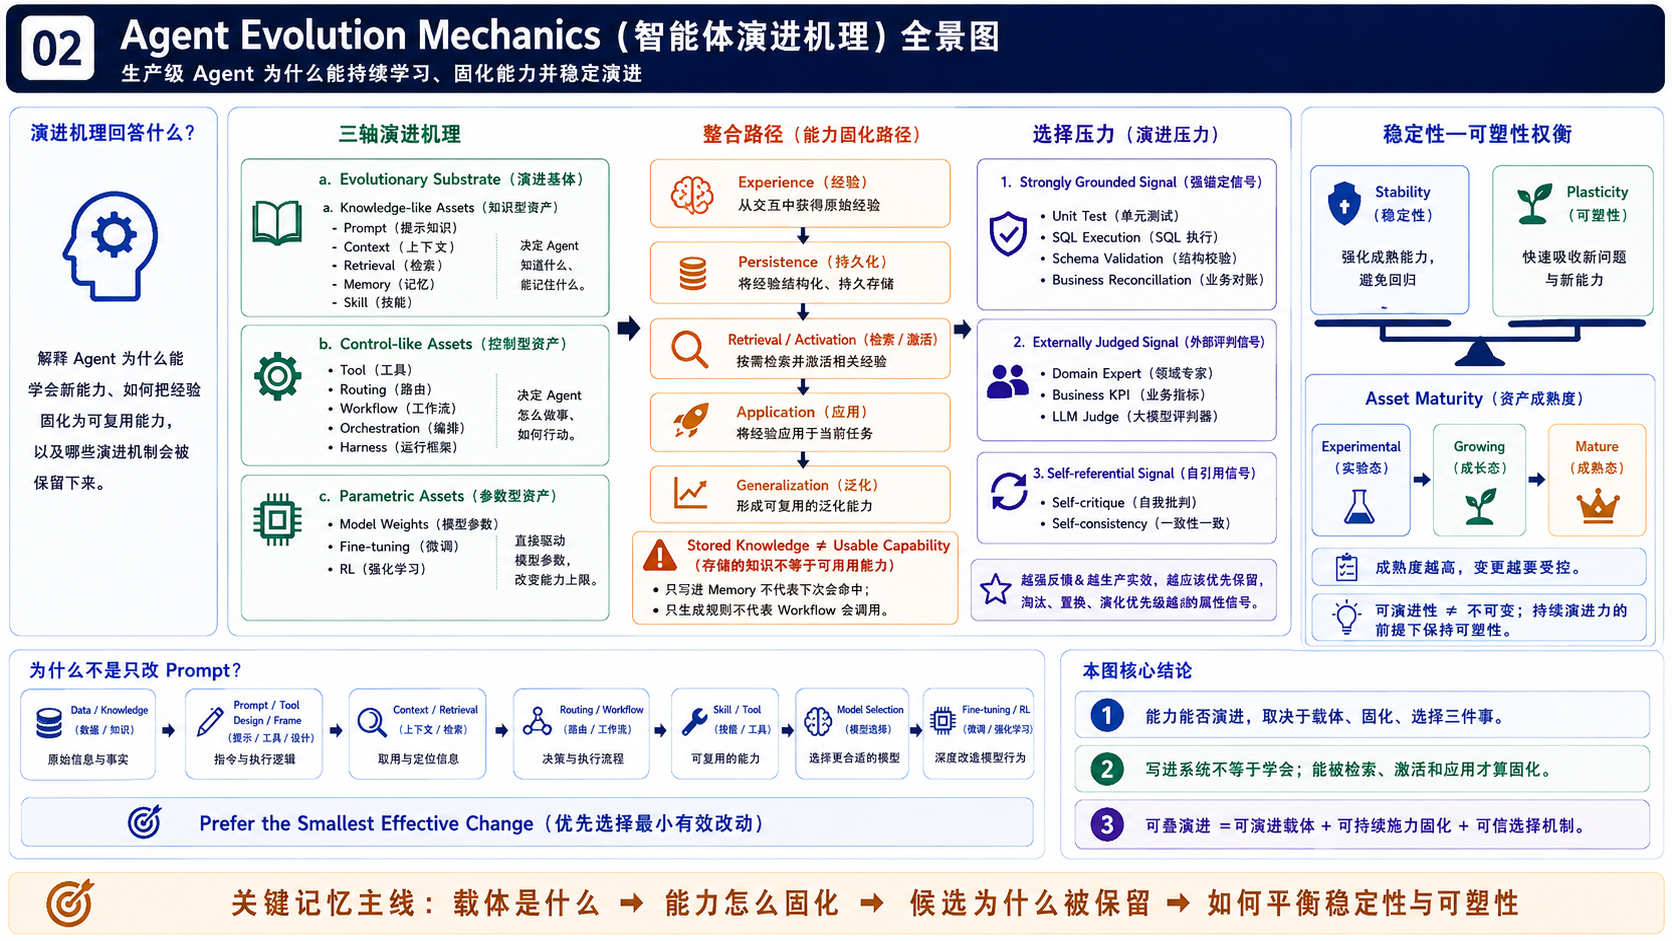
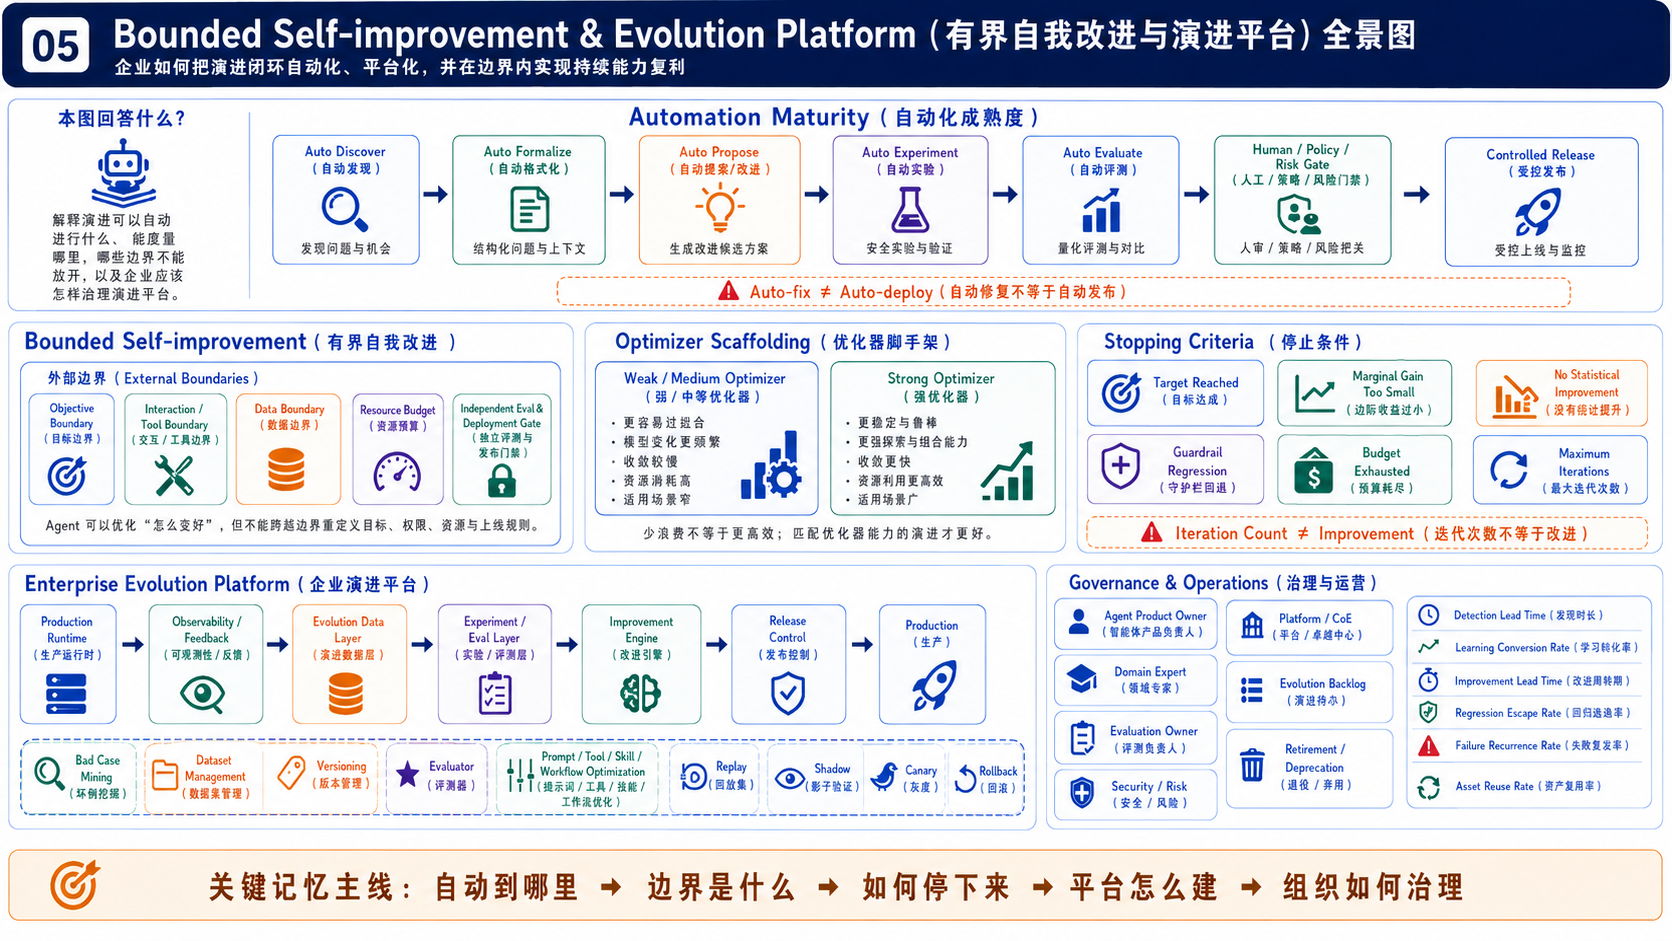
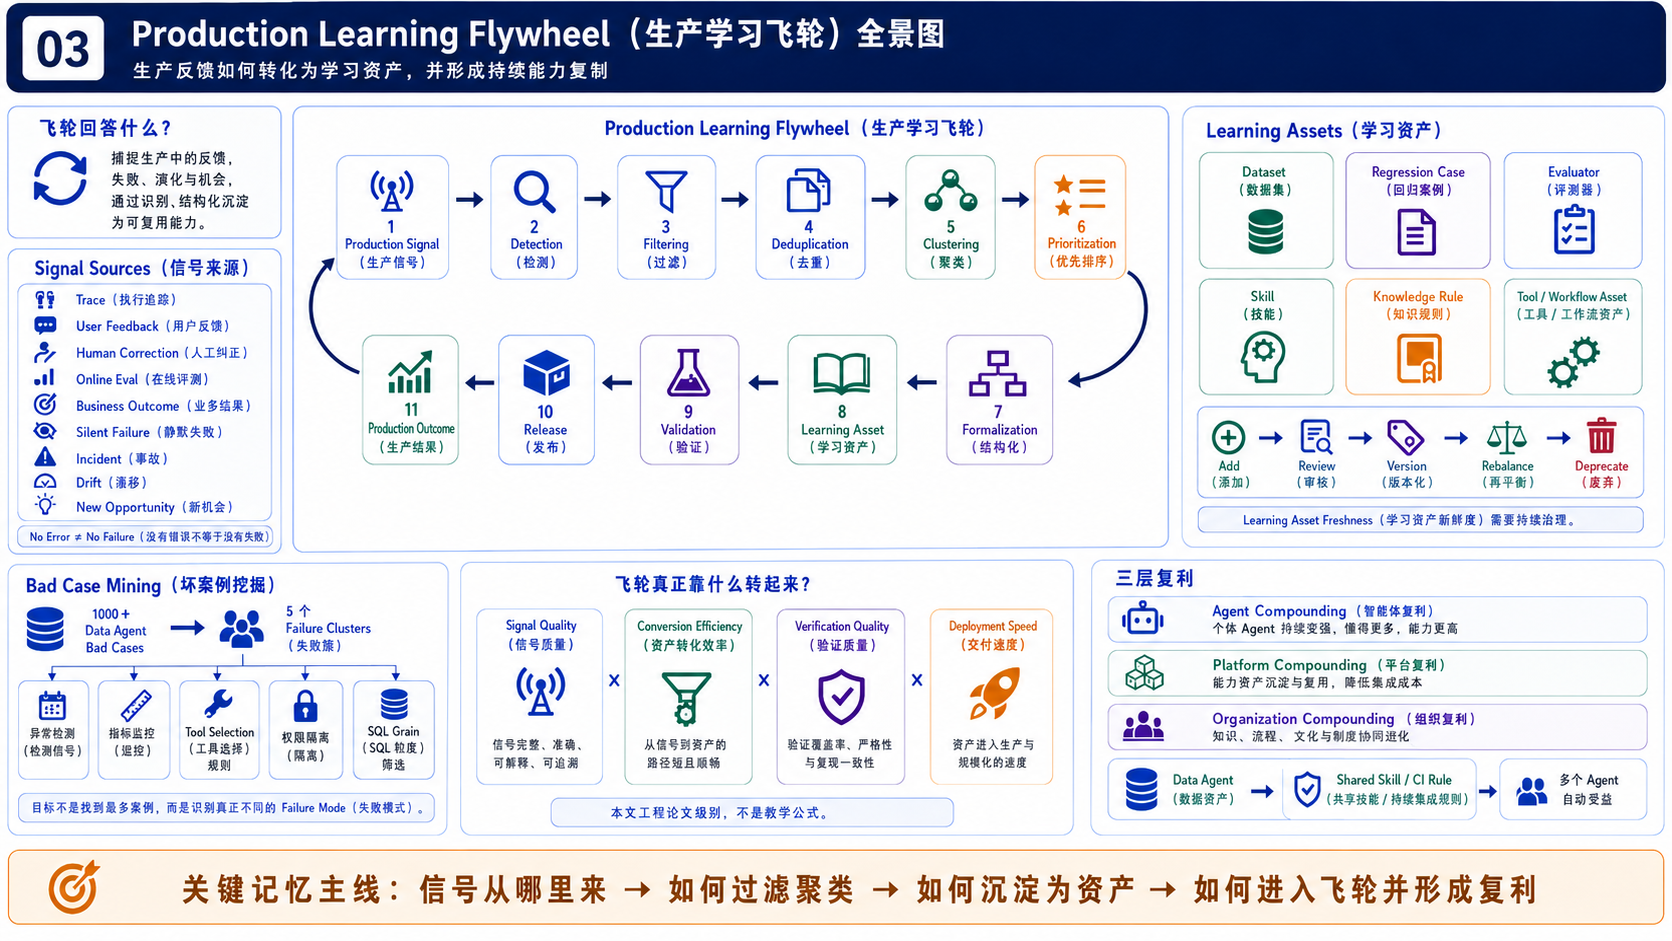
一、Evolvability Fundamentals(可演进性基础)
1.1 什么是 Agent Evolvability(智能体可演进性)?
Agent 上线不是终点。
进入 Production(生产环境)以后,Agent 面对的外部世界会持续变化:
• User Behavior(用户行为)变化 • Business Rule(业务规则)变化 • Knowledge(知识)变化 • Tool / API(工具 / 应用程序接口)变化 • Permission(权限)变化 • Model(模型)升级 • Product Requirement(产品需求)变化 • 新的 Failure Mode(失败模式)持续出现
因此:
一个今天表现优秀的 Agent,并不意味着半年以后仍然优秀。
Agent Evolvability(智能体可演进性)可以定义为:
系统持续把生产环境中的新信号、新失败、新需求、新知识以及新能力机会,转化成可复用的 Learning Asset(学习资产),通过可复现、受控的 Experiment(实验)产生可验证改进,再以安全、可回滚的方式进入后续版本,使系统能力能够长期累积,而不是不断从零解决相同问题的能力。
可以压缩成:
Production Signal(生产信号) → Learning Asset(学习资产) → Verified Change(可验证改进) → Controlled Release(受控发布) → Compounding(能力复利)
所以:
Evolvability ≠ 持续修改 Prompt(提示词)。
也不等于:
Agent 自己修改自己。
真正生产级 Evolvability,本质是一套:
Learning & Change System(学习与变更系统)。
1.2 Adaptation(适应)、Evolution(演进)和 Drift(漂移)有什么区别?
Adaptation(适应)
发生在当前 Task(任务)或 Run(单次运行)内部。
Execution Failure(执行失败) ↓ Reflection(反思) ↓ Replan(重新规划) ↓ Retry(重试) ↓ Task Success(任务成功)
它回答:
这一轮任务怎么成功?
如果任务结束后什么都没有沉淀,下次遇到相同问题仍然从头失败:
这只是 Runtime Adaptation(运行时适应)。
Evolution(演进)
Evolution 关注:
未来 Run 的默认能力有没有变化。
Runtime Failure(运行时失败) ↓ Persist Evidence(沉淀证据) ↓ Extract Learning(提取经验) ↓ Consolidate(能力固化) ↓ Regression Protection(回归保护) ↓ Future Runs Improve(未来运行改善)
所以:
Adaptation 改变当前任务行为;Evolution 改变未来任务默认能力。
Drift(漂移)
即使 Agent 没有主动修改,因为外部环境变化,原有能力也可能逐渐失效。
典型包括:
• Knowledge Drift(知识漂移) • Data Drift(数据分布漂移) • User Behavior Drift(用户行为漂移) • Tool / Integration Drift(工具 / 集成漂移) • Model Behavior Drift(模型行为漂移)
例如原退款规则是:
Refund Window(退款窗口) = 7 days(7 天)
后来业务改成:
Refund Window(退款窗口) = 14 days(14 天)
Agent 代码没出 Bug,但仍然按照旧规则回答:
能力已经发生 Drift。
因此:
Evolvability 同时承担持续增强和持续对抗 Drift 两项职责。
1.3 Fast Loop(快速环)和 Slow Loop(慢速演进环)
Agent 存在两个不同时间尺度的学习闭环。
Fast Loop(快速环)
发生在单个 Task 内:
Plan(规划) → Execute(执行) → Observe(观察) → Reflect(反思) → Replan(重新规划)
目标:
当前任务成功。
Slow Loop(慢速演进环)
跨任务、跨会话、跨版本:
Production Usage(生产使用) ↓ Failure / Change Detection(失败 / 变化检测) ↓ Learning Asset(学习资产) ↓ Improvement(改进) ↓ Experiment(实验) ↓ Release(发布) ↓ Production Validation(生产验证)
目标:
整个 Agent System(智能体系统)的默认能力越来越强。
记忆:
Fast Loop learns within a task(快速环在任务内适应)。
Slow Loop learns across tasks and versions(慢速环跨任务、跨版本演进)。
1.4 Agent 能力到底是怎么持续演进的?
本章最终保留两套 Mother Model(母模型)。
1.4.1、Evolution Loop(演进闭环)
回答:
一次演进如何发生?
Detect Change(发现变化) → Formalize Evidence(结构化证据) → Build Learning Asset(沉淀学习资产) → Diagnose Root Cause(诊断根因) → Propose Change(提出改动) → Experiment & Verify(实验与验证) → Controlled Release(受控发布) → Production Validation(生产验证) → Learn Again(再次学习)
中文压缩:
发现 → 资产化 → 诊断 → 改进 → 验证 → 发布 → 生产验证 → 再学习
1.4.2、Evolution Mechanics(演进机理)
回答:
为什么一次变化能够真正成为长期能力?
核心可以用三个轴理解:
Evolutionary Substrate(演进载体)
- Consolidation Pathway(能力固化路径)
- Selective Pressure(选择压力,即决定哪些候选改动被保留的评价机制)
Evolutionary Substrate(演进载体)
为了避免只罗列名词,可以把演进对象分成三类。
Knowledge-like Assets(知识型资产,本文工程分类)
主要决定:
Agent 知道什么、记住什么。
包括:
• Prompt(提示词) • Context(上下文) • Retrieval Strategy(检索策略) • Memory(记忆) • Skill(技能)
Control-like Assets(控制型资产,本文工程分类)
主要决定:
Agent 怎么执行。
包括:
• Tool Definition(工具定义) • Tool Description(工具描述) • Tool Schema(工具定义结构) • Routing(路由) • Workflow(工作流) • Orchestration(编排) • Harness(运行框架)
Parametric Assets(参数型资产)
直接修改:
Model Weights(模型参数)。
包括:
• Fine-tuning(微调) • Preference Optimization(偏好优化) • Reinforcement Learning(强化学习)
因此对于 Agent Application / Platform Engineer:
主线首先应该是模型外部的 Knowledge-like / Control-like Asset 演进。
1.4.3、Consolidation(能力固化)不只是“存下来”
经验写进 Memory:
不代表下一次一定会用。
真正能力固化需要:
Experience(经验) ↓ Persistence(持久化) ↓ Retrieval / Activation(检索 / 激活) ↓ Application(应用) ↓ Generalization(泛化)
例如:
经验已经进入 Long-term Memory(长期记忆),但:
• Retrieval 没命中 • Skill Trigger(技能触发)没触发 • Context 太长导致信息被稀释 • Workflow 没读取对应 Memory
那么:
系统仍可能重复犯错。
所以必须记住:
Stored Knowledge ≠ Usable Capability(存储的知识不等于真正可用的能力)。
1.4.4、Selective Pressure(选择压力)
系统产生:
Candidate A Candidate B Candidate C
一定需要回答:
为什么保留 A?
验证信号可以分成三类。
Strongly Grounded Signal(强锚定信号)
例如:
• Unit Test(单元测试) • SQL Execution(SQL 执行) • Schema Validation(结构验证) • Numeric Equality(数值一致性) • Business Reconciliation(业务对账)
Externally Judged Signal(外部判断信号)
例如:
• Domain Expert(领域专家) • Business KPI(业务关键指标) • LLM Judge(大模型评测器)
Self-referential Signal(自引用信号)
例如:
• Self-critique(自我批判) • Self-preference(自我偏好) • Self-consistency(自一致性)
Self-evaluation(自我评价)不是完全无效。
更准确的原则是:
越接近高风险生产决策,越应该优先使用独立、直接、难被 Optimizer(优化器)操纵的验证信号。
因此:
Reliable Evolution = Evolvable Substrate + Durable Consolidation + Trustworthy Selection
中文:
可靠演进 = 可演进载体 + 可持续能力固化 + 可信选择机制。
1.5 Stability–Plasticity Trade-off(稳定性—可塑性权衡)
这是长期 Evolvability 的核心矛盾之一。
Plasticity(可塑性)
要求:
新问题出现后,系统能快速学习。
Stability(稳定性)
要求:
已经成熟的能力不能被新修改轻易破坏。
只追求 Plasticity:
解决新 Bad Case ↓ 大改 Skill / Prompt ↓ 旧能力大量 Regression(回归)
只追求 Stability:
所有成熟资产禁止修改 ↓ 无法吸收新知识 ↓ Drift 越来越严重
所以:
Evolvability = Plasticity without losing Stability(可演进性,是在不丢失稳定能力的前提下持续保持可塑性)。
Asset Maturity(资产成熟度,本文工程框架)
可以把 Skill / Prompt / Workflow 等资产粗略分成:
Experimental(实验态)
• 证据少 • 使用面小 • 允许快速修改
Growing(成长期)
• 已经解决部分场景 • 修改需要 Targeted Regression(定向回归)
Mature(成熟态)
• 使用广泛 • Change Blast Radius(变更影响范围)大 • 修改需要严格 Regression、Compatibility(兼容性)和 Rollback(回滚)
所以:
成熟度越高,Plasticity 应越受控。
1.6 Evolvability 的 Trigger(触发源)
最终分三类。
Failure-driven Evolution(失败驱动演进)
• Answer Error(回答错误) • Tool Selection Error(工具选择错误) • SQL Error • User Complaint(用户投诉) • Production Incident(生产事故)
Change-driven Evolution(变化驱动演进)
• Knowledge Update(知识更新) • Business Rule Change(业务规则变化) • Tool API Change(工具接口变化) • Policy Change(策略变化) • Model Upgrade(模型升级)
Opportunity-driven Evolution(机会驱动演进)
• 更强的新模型 • 新 Tool • 新 Skill • 新 Runtime • 新业务场景
因此:
Evolvability 既负责防退化,也负责吸收新能力。
1.7 Production Learning Flywheel(生产学习飞轮)
最终完整飞轮:
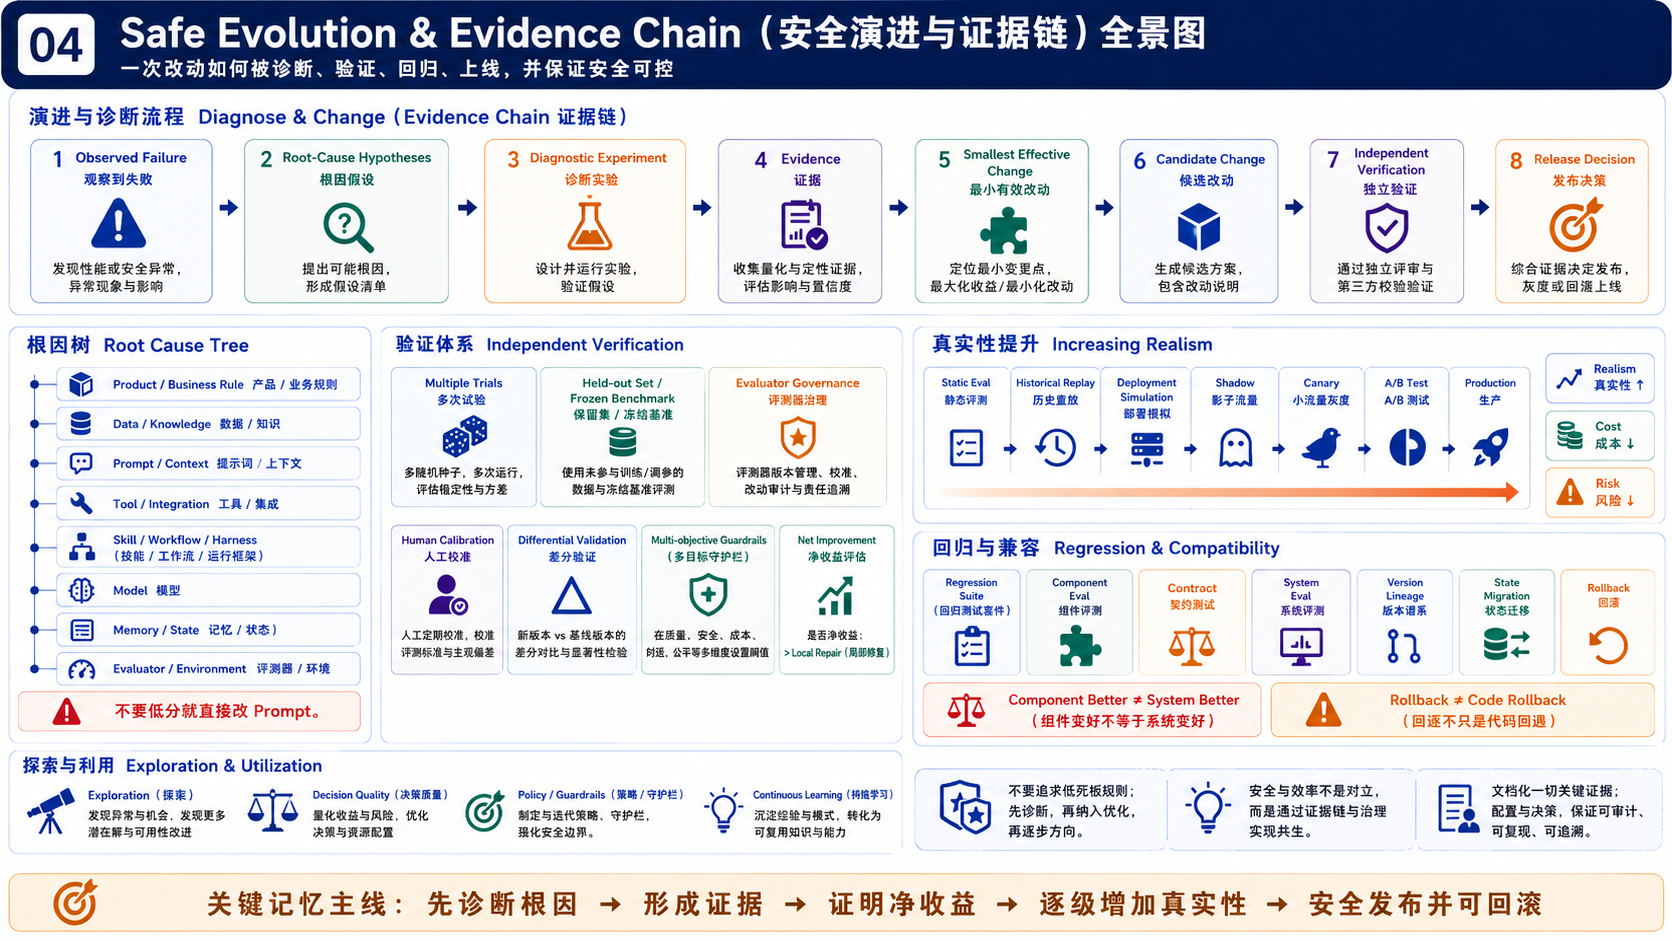
Production Usage(生产使用) ↓ Signal Detection(信号发现) ↓ Bad Case / Drift / Opportunity Mining (坏案例 / 漂移 / 机会挖掘) ↓ Learning Asset(学习资产) ↓ Root Cause Hypothesis(根因假设) ↓ Diagnostic Experiment(诊断实验) ↓ Candidate Change(候选改动) ↓ Independent Verification(独立验证) ↓ Controlled Release(受控发布) ↓ Production Outcome(生产结果) ↓ Compounding(能力复利)
Compounding 最终分三层。
Agent Compounding(智能体复利)
一个 Agent:
同类问题越来越少复发。
Platform Compounding(平台复利)
一个 Agent 的经验沉淀成:
• Shared Skill(共享技能) • Shared SDK(共享软件开发工具包) • Tool • Eval Template(评测模板) • Guardrail(护栏) • Golden Path(黄金路径)
其他 Agent 自动受益。
Organization Compounding(组织复利)
整个组织:
• 新 Agent 上线更快 • 已知问题不重复踩 • Model Upgrade 更快 • Release / Eval 能力持续复用
所以:
真正的数据飞轮不是数据越多,而是“生产问题 → 永久能力”的转化效率越来越高。
二、Production Feedback & Learning Assets(生产反馈与学习资产)
2.1 Production Signal(生产信号)从哪里来?
至少包括:
• Trace(执行追踪) • User Feedback(用户反馈) • Human Correction(人工纠正) • Eval Score(评测分数) • Business Outcome(业务结果) • Escalation(转人工) • Incident(生产事故) • Tool Failure(工具失败) • Online Eval(在线评测) • Anomaly(异常) • New Intent(新意图) • Drift Signal(漂移信号)
还要特别关注:
Silent Failure(静默失败)
即:
HTTP 200 ✅ Tool Success(工具成功) ✅ No Exception(没有异常) ✅
但:
用户目标实际上没有完成 ❌
所以:
No Error ≠ No Failure(没有报错不等于没有失败)。
2.2 为什么不能只依赖用户点踩?
因为存在:
Selection Bias(选择偏差)。
大量失败:
• 用户没有发现 • 用户懒得反馈 • 用户直接离开 • 用户自己修正 • 业务结果延迟暴露
所以还需要:
• Online Evaluation(在线评测) • Random Audit(随机审计) • Human Sampling(人工抽检) • Business Outcome • Rule-based Detection(规则检测) • Anomaly Detection(异常检测)
否则 Data Flywheel 可能变成:
Feedback Bias Flywheel(反馈偏差飞轮,本文工程表达)。
2.3 Production Signal 怎么变 Learning Asset(学习资产)?
Production Signal(生产信号) ↓ Reproducible Case(可复现案例) ↓ Failure Label(失败标签) ↓ Expected Behavior(期望行为) ↓ Evidence / Trace(证据 / 追踪) ↓ Dataset Item(数据集样本) ↓ Regression Case(回归案例)
所以:
Raw Feedback(原始反馈) ≠ Learning Asset(学习资产)。
真正关键的是:
Signal-to-Asset Conversion(信号资产化)。
2.4 海量 Trace 怎么做 Bad Case Mining(坏案例挖掘)?
成熟流程:
Production Signals(生产信号) ↓ Filtering(过滤) ↓ Deduplication(去重) ↓ Clustering(聚类) ↓ Failure Mode Discovery(失败模式发现) ↓ Prioritization(优先排序) ↓ Human / Rule Review(人工 / 规则审核) ↓ Learning Asset(学习资产)
目标不是:
找到最多的 Bad Case。
而是:
识别真正不同的 Failure Mode。
例如:
1000 个 Data Agent 错误 ↓ 5 个 Failure Cluster(失败簇)
A:时间范围解析错误 B:指标口径错误 C:Tool Selection 错误 D:权限错误 E:SQL Grain(SQL 粒度)错误
真正应该修:
Failure Class(失败类型)。
2.5 Bad Case 怎么排序?
可以使用本文工程排序模型:
Impact(影响) × Frequency(频率) × Risk(风险) × Novelty(新颖性) × Recurrence(复发) ÷ Effort(改进成本)
注意:
不是严格数学公式。
例如:
Failure A: 每天发生 10,000 次 只是文案略差
Failure B: 每月发生 5 次 可能错误退款
B 很可能优先。
所以:
Bad Case Mining 的终点是找到最值得进入 Improvement Loop(改进闭环)的问题。
2.6 为什么 Data Flywheel 不是“数据越多越好”?
本文用一个工程记忆模型理解:
Signal Quality × Conversion Efficiency × Verification Quality × Deployment Speed
分别代表:
• Signal Quality(信号质量) • Conversion Efficiency(资产转化效率) • Verification Quality(验证质量) • Deployment Speed(交付速度)
核心不是:
Data Volume(数据量)。
而是:
真实问题转化成永久能力的效率。
2.7 Dataset / Regression Suite 为什么需要长期治理?
Dataset 可能出现:
• Duplicate Case(重复案例) • Obsolete Case(过时案例) • Conflicting Label(冲突标签) • Distribution Drift(分布漂移) • Segment Imbalance(分群失衡) • Missing New Workload(缺失新工作负载) • Wrong Expected Output(错误期望输出)
因此需要:
Add(添加) → Review(审核) → Deduplicate(去重) → Label(标注) → Version(版本化) → Rebalance(重新平衡) → Deprecate(废弃)
即:
Dataset Curation(数据集治理)
而不是:
Dataset Accumulation(数据集堆积)。
2.8 Learning Asset 也会 Drift
会过时的包括:
• Expected Output(期望输出) • Golden Answer(黄金答案) • Rubric(评测规则) • Evaluator(评测器) • Expected Tool Trajectory(期望工具执行轨迹) • Skill • Prompt • Memory
所以重要 Learning Asset 最好记录:
• Owner(负责人) • Source of Truth(事实来源) • Version(版本) • Last Reviewed(最近审核时间) • Review / Expiration Date(审核 / 过期时间) • Dependency(依赖关系)
这里称为:
Learning Asset Freshness(学习资产新鲜度,本文工程概念)。
2.9 Context Evolution(上下文演进)为什么会产生 Context Collapse(上下文坍缩)?
如果不断:
详细经验 ↓ 摘要 ↓ 再摘要 ↓ 更泛化规则 ↓ 关键细节逐渐消失
就会形成:
Context Collapse(上下文坍缩)。
因此:
Prefer incremental curation over repeated full rewriting(优先结构化增量治理,而不是反复全量重写)。
实践上:
• 新经验增量加入 • 冲突 Rule 显式合并 • 旧 Rule 显式废弃 • 保留 Provenance(来源) • 避免无限 Summary of Summary(摘要的摘要)
2.10 Capability Asset(能力资产)也需要 Lifecycle(生命周期)
不能:
失败 → 新 Rule → 新 Skill → 新 Rule → 新 Skill → 无限增长
否则会出现:
• Skill Overlap(技能重叠) • Trigger Conflict(触发冲突) • Context 增长 • Skill Selection 变难 • Ownership 混乱 • Maintenance Cost 上升
因此 Skill / Prompt / Workflow 也需要:
Create(创建) → Validate(验证) → Deploy(部署) → Observe(观察) → Improve(改进) → Refactor(重构) → Deprecate(废弃)
核心:
健康演进既需要 Acquisition(获取新能力),也需要 Controlled Forgetting / Deprecation(受控遗忘 / 废弃)。
2.11 Synthetic Data(合成数据)怎么用?
适合:
• Rare Scenario(稀有场景) • New Feature(新功能) • Safety Edge Case(安全边界场景) • 小语种 • 特殊权限组合
主要用于:
Coverage Expansion(覆盖扩展)。
但不能替代 Production Data。
风险:
• Generator Bias(生成器偏差) • Shared Blind Spot(共享盲区) • Distribution Mismatch(分布不匹配)
原则:
Production Data anchors reality(生产数据锚定现实)。
Synthetic Data expands coverage(合成数据扩展覆盖)。
三、Improvement & Verification(改进与验证)
3.1 Failure 到底来自哪里?
成熟 Root Cause Tree(根因树):
Observed Failure(观察到失败) ├─ Product / Business Rule(产品 / 业务规则) ├─ Data / Knowledge(数据 / 知识) ├─ Prompt / Context(提示词 / 上下文) ├─ Tool / Integration(工具 / 集成) ├─ Skill / Workflow / Harness(技能 / 工作流 / 运行框架) ├─ Model(模型) ├─ Memory / State(记忆 / 状态) └─ Evaluation / Environment(评测 / 环境)
所以不能:
Low Score → 直接改 Prompt
应该:
Low Score(低分) → Reproduce(复现) → Inspect Trace(检查追踪) → Check Expected Behavior(检查期望行为) → Check Dataset(检查数据集) → Check Evaluator(检查评测器) → Check Environment / Harness(检查环境 / 运行框架) → Diagnose Agent(诊断 Agent)
3.2 应该改 Prompt、Tool、Skill、Workflow 还是 Model?
首先判断属于:
• Knowledge-like Asset(知识型资产) • Control-like Asset(控制型资产) • Parametric Asset(参数型资产)
其中模型外资产的演进统称:
Non-parametric Evolution(非参数演进)。
修改 Model Weights 的演进属于:
Parametric Evolution(参数演进)。
对于 Agent Application / Platform Engineer:
优先考虑 Non-parametric Evolution。
只有明确属于 Base Model Capability Gap(基础模型能力缺口):
才考虑 Fine-tuning / RL。
3.3 Smallest Effective Change(最小有效改动)
Change Ladder(改进阶梯,本文工程决策框架):
Data / Knowledge(数据 / 知识) ↓ Prompt / Tool Description(提示词 / 工具描述) ↓ Context / Retrieval(上下文 / 检索) ↓ Routing / Workflow(路由 / 工作流) ↓ Skill / Tool(技能 / 工具) ↓ Model Selection(模型选择) ↓ Fine-tuning / RL(微调 / 强化学习)
不是严格顺序。
核心:
Prefer the Smallest Effective Change(优先选择足以解决问题的最小有效改动)。
3.4 为什么要 Fix Failure Mode,而不是 Fix Example?
正确链:
Bad Case(坏案例) ↓ Failure Cluster(失败簇) ↓ Root Cause(根因) ↓ General Fix(通用修复) ↓ Regression Family(回归案例族)
原则:
Fix the Failure Mode, not the Example(修失败模式,而不是只修样例)。
3.5 为什么 Experiment 要分 Diagnostic 和 Improvement?
Diagnostic Experiment(诊断实验)
回答:
Root Cause Hypothesis(根因假设)是否成立?
Improvement Experiment(改进实验)
回答:
已经确定方向后的 Candidate Change 是否真正改善系统?
完整链:
Observed Failure(观察到失败) ↓ Root Cause Hypotheses(根因假设集合) ↓ Diagnostic Experiment(诊断实验) ↓ Evidence(证据) ↓ Candidate Change(候选改动) ↓ Improvement Experiment(改进实验)
所以:
Evolvability 应该是 Hypothesis-driven Engineering(假设驱动工程)。
3.6 Exploration–Exploitation(探索—利用)怎么平衡?
如果系统一开始认为:
问题在 Prompt,
然后只不断优化 Prompt:
可能陷入 Exploitation Trap(利用陷阱)。
所以:
Failure ↓ Hypothesis A / B / C ↓ Targeted Diagnostic Test ↓ Evidence ↓ Explore plausible causes(探索可能原因) + Exploit supported cause(深入优化高证据原因)
不要过早锁死 Root Cause。
3.7 为什么 Experiment 必须 Reproducible(可复现)?
至少记录:
Agent Version(智能体版本) Prompt Version(提示词版本) Model Version(模型版本) Tool Version(工具版本) Skill Version(技能版本) Workflow Version(工作流版本) Dataset Version(数据集版本) Evaluator Version(评测器版本) Configuration(运行配置) Environment(运行环境)
原则:
不能复现的“变好”,不算可靠工程演进。
3.8 Non-determinism(非确定性)怎么处理?
不能只跑一次。
应该看:
• Multiple Trials(多次试验) • Pass Rate(通过率) • Distribution(结果分布) • Variance(方差) • Consistency(稳定一致性) • Segment Performance(分群表现)
所以:
Candidate Comparison(候选比较)必须看分布,而不是单次结果。
3.9 怎么保证 Evaluator(评测器)本身可信?
需要 Evaluator Governance(评测器治理):
• Evaluator Version(评测器版本) • Calibration Set(校准集) • Frozen Benchmark(冻结基准) • Human–Evaluator Agreement(人与评测器一致性) • Drift Monitoring(漂移监控) • Cross-judge Comparison(多评测器交叉比较)
避免:
Self-confirming Loop(自我确认循环)。
核心:
Improvement Target 与 Evaluation Authority 必须保持必要独立。
3.10 Human Feedback 是不是 Ground Truth?
不是绝对真值。
需要:
• Annotation Guideline(标注指南) • Inter-annotator Agreement(标注者一致性) • Confidence(置信度) • Calibration(校准) • Adjudication(仲裁)
所以:
Human-in-the-loop ≠ Human-is-always-right。
3.11 怎么避免 Eval Overfitting(评测过拟合)?
需要防:
• Reward Hacking(奖励投机) • Eval Gaming(评测投机) • Eval Overfitting(评测过拟合) • Benchmark Leakage(基准泄漏) • Evaluation Awareness(评测意识)
至少有:
• Stable Core(稳定核心集) • Held-out Set(保留测试集) • Rotating Holdout(轮换保留集) • Production-derived Cases(生产衍生案例) • Human Review(人工复核) • Real User Metrics(真实用户指标)
3.12 Evaluation Realism(评测真实性)
可以使用 Realism Ladder(真实性阶梯,本文工程表达):
Static Eval(静态评测) ↓ Historical Replay(历史重放) ↓ Deployment Simulation(部署模拟) ↓ Shadow Traffic(影子流量) ↓ Canary / A/B(灰度 / A/B) ↓ Production(生产)
越接近 Production:
• 真实性更高 • 成本更高 • 风险也更高
3.13 Skill Evolution 为什么需要 Differential Validation(差分验证)?
同一个 Task 比较:
A:No Skill(无技能) B:Skill v2 C:Skill v3
同时看:
• Task Success • Quality • Latency • Token • Cost • Tool Calls • Regression
本文工程记忆模型:
Net Skill Value(技能净收益) ≈ Repairs(修复收益) − Regressions(新增回归)
不是严格数学公式。
所以:
Skill 是能力载体,也是新的 Failure Surface(失败面)。
3.14 为什么演进应该看 Net Improvement(整体净收益)?
一个 Candidate 不能因为:
修好了当前 Case
就被接受。
必须同时看:
Broader Regression(更广回归)。
核心:
Evolution should be gated by net improvement, not local repair(演进应该以整体净收益为门槛,而不是局部修复成功)。
3.15 为什么 Evolvability 是 Multi-objective Optimization(多目标优化)?
同时关注:
• Quality(质量) • Safety(安全) • Reliability(稳定性) • Performance(性能) • Cost(成本) • Capacity(容量) • Human Review Effort(人工审核成本)
所以:
Guardrail-constrained Optimization(受护栏约束的优化)
才是生产级改进。
四、Release & Regression(发布与回归)
4.1 Regression Suite 应该包含什么?
至少包括:
• Known Failure Cases(历史失败案例) • Golden Core Cases(核心黄金案例) • Representative Distribution(代表性生产分布) • Edge Cases(边界案例) • Safety / Risk Cases(安全 / 风险案例)
因此:
Regression Suite ≠ Bug Archive(Bug 档案)。
而是:
产品能力契约。
4.2 什么变化应该触发 Regression?
包括:
• Prompt Change • Model Upgrade • Tool Change • Skill Change • Knowledge Update • Retrieval Change • Workflow Change • Routing Change • Policy Change • Evaluator Change • Dataset Change • Production Incident
所以需要:
Scheduled Evaluation(定期评测) + Event-triggered Evaluation(事件触发评测)。
4.3 Continuous Evaluation(持续评测)怎么设置节奏?
Every Change(每次变更)
• Core Regression • Contract Test
Nightly(每日)
• Larger Dataset • Representative Variations
Weekly / Release(每周 / 发布前)
• Full Regression • Safety • Performance • Cost • Edge Cases
4.4 Candidate 怎么安全进入 Production?
Candidate Version(候选版本) ↓ Offline Eval(离线评测) ↓ CI Regression(持续集成回归) ↓ Historical Replay(历史重放) ↓ Deployment Simulation(部署模拟) ↓ Shadow(影子验证) ↓ Canary(灰度发布) ↓ A/B Test(A/B 实验,可选) ↓ Production(生产) ↓ Monitor(监控) ↓ Promote / Rollback(全量 / 回滚)
记住:
Eval Win ≠ Release Approval(评测胜出不等于允许发布)。
4.5 Historical Replay 的边界
Replay 很适合 Regression。
但无法完整复制:
• Dynamic Tool Data(动态工具数据) • Current State(当前状态) • Concurrency(并发) • Tool Side Effect(工具副作用) • User Adaptation(用户行为变化)
所以:
Replay improves realism, but does not reproduce production。
4.6 Agent A/B Test 为什么更难?
特殊问题:
• Session Stickiness(会话粘性) • Delayed Outcome(延迟结果) • Stateful Interaction(有状态交互) • Tool Side Effect(工具副作用)
所以:
Shadow first, controlled live experiment second。
4.7 新 Model / Tool / Skill 怎么决定是否升级?
New Model / Tool / Skill ↓ Compatibility Eval(兼容性评测) ↓ Regression Eval(回归评测) ↓ Capability Eval(能力评测) ↓ Quality / Safety / Cost / Latency ↓ Prompt / Workflow Adaptation ↓ Shadow ↓ Canary ↓ Promote / Rollback
这是:
Model Upgrade Agility(模型升级敏捷性)。
4.8 为什么 Component Better ≠ System Better?
Multi-Agent 必须同时有:
• Component Eval(组件评测) • Contract Test(契约测试) • System Eval(系统级评测)
检查:
• Input Contract • Output Contract • Tool Contract • State Contract • Data Contract
核心:
Local Improvement ≠ System Improvement(局部改进不等于系统改进)。
4.9 Version Lineage(版本谱系)
例如:
System Release 2026.09
Supervisor = v5 SQL Agent = v7 Research Agent = v3 Tool Contract = v4 Prompt Pack = v12 Dataset = v18 Evaluator = v6
Version Lineage 支持:
• Reproduce(复现) • Compare(比较) • Regression Attribution(回归归因) • Change Impact Analysis(变更影响分析) • Rollback(回滚)
4.10 Rollback 为什么不只是 Code Rollback?
还可能涉及:
• Prompt Rollback • Model Rollback • Workflow Rollback • Tool Contract Rollback • State Migration(状态迁移) • Data Migration(数据迁移) • Memory Migration(记忆迁移) • Cache Invalidation(缓存失效) • Side-effect Reconciliation(副作用对账 / 修复)
核心:
任何随版本演进的持久状态,都必须设计兼容、迁移和回滚策略。
五、Automation & Evolution Platform(自动化与演进平台)
5.1 Self-improvement 能自动到什么程度?
成熟链路:
Auto Discover(自动发现) → Auto Formalize(自动结构化) → Auto Propose(自动提出候选) → Auto Experiment(自动实验) → Auto Evaluate(自动评测) → Human / Policy / Risk Gate (人工 / 策略 / 风险门禁) → Controlled Release(受控发布)
原则:
Automate what can be formalized; escalate what remains ambiguous.
5.2 Bounded Self-improvement(有界自我改进)
外部固定五类边界:
- Objective Boundary(目标边界)
- Interaction / Tool Boundary(交互 / 工具边界)
- Data Boundary(数据边界)
- Resource Budget(资源预算)
- Independent Evaluation & Deployment Gate(独立评测与发布门禁)
核心:
Agent 可以优化“怎么变好”,但不能单方面重新定义“什么叫好、能做什么、能看什么、最多花多少资源、谁判断变好,以及何时能上线”。
5.3 Optimizer Scaffolding(优化器脚手架)
Weak / Medium Optimizer(较弱 / 中等能力优化器)
需要更多:
• Fixed Steps(固定步骤) • Root Cause Schema(根因结构) • Candidate Template(候选模板) • Search Strategy(搜索策略) • Budget
Strong Optimizer(强优化器)
可以减少 Prescribed Pipeline(预定义流水线)。
但是:
外部边界不能消失。
所以:
少流程不等于更高级;匹配 Optimizer 能力的流程才更好。
5.4 Stopping Criteria(停止条件)
至少包括:
• Target Reached(目标达到) • Marginal Gain Too Small(边际收益过小) • No Statistical Improvement(没有可信提升) • Guardrail Regression(护栏退化) • Resource Budget Exhausted(资源预算耗尽) • Maximum Iterations(最大迭代次数)
应该看:
Verified Marginal Improvement(经验证的边际收益)
而不是:
Iteration Count(迭代次数)。
5.5 为什么自动化越强,Verifier 要求越高?
更准确的原则:
越接近高风险 Production Decision,越需要独立、直接、难被优化器操纵的验证信号。
而不是机械宣称:
某一种 Evaluator 永远优于另一种。
5.6 Skill 为什么是重要演进单元?
Skill 可以独立:
• Version • Eval • Rollback • Reuse • Ownership • Differential Validation
因此代表:
Modular Evolvability(模块化可演进性)。
但:
Skill 不是天然有益。
5.7 Memory Evolution(记忆演进)
至少要管理:
• Provenance(来源) • Confidence(置信度) • Expiration(过期) • Conflict Resolution(冲突解决) • Scope(作用域) • Forgetting(遗忘)
并验证:
Retrieval / Activation 是否真正有效。
5.8 Fine-tuning / RL(微调 / 强化学习)
属于:
Parametric Evolution(参数演进)。
对于 Agent Application / Platform:
保持 P2。
5.9 Environment Evolution(环境演进)
属于 Research Frontier(研究前沿)。
长期可能形成:
Agent evolves ↕ Evaluator evolves ↕ Environment evolves
Environment 更准确属于:
Learning / Selection Infrastructure(学习 / 选择基础设施)。
5.10 Environment Overfitting(环境过拟合)
防护:
• Environment Variation • Multiple Environments • Historical Replay • Deployment Simulation • Shadow • Production Outcome
保持 P2。
5.11 Agent Evolution Platform(智能体演进平台)
完整架构:
Production Agent Runtime(生产运行时) ↓ Observability / Feedback Layer(可观测 / 反馈层) ↓ Evolution Data Layer(演进数据层) ├─ Bad Case Mining(坏案例挖掘) ├─ Failure Clustering(失败聚类) ├─ Dataset Management(数据集管理) ├─ Annotation(标注) └─ Versioning(版本管理) ↓ Improvement & Experiment Layer(改进 / 实验层) ├─ Diagnostic Experiment(诊断实验) ├─ Baseline(基线) ├─ Candidate(候选) ├─ Evaluator(评测器) ├─ Comparison(比较) └─ Guardrails(护栏) ↓ Improvement Engine(改进引擎) ├─ Human Change(人工修改) ├─ Prompt Optimization(提示词优化) ├─ Tool Optimization(工具优化) ├─ Skill Optimization(技能优化) ├─ Workflow / Harness Optimization(工作流 / 运行框架优化) └─ Agent-generated Candidate(Agent 生成候选) ↓ Release Control(发布控制) ├─ CI Regression(持续集成回归) ├─ Replay(历史重放) ├─ Simulation(模拟) ├─ Shadow(影子) ├─ Canary(灰度) ├─ A/B └─ Rollback(回滚) ↓ Production(生产)
5.12 企业里谁负责 Evolvability?
至少涉及:
• Agent Product Owner(智能体产品负责人) • Domain Expert(领域专家) • Engineering Team(工程团队) • Evaluation Owner(评测负责人) • Security / Risk(安全 / 风险团队) • Platform / CoE(平台 / 卓越中心)
所以:
Evolvability 最终不仅是技术能力,也是组织的软件交付能力。
5.13 Evolution Backlog(演进待办)
每个 Item 最好包含:
• Evidence(证据) • Severity(严重度) • Frequency(频率) • Root Cause Candidate(根因候选) • Eval Target(评测目标) • Owner • Expected Impact(预期影响) • Status(状态)
5.14 Retirement / Deprecation(退役 / 废弃)
演进不等于无限增加。
Monitor(监控) ↓ Value / Risk Review(价值 / 风险审查) ↓ ├─ Invest(继续投入) ├─ Maintain(维持) ├─ Merge(合并) ├─ Replace(替换) └─ Retire / Deprecate(退役 / 废弃)
防止:
• Agent Sprawl(智能体蔓延) • Capability Sprawl(能力资产蔓延)
5.15 Evolvability Metrics(可演进性指标)
核心 8 个:
- Detection Lead Time(问题发现时长)
- Learning Conversion Rate(学习转化率)
- Improvement Lead Time(改进交付周期)
- Regression Escape Rate(回归逃逸率)
- Failure Recurrence Rate(失败复发率)
- Coverage Growth(覆盖增长)
- Improvement Throughput(改进吞吐,P1)
- Asset Reuse Rate(资产复用率,本文工程指标,P1)
Safe Automation Rate(安全自动化率)作为辅助 Platform Maturity Metric(平台成熟度指标),不作为核心指标。
5.16 13 类核心 Anti-pattern(反模式)
- Fix Example, Miss Failure Mode(修样例而不是失败模式)
- Rubber-banding(橡皮筋式来回摆动)
- Dataset / Capability Only Grows(数据集 / 能力资产只增不治理)
- Learning Asset Goes Stale(学习资产老化)
- Feedback Bias Flywheel(反馈偏差飞轮)
- Change Too Many Variables(一次改太多变量)
- Eval Gaming / Overfitting(评测投机 / 过拟合)
- Evaluator Drift / Defect(评测器漂移 / 缺陷)
- Component Better, System Worse(组件变好、系统变差)
- Auto-fix → Auto-deploy(自动修复直接自动发布)
- Code Rollback Without State Rollback(代码回滚但状态没回滚)
- Agent / Capability Never Retires(Agent / 能力资产永不退役)
- Unbounded Optimization(无界优化)
5.17 六条最高级原则
-
Turn Production Signals into Permanent Assets 把生产信号转成永久工程资产。
-
Fix Failure Modes, Not Examples 修失败模式,而不是只修样例。
-
Prefer the Smallest Effective Change 优先选择最小有效改动。
-
Separate Improvement from Evaluation 改进者与裁判保持必要独立。
-
More Autonomy Requires Stronger Verification 演进越自动,独立验证越重要。
-
Evolution Must Compound 真正演进必须形成长期能力复利。
5.18 P0 / P1 / P2
P0:20 个核心问题
- 什么是 Agent Evolvability?
- Adaptation、Evolution、Drift 有什么区别?
- Agent 能力如何被演进和固化?
- Production Learning Flywheel 是什么?
- Production Signal 怎么变 Learning Asset?
- 海量 Trace 怎么做 Bad Case Mining?
- 为什么 Data Flywheel 不是数据越多越好?
- Dataset / Regression Suite 怎么长期治理?
- Failure 后怎么定位 Root Cause?
- 怎么判断改 Prompt、Tool、Skill、Workflow 还是 Model?
- 为什么 Fix Failure Mode 而不是 Fix Example?
- Agent Experiment 怎么建立可信结论?
- Non-determinism 下怎么证明 Candidate 更好?
- 怎么保证 Dataset、Evaluator、Human Feedback 可信?
- 怎么避免 Eval Overfitting 和多目标失衡?
- Verified Improvement 怎么安全进入 Production?
- 新 Model / Tool / Skill 怎么判断是否升级?
- Multi-Agent / Stateful Agent 怎么版本、兼容、迁移和回滚?
- Self-improvement 可以自动到什么程度?
- 企业级 Agent Evolution Platform 怎么建设?
P1:重要进阶
• Synthetic Data(合成数据) • Automated Eval Generation(自动评测生成) • Evaluation Awareness(评测意识) • Historical Replay(历史重放) • Deployment Simulation(部署模拟) • Online A/B Test(在线 A/B 实验) • Safe Exploration(安全探索) • Context Evolution(上下文演进) • Context Collapse(上下文坍缩) • Skill Evolution(技能演进) • Skill Differential Validation(技能差分验证) • Exploration–Exploitation(探索—利用权衡) • Diagnostic Experiment(诊断实验) • Optimizer Scaffolding(优化器脚手架) • Memory Evolution(记忆演进) • Evaluator Governance(评测器治理) • Human Feedback Calibration(人工反馈校准) • Version Lineage(版本谱系) • Change Impact Analysis(变更影响分析) • Evolution Backlog(演进待办) • Evolution Metrics(演进指标) • Improvement Throughput(改进吞吐) • Asset Reuse Rate(资产复用率) • Agent / Capability Retirement(智能体 / 能力资产退役)
P2:高级 / 前沿
• Fine-tuning(微调) • Preference Optimization(偏好优化) • Reinforcement Learning(强化学习) • Agent Post-training(智能体后训练) • Environment Evolution(环境演进) • Environment Overfitting(环境过拟合) • Meta-improvement(元改进) • Human–AI Co-evolution(人机共同演进) • Open-ended Recursive Self-improvement(开放式递归自我改进)
5.19 2~3 分钟标准面试回答
如果面试官问:
“你怎么理解生产 Agent 的可演进性?”
可以回答:
Agent Evolvability 不只是上线后持续改 Prompt,我会把它理解成一套完整的 Production Learning System(生产学习系统)。
Agent 上线以后,用户行为、知识、业务规则、Tool 和 Model 都会持续变化,所以今天表现很好并不意味着未来仍然可靠。真正可演进的系统,需要持续从 Production Trace、用户反馈、专家纠正、业务结果和 Online Eval 中发现有价值的 Signal,再通过去重、聚类和 Prioritization,把它们转化成可复现的 Dataset、Regression Case、Evaluator、Skill 等 Learning Asset。
我会区分 Runtime Adaptation 和 Evolution:一次任务里 Reflection、Replan、Retry 成功,只代表当前任务适应;只有经验被持久化,并且未来能被正确 Retrieval、Activation、Application 和 Generalization,才真正形成长期能力。
发现 Failure 后,我不会默认问题在 Prompt,而会从 Product、Data、Prompt、Context、Tool、Skill、Workflow、Harness、Model、Memory 一直到 Evaluator / Environment 建立 Root Cause Hypothesis。如果根因不确定,会先做 Diagnostic Experiment;确定根因后再遵循 Smallest Effective Change,优先选择影响范围较小、容易验证和回滚但足够解决问题的改动。
Candidate 进入 Experiment 后,需要固定 Agent、Prompt、Model、Tool、Skill、Dataset、Evaluator、Configuration 等版本,保证实验可复现。由于 Agent 具有 Non-determinism,不能只跑一次,还要看 Multiple Trials、成功率、方差和不同 Segment 的表现。同时要防止 Goodhart’s Law、Eval Overfitting 和 Evaluation Awareness,避免系统只学会优化 Judge Score。
长期演进还存在 Stability–Plasticity Trade-off:系统既要吸收新能力,也不能破坏已经成熟的旧能力。因此 Candidate 不能因为修好一个 Bad Case 就接受,而要看 Broader Regression 和整体 Net Improvement。Skill 也一样,需要做 Differential Validation,比较 Repairs 和 Regressions,而不是假设 Skill 越多越好。
离线验证通过以后仍然不能直接上线,而应该经过 Regression、Historical Replay、必要的 Deployment Simulation、Shadow、Canary 和 A/B,再结合 Quality、Safety、Reliability、Performance、Cost 等 Guardrail 决定是否全量。如果是 Multi-Agent 或 Stateful Agent,还要处理 Contract Compatibility、Version Lineage 和 State / Memory / Data Migration,因为 Code Rollback 不代表系统状态真的恢复。
对于 Self-improvement,我认为企业当前最合理的是 Bounded Self-improvement:Agent 可以高度自动化地发现问题、提出 Candidate 和运行 Experiment,但 Objective、Interaction / Tool Boundary、Data Boundary、Resource Budget,以及 Independent Evaluation 和 Deployment Gate 必须由外部约束。Optimizer 越强可以减少流程脚手架,但这些边界不能消失。
所以生产级 Agent Evolvability 的本质是:
持续把生产中的新失败、新变化和新能力机会转成可复用工程资产,在保持旧能力稳定的前提下吸收新能力,通过可信验证和受控发布形成长期能力复利。
5.20 Quick Recall(快速回忆)
一条主线:
发现变化 → 资产化 → 诊断根因 → 最小有效改动 → 独立验证 → 受控发布 → 生产验证 → 能力复利
两个时间尺度:
Fast Loop:解决当前任务。 Slow Loop:改变未来默认能力。
三个演进机理:
Substrate(演进载体)
- Consolidation(能力固化)
- Selection(选择机制)
Consolidation 四步:
Persist → Retrieve / Activate → Apply → Generalize
一个长期核心权衡:
Stability(稳定性) ↔ Plasticity(可塑性)
三类演进触发:
Failure-driven Change-driven Opportunity-driven
两类演进方式:
Non-parametric Evolution(非参数演进)
Prompt / Context / Tool / Skill / Workflow / Harness / Memory
Parametric Evolution(参数演进)
Fine-tuning / Preference Optimization / RL
三层能力复利:
Agent → Platform → Organization
六条原则:
把生产信号转成永久资产 修 Failure Mode,不只修 Example 优先最小有效改动 改进者与裁判保持必要独立 演进越自动,独立验证越重要 最终形成能力复利