可观测性 - 如何看清 Agent 的生产行为?
一、第一性问题
1.1 什么是 Agent Observability(Agent 可观测性)?
Observability(可观测性)解决的核心问题是:
Agent 在生产环境里执行以后,我们能不能基于系统留下的 Telemetry(遥测数据),完整重建“发生了什么、为什么发生、问题发生在哪一步、影响范围有多大”。
传统 Backend(后端服务)的执行路径通常主要由代码提前确定。
Agent(智能体)则不同。
用户往往只给一个 Goal(目标),后面的很多执行路径由 Agent(智能体)在 Runtime(运行时)动态决定:
User Goal(用户目标)
↓
Intent / Context(意图 / 上下文)
↓
Planning(规划)
↓
LLM Call(大语言模型调用)
↓
Tool Selection(工具选择)
↓
Tool Arguments(工具参数)
↓
Tool Result(工具结果)
↓
Replanning(重新规划)
↓
State / Memory(状态 / 记忆)
↓
Handoff(任务移交)
↓
Another Agent(其他智能体)
↓
Final Response(最终响应)
逐项注释(16)
- User Goal
- 用户目标:用户真正希望系统完成的业务结果。
- Intent
- Intent:意图。
- Context
- Context:上下文。
- Planning
- Planning:规划。
- LLM
- LLM:大型语言模型。
- Call
- Call:调用。
- Tool Selection
- 工具选择:判断当前步骤应调用哪个工具。
- Tool Arguments
- 工具参数:传给工具执行的结构化输入。
- Tool Result
- 工具结果:外部工具执行后返回的输出。
- Replanning
- Replanning:重新规划。
- State
- State:状态。
- Memory
- Memory:记忆。
- Handoff
- Handoff:移交。
- Another
- Another:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Agent
- Agent:智能体。
- Final Response
- 最终响应:系统完成任务后返回给用户的可见回复。
其中任何一步都可能产生问题。
更关键的是:
Agent Failure(智能体失败)不一定表现为传统系统 Error(错误)。
例如:
HTTP 200(HTTP 请求成功)
Tool API 200(工具接口请求成功)
LLM API 200(大语言模型接口请求成功)
逐项注释(4)
- HTTP
- HTTP:超文本传输协议。
- Tool
- Tool:工具。
- API
- API:应用程序编程接口。
- LLM
- LLM:大型语言模型。
从传统系统角度看:
一切正常。
但实际 Agent(智能体)可能已经:
- 选择了错误的 Tool(工具)
- 生成了错误 SQL(结构化查询语言)
- Retrieval(检索)到了错误资料
- 错误理解了 Tool Result(工具结果)
- 出现 Agent Loop(智能体循环)
- Handoff(任务移交)给了错误 Agent(智能体)
- State(状态)被污染
- Final Answer(最终答案)事实错误
传统 APM(Application Performance Monitoring,应用性能监控)可能认为:
系统健康。
但 Agent(智能体)已经发生业务失败。
因此,生产级 Agent Observability(Agent 可观测性)不能简单理解成:
“把日志打全。”
更准确的定义是:
把 Agent(智能体)的每一次行为转化成可重建、可关联、可度量、可诊断、并且最终可以采取行动的生产证据。
记忆点:
Observability(可观测性)的核心不是记录更多,而是出了任何问题之后,都有足够证据把事情完整还原出来。
1.2 Observability(可观测性)和 Monitoring(监控)有什么区别?
Monitoring(监控)更关注:
持续观察我们提前已经知道的问题。
例如:
- Error Rate(错误率)超过 5%
- P95 Latency(P95 延迟)超过 10 秒
- Tool 429 Rate(工具限流率)超过 3%
- Cost per Task(单任务成本)超过阈值
也就是说:
你已经知道自己想观察什么。
Observability(可观测性)更强调:
当一个事先没有预定义的问题发生时,系统是不是留下了足够的数据,让我们仍然可以推断系统内部发生了什么。
例如用户反馈:
“昨天 14:32,这个 Data Agent(数据智能体)给我的 GMV(商品交易总额)数字错了。”
你很可能没有提前建设一个:
“GMV(商品交易总额)回答错误 Dashboard(看板)”。
真正需要的是:
user_id(用户 ID)
↓
business_task_id(业务任务 ID)
↓
session_id(会话 ID)
↓
trace_id(追踪 ID)
↓
span_id(执行片段 ID)
↓
Tool Arguments(工具参数)
↓
Tool Result(工具结果)
↓
Agent Decision(智能体决策)
逐项注释(10)
- user_id
- user_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- ID
- ID:唯一标识符。
- business_task_id
- business_task_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- session_id
- session_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- trace_id
- trace_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- span_id
- span_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Tool Arguments
- 工具参数:传给工具执行的结构化输入。
- Tool Result
- 工具结果:外部工具执行后返回的输出。
- Agent
- Agent:智能体。
- Decision
- Decision:决策。
然后逐层还原事实。
所以:
Monitoring(监控)是 Observability(可观测性)的一种具体使用方式,但 Observability(可观测性)不等于 Monitoring(监控)。
1.3 Observability(可观测性)和 Evaluation(评测)有什么区别?
这一题必须和 Quality(质量)模块切清楚。
Observability(可观测性)
回答:
发生了什么?
它提供的是:
Evidence(证据)。
例如:
- Agent(智能体)调用了哪个 Tool(工具)
- Tool Arguments(工具参数)是什么
- Tool Result(工具结果)是什么
- 使用了哪个 Model(模型)
- 消耗多少 Token(模型计算单位)
- 发生了几次 Handoff(任务移交)
Evaluation(评测)
回答:
这样做到底好不好、对不对?
它提供:
Judgment(判断)。
例如:
- Tool Selection Score(工具选择得分)为 0
- Correctness(正确性)为 0.4
- Trajectory Score(执行轨迹得分)为 0.6
所以可以记:
Observability(可观测性)提供 Evidence(证据),Evaluation(评测)提供 Judgment(判断)。
生产系统里二者会连接:
Trace(执行追踪)
↓
Evaluator(评测器)
↓
Score(评测得分)
↓
Monitoring / Alert(监控 / 告警)
↓
Bad Case(坏案例)
逐项注释(6)
- Trace
- Trace:调用轨迹。
- Evaluator
- Evaluator:评估器。
- Score
- Score:分数。
- Monitoring
- Monitoring:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Alert
- Alert:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Bad Case
- 失败样本:线上或评测中表现不符合预期的具体案例。
但本章只讨论:
Eval Score(评测得分)如何作为一种 Semantic Signal(语义信号)被 Observability(可观测系统)消费。
至于:
- Rubric(评测标准)
- Judge Calibration(评测器校准)
- Gold Set(黄金数据集)
- Eval Leakage(评测泄漏)
仍然属于 Quality(质量)模块。
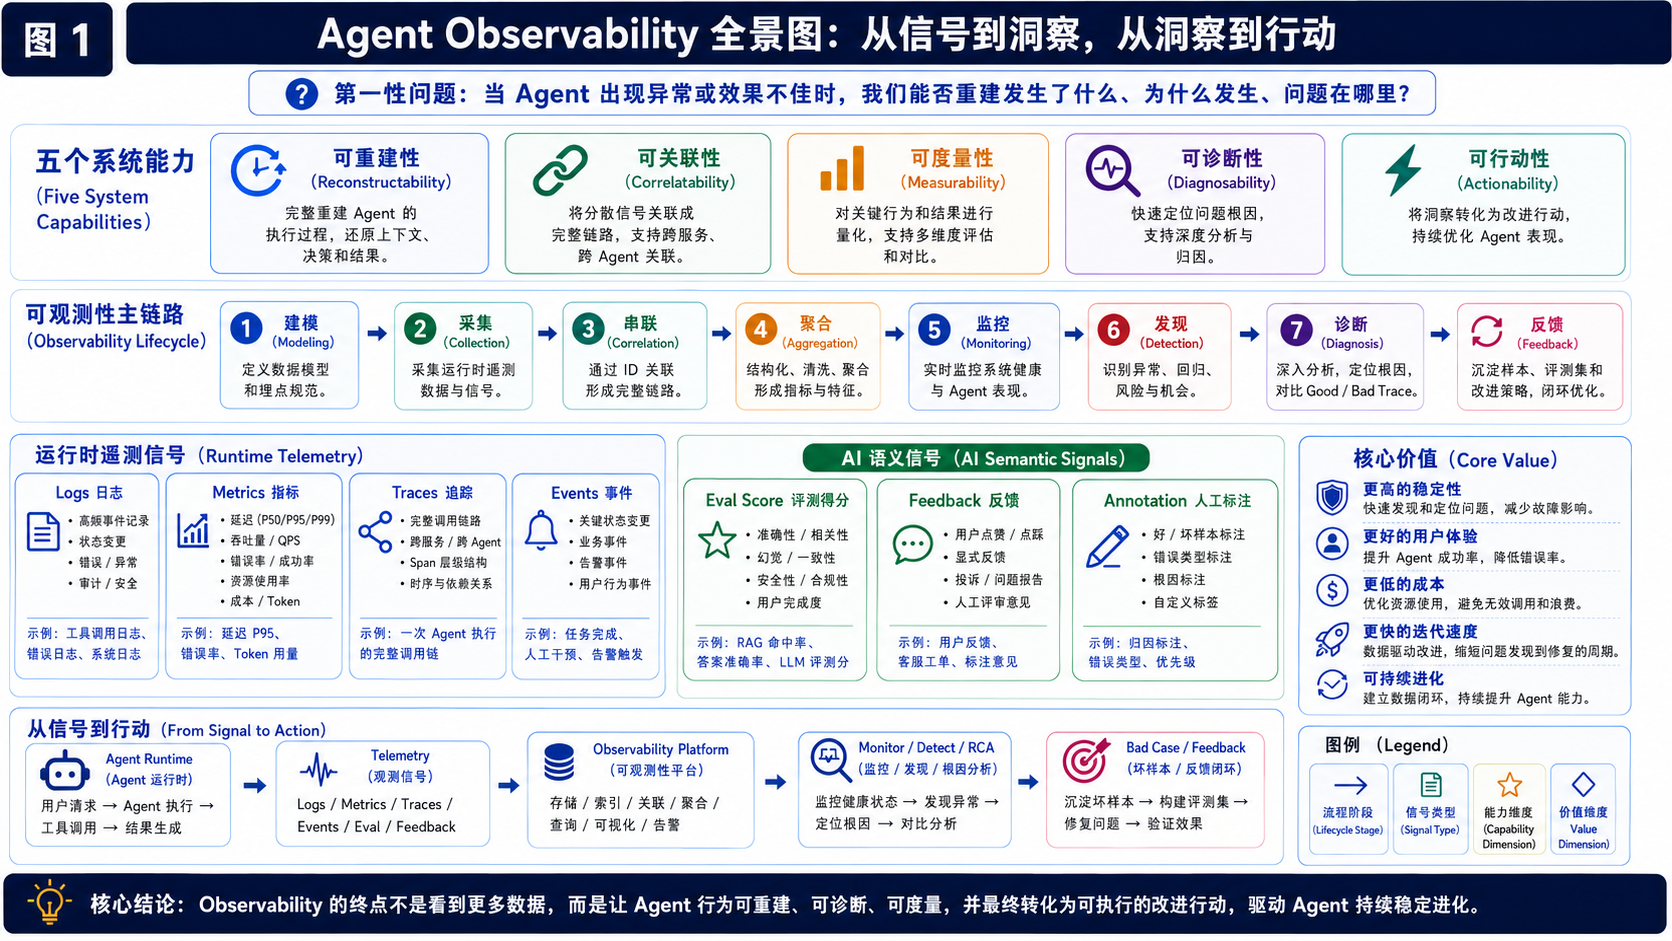
1.4 Agent Observability(Agent 可观测性)的核心模型是什么?
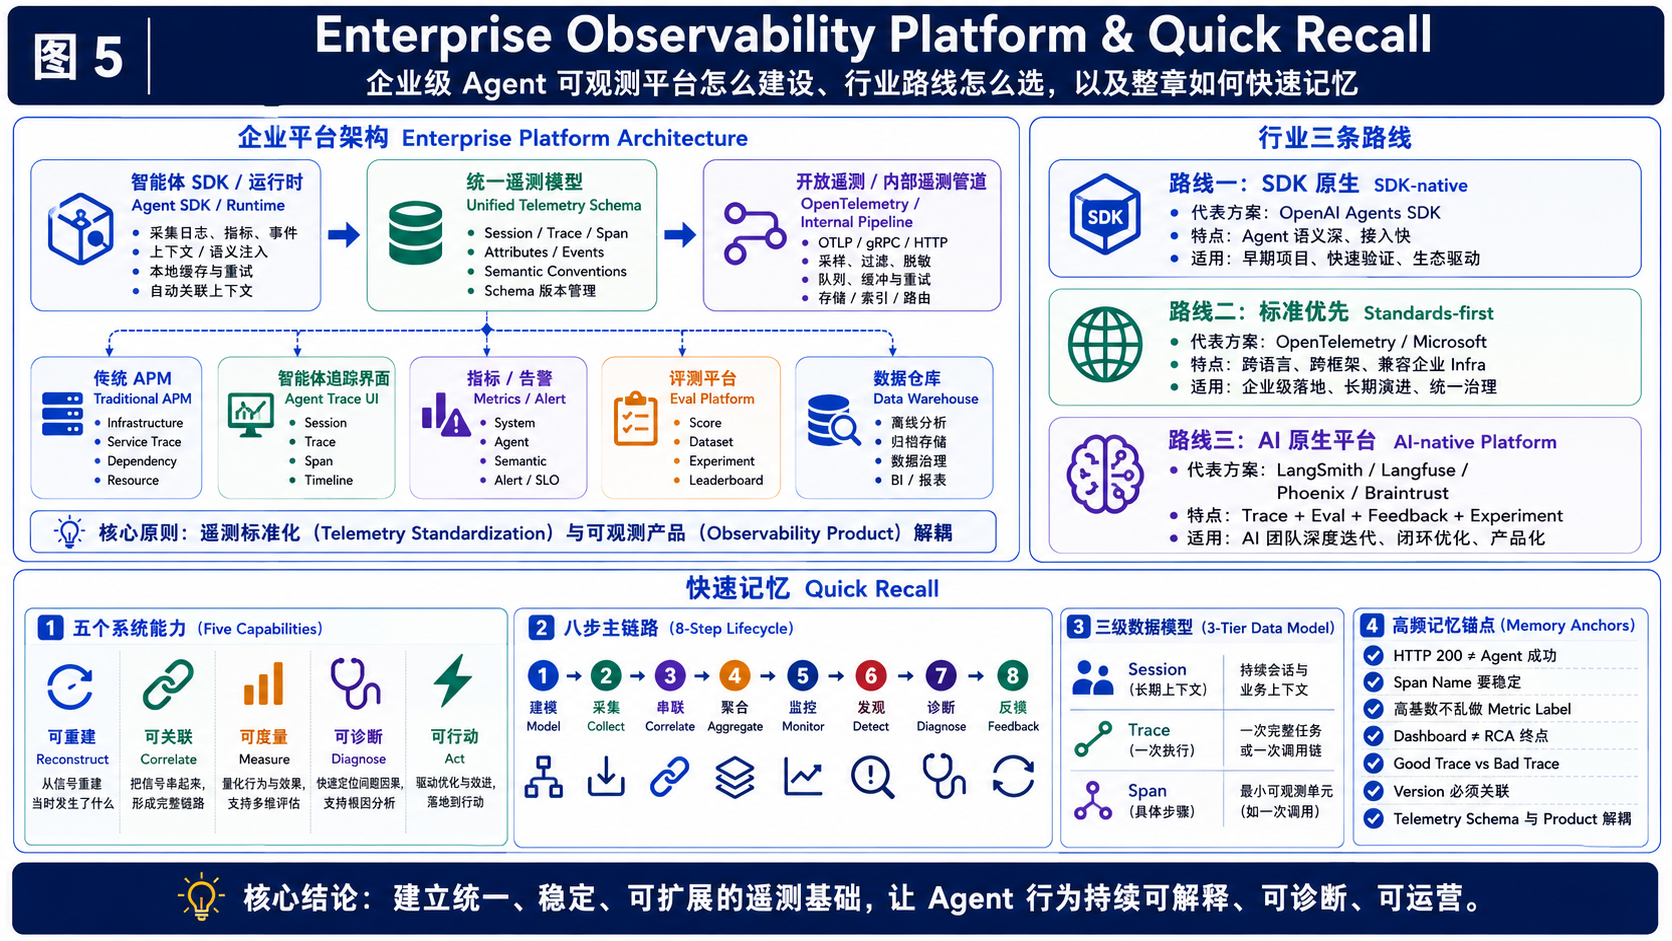
我建议把生产级 Agent Observability(Agent 可观测性)抽象成五个系统能力:
Reconstructability(可重建性) Correlatability(可关联性) Measurability(可度量性) Diagnosability(可诊断性) Actionability(可行动性)
Reconstructability(可重建性)
回答:
一次 Agent Run(智能体执行)到底经历了什么?
Correlatability(可关联性)
回答:
不同 Agent(智能体)、Worker(工作进程)、Tool(工具)、时间段产生的数据,能不能串回同一个业务任务?
Measurability(可度量性)
回答:
单次 Trace(追踪)能不能进一步聚合成系统级 Metrics(指标)?
Diagnosability(可诊断性)
回答:
出现问题以后,能不能找到 First Divergence(第一处偏离点)和 Root Cause(根因)?
Actionability(可行动性)
回答:
发现问题以后,能不能进一步触发 Alert(告警)、Bad Case(坏案例)、Evaluation(评测)、Fix(修复)和 Regression(回归验证)?
因此:
Agent Observability(Agent 可观测性) = 可重建 + 可关联 + 可度量 + 可诊断 + 可行动
1.5 Agent Observability(Agent 可观测性)的主链路是什么?
整个模块沿着下面这条生产链理解:
Model(建模)
↓
Instrument(采集 / 埋点)
↓
Correlate(关联)
↓
Aggregate(聚合)
↓
Monitor(监控)
↓
Detect(异常发现)
↓
Diagnose(诊断)
↓
Feedback(反馈)
逐项注释(8)
- Model
- Model:模型。
- Instrument
- Instrument:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Correlate
- Correlate:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Aggregate
- Aggregate:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Monitor
- Monitor:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Detect
- Detect:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Diagnose
- Diagnose:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Feedback
- Feedback:反馈。
中文压缩:
建模 → 采集 → 串联 → 聚合 → 监控 → 发现 → 诊断 → 反馈
为什么第一步是:
建模?
因为如果一开始:
- Session(会话)边界设计错误
- Trace(追踪)边界设计错误
- Span(执行片段)粒度设计错误
- Span Name(执行片段名称)不稳定
- Business ID(业务 ID)没有建立关联
那么即使数据大量采集:
真正出现线上问题时依然可能无法定位。
1.6 阶段总结
Observability(可观测性)的第一性问题不是:
我们有没有日志平台?
而是:
生产环境中出现任何 Agent(智能体)异常时,我们有没有能力完整重建执行过程,并最终解释为什么。
二、Telemetry(遥测)基础理论
2.1 Logs(日志)、Metrics(指标)、Traces(追踪)、Events(事件)有什么区别?
这是基础面试题。
| Signal(遥测信号) | 核心问题 | Agent(智能体)示例 |
|---|---|---|
| Logs(日志) | 某个具体事件发生了什么? | Tool(工具)调用失败,错误码为 429 |
| Metrics(指标) | 某类行为整体发生得怎么样? | Tool Error Rate(工具错误率)为 3% |
| Traces(追踪) | 一次完整任务经历了什么? | Agent(智能体)→ Model(模型)→ Tool(工具)→ Model(模型) |
| Events(事件) | 某一时间点发生了什么事实? | Handoff triggered(触发任务移交) |
这四种信号不是:
四选一。
而是:
互补的 Telemetry Signals(遥测信号)。
2.2 Span(执行片段)和 Event(事件)有什么区别?
Span(执行片段)更适合:
有开始时间、结束时间以及 Duration(持续时间)的 Operation(操作)。
例如:
execute_sql(执行 SQL)
start_time(开始时间)
↓
SQL Execution(SQL 执行过程)
↓
end_time(结束时间)
逐项注释(5)
- execute_sql
- 函数或工具名:执行传入的 SQL 语句。
- SQL
- SQL:结构化查询语言。
- start_time
- start_time:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Execution
- Execution:执行。
- end_time
- end_time:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
Event(事件)更适合:
某一个时间点发生的离散事实。
例如:
retry_triggered(触发重试)
approval_received(收到审批)
handoff_triggered(触发任务移交)
budget_exhausted(预算耗尽)
逐项注释(4)
- retry_triggered
- retry_triggered:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- approval_received
- approval_received:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- handoff_triggered
- handoff_triggered:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- budget_exhausted
- budget_exhausted:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
所以:
有生命周期的操作适合用 Span(执行片段)。
瞬时事实适合用 Event(事件)。
2.3 为什么 Agent(智能体)还需要 AI Semantic Signal(AI 语义信号)?
传统 Telemetry(遥测)可能显示:
status(执行状态) = success(成功)
latency(延迟) = 3 seconds(3 秒)
error(系统错误) = false(无系统错误)
逐项注释(6)
- status
- status:状态。
- success
- success:成功。
- latency
- latency:延迟。
- seconds
- seconds:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- error
- error:错误。
- false
- false:错误的或假阳性的。
但是:
这些并不能告诉你最终答案是否正确。
所以 Agent Observability(Agent 可观测性)通常还需要:
AI Semantic Signals(AI 语义信号)
例如:
- Online Eval Score(在线评测得分)
- User Feedback(用户反馈)
- Human Annotation(人工标注)
- Task Success(任务成功率)
- Escalation Rate(升级 / 转人工率)
但要注意:
这些只是 Observability(可观测性)消费的信号。
至于:
Score(得分)具体如何产生,
仍然属于 Quality(质量)。
2.4 阶段总结
传统 Observability(可观测性)更多回答:
系统有没有正常运行?
Agent Observability(Agent 可观测性)进一步要回答:
Agent(智能体)有没有以异常方式运行,以及这些异常是否正在影响真实业务结果。
三、Session(会话)、Trace(追踪)与 Span(执行片段)
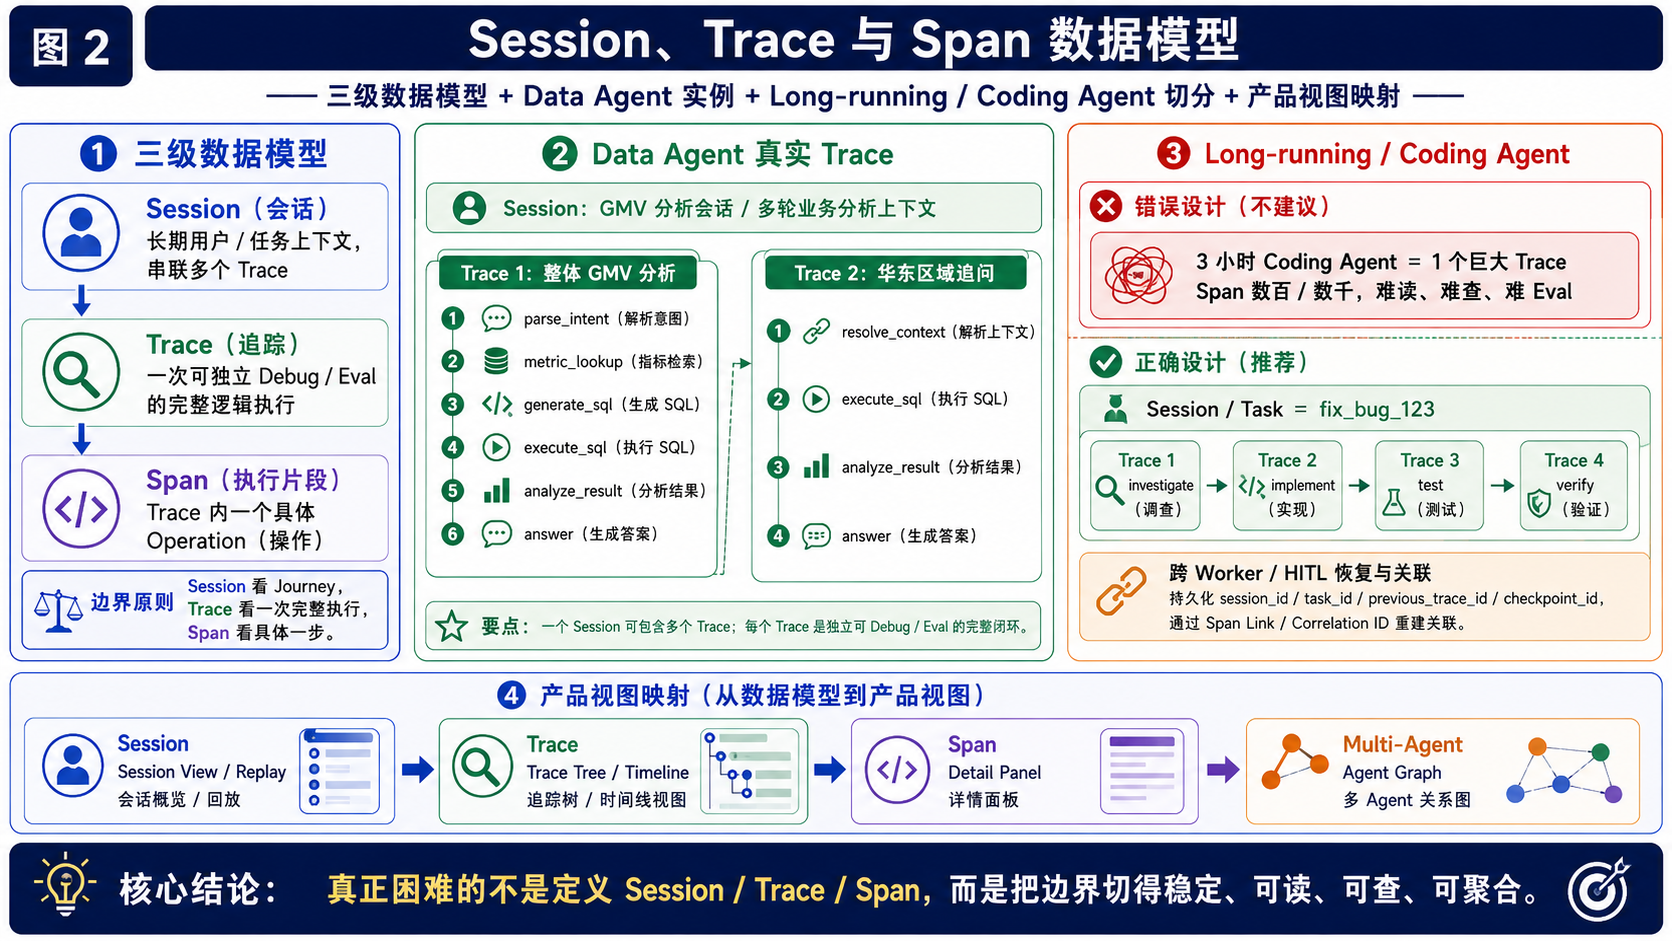
3.1 Session(会话)、Trace(追踪)、Span(执行片段)分别是什么?
最重要的基础记忆:
Session(会话) = 长期业务上下文
Trace(追踪) = 一次完整逻辑执行
Span(执行片段) = 一次完整执行中的一个具体步骤
Session(会话 / 任务上下文)
Session(会话)解决:
哪些 Trace(追踪)属于同一段长期交互?
例如企业客服 Agent(智能体):
Session(会话): customer_case_123(客户案例 123)

├─ Trace 1(第 1 次完整执行)
│  用户:为什么重复扣费?
│
├─ Trace 2(第 2 次完整执行)
│  用户:帮我退掉重复的一笔
│
└─ Trace 3(第 3 次完整执行)
   用户:退款多久到账?
逐项注释(3)
- Session
- Session:会话。
- customer_case_123
- customer_case_123:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Trace
- Trace:调用轨迹。
有了 Session(会话),可以分析:
- 整个问题经历多少轮才解决
- Agent(智能体)是否遗忘前文
- Session Total Token(会话总 Token)
- Session Total Cost(会话总成本)
- 是否发生 Handoff(任务移交)
- Resolution Status(问题解决状态)
一句话:
Session(会话)看完整用户 / 业务 Journey(交互旅程)。
Trace(追踪)
Trace(追踪)表示:
一个自包含、可以独立 Debug(调试 / 排障)、Evaluation(评测)和归因的逻辑执行单元。
例如 Data Agent(数据智能体):
Trace(追踪): diagnose_gmv_drop(诊断 GMV 下跌)

User Query(用户问题)
↓
Intent Parse(意图解析)
↓
Metric Retrieval(指标检索)
↓
SQL Generation(SQL 生成)
↓
SQL Execution(SQL 执行)
↓
Result Analysis(结果分析)
↓
Final Answer(最终回答)
逐项注释(14)
- Trace
- Trace:调用轨迹。
- diagnose_gmv_drop
- diagnose_gmv_drop:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- GMV
- GMV:商品交易总额。
- User
- User:用户。
- Query
- Query:查询。
- Intent
- Intent:意图。
- Parse
- Parse:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Metric Retrieval
- 指标检索:找到任务需要使用的指标定义。
- SQL
- SQL:结构化查询语言。
- Generation
- Generation:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Execution
- Execution:执行。
- Result
- Result:结果。
- Analysis
- Analysis:分析。
- Final Answer
- 最终答案:智能体完成执行后呈现给用户的最终输出。
一句话:
Trace(追踪)看一次完整执行。
Span(执行片段)
Span(执行片段)表示 Trace(追踪)中的某个具体 Operation(操作)。
例如:
Trace(完整追踪): Data Agent Run(数据智能体执行)

├─ Span(执行片段): parse_intent(解析意图)
├─ Span(执行片段): retrieve_metric(检索指标)
├─ Span(执行片段): generate_sql(生成 SQL)
├─ Span(执行片段): execute_sql(执行 SQL)
└─ Span(执行片段): generate_answer(生成答案)
逐项注释(11)
- Trace
- Trace:调用轨迹。
- Data
- Data:数据。
- Agent
- Agent:智能体。
- Run
- Run:单次运行。
- Span
- Span:调用链中的操作区间。
- parse_intent
- parse_intent:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- retrieve_metric
- retrieve_metric:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- generate_sql
- generate_sql:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- SQL
- SQL:结构化查询语言。
- execute_sql
- 函数或工具名:执行传入的 SQL 语句。
- generate_answer
- generate_answer:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
一句话:
Span(执行片段)看具体一步发生了什么。
3.2 Session(会话)、Trace(追踪)、Span(执行片段)怎么落到真实 Telemetry Schema(遥测数据模型)?
例如 Data Agent(数据智能体)的一个 Tool Span(工具执行片段):
session_id(会话 ID) = analysis_123(分析会话 123)
trace_id(追踪 ID) = trace_456(追踪 456)
span_id(执行片段 ID) = span_789(执行片段 789)
parent_span_id(父执行片段 ID) = span_001(父执行片段 001)

task_id(业务任务 ID) = gmv_drop_analysis(GMV 下跌分析任务)

agent_name(智能体名称) = data_agent(数据智能体)
agent_version(智能体版本) = v2.7(版本 2.7)

operation_type(操作类型) = tool(工具操作)
operation_name(操作名称) = execute_sql(执行 SQL)

resource(访问资源) = analytics_database(分析数据库)
status(执行状态) = success(成功)
latency_ms(延迟毫秒数) = 1820(1820 毫秒)

prompt_version(Prompt 版本) = p31(Prompt 版本 31)
tool_version(工具版本) = sql_v4(SQL 工具版本 4)
逐项注释(31)
- session_id
- session_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- ID
- ID:唯一标识符。
- analysis_123
- analysis_123:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- trace_id
- trace_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- trace_456
- trace_456:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- span_id
- span_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- span_789
- span_789:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- parent_span_id
- parent_span_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- span_001
- span_001:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- task_id
- 字段或变量名:任务的唯一标识。
- gmv_drop_analysis
- gmv_drop_analysis:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- GMV
- GMV:商品交易总额。
- agent_name
- agent_name:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- data_agent
- data_agent:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- agent_version
- 字段名:智能体版本。
- v2
- v2:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- operation_type
- operation_type:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- tool
- tool:工具。
- operation_name
- operation_name:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- execute_sql
- 函数或工具名:执行传入的 SQL 语句。
- SQL
- SQL:结构化查询语言。
- resource
- resource:资源。
- analytics_database
- analytics_database:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- status
- status:状态。
- success
- success:成功。
- latency_ms
- latency_ms:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- prompt_version
- 字段名:提示词版本。
- Prompt
- Prompt:提示词。
- p31
- p31:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- tool_version
- 字段名:工具版本。
- sql_v4
- sql_v4:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
重点不在于背字段。
重点在于:
Session(会话)、Trace(追踪)、Span(执行片段)、Business ID(业务 ID)、Agent Version(智能体版本)、Prompt Version(提示词版本)最终都必须变成可查询、可过滤、可关联的数据。
3.3 一个 Trace(追踪)应该多大?
可以记住一个很重要的原则:
一个能够独立 Debug(调试)、Evaluation(评测)和归因的逻辑执行单元,通常适合作为一个 Trace(追踪)。
典型错误:
一个完整 Conversation(对话)全塞进一个巨大 Trace(追踪)。
例如:
Trace(巨大追踪)
├─ Turn 1(第 1 轮对话)
├─ Turn 2(第 2 轮对话)
├─ Turn 3(第 3 轮对话)
├─ ...
└─ Turn 100(第 100 轮对话)
逐项注释(2)
- Trace
- Trace:调用轨迹。
- Turn
- Turn:轮次。
结果:
- Trace Tree(追踪树)巨大
- 单轮 Debug(调试)困难
- UI(用户界面)导航困难
- Evaluation(评测)难挂载
- Payload(业务负载)巨大
- 查询性能下降
因此 Chat Agent(对话智能体)通常更适合:
一个 Turn(对话轮次)一个 Trace(追踪)。
整个 Conversation(对话)由 Session(会话)进行关联。
3.4 Data Agent(数据智能体)应该怎么切 Trace(追踪)?
用户第一次问:
最近 30 天 GMV 为什么下降?
随后追问:
华东地区呢?
可以设计:
Session(分析会话): analysis_session_123(分析会话 123)

├─ Trace 1(第 1 次完整执行): overall_gmv_analysis(整体 GMV 分析)
│  ├─ parse_intent(解析意图)
│  ├─ metric_lookup(指标检索)
│  ├─ generate_sql(生成 SQL)
│  ├─ execute_sql(执行 SQL)
│  └─ answer(生成答案)
│
└─ Trace 2(第 2 次完整执行): east_china_followup(华东区域追问)
   ├─ resolve_context(解析上下文)
   ├─ execute_sql(执行 SQL)
   └─ answer(生成答案)
逐项注释(13)
- Session
- Session:会话。
- analysis_session_123
- analysis_session_123:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Trace
- Trace:调用轨迹。
- overall_gmv_analysis
- overall_gmv_analysis:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- GMV
- GMV:商品交易总额。
- parse_intent
- parse_intent:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- metric_lookup
- 函数或步骤名:查询指标定义。
- generate_sql
- generate_sql:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- SQL
- SQL:结构化查询语言。
- execute_sql
- 函数或工具名:执行传入的 SQL 语句。
- answer
- answer:答案。
- east_china_followup
- east_china_followup:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- resolve_context
- resolve_context:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
这样同时支持:
- 单轮排障
- 多轮上下文分析
- Session Cost Analysis(会话成本分析)
- User Journey Analysis(用户交互旅程分析)
3.5 Coding Agent(代码智能体)应该怎么切 Trace(追踪)?
Coding Agent(代码智能体)的一个真实常见坑:
长任务全部塞进一个巨大 Trace。
例如复杂 Bug(程序缺陷)修复:
Read Repo(读取代码仓库)
→ Search(搜索代码)
→ Edit(修改代码)
→ Test(执行测试)
→ Edit(再次修改)
→ Test(再次测试)
→ Shell(执行终端命令)
→ ...
逐项注释(6)
- Read
- Read:读取。
- Repo
- Repo:代码仓库。
- Search
- Search:搜索。
- Edit
- Edit:编辑。
- Test
- Test:测试。
- Shell
- Shell:确定性控制外壳。
如果运行几个小时,最终可能出现数百甚至数千个 Span(执行片段)。
更合理:
Session / Task(会话 / 任务): fix_bug_123(修复 Bug 123)

├─ Trace 1(追踪 1): investigate(问题调查)
├─ Trace 2(追踪 2): implement_patch(实现补丁)
├─ Trace 3(追踪 3): test_and_diagnose(测试和诊断)
└─ Trace 4(追踪 4): final_verify(最终验证)
逐项注释(9)
- Session
- Session:会话。
- Task
- Task:任务。
- fix_bug_123
- fix_bug_123:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Bug
- Bug:软件缺陷。
- Trace
- Trace:调用轨迹。
- investigate
- investigate:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- implement_patch
- implement_patch:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- test_and_diagnose
- test_and_diagnose:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- final_verify
- final_verify:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
然后通过:
- task_id(任务 ID)
- session_id(会话 ID)
- repo_id(代码仓库 ID)
统一关联。
生产经验:
Long-running Task(长时间任务)不等于一个巨大 Trace(追踪)。
3.6 Long-running Agent(长时间运行智能体)怎么做跨时间关联?
例如:
Day 1(第 1 天)
Agent Run(智能体执行)
↓
Approval Required(需要人工审批)
↓
Pause(暂停)

Day 2(第 2 天)
Another Worker(另一工作进程)
↓
Resume(恢复执行)
逐项注释(9)
- Day
- Day:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Agent
- Agent:智能体。
- Run
- Run:单次运行。
- Approval
- Approval:审批。
- Required
- Required:必填或强制。
- Pause
- Pause:暂停。
- Another
- Another:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Worker
- Worker:执行子智能体。
- Resume
- Resume:恢复。
这种情况不能只依赖:
进程内 Trace Context(追踪上下文)。
需要持久化:
- task_id(任务 ID)
- session_id(会话 ID)
- previous_trace_id(前序追踪 ID)
- checkpoint_id(检查点 ID)
- business_id(业务 ID)
- resume_from(恢复位置)
可以设计成:
Session / Task(长期会话 / 任务)

├─ Trace 1(追踪 1)
│  pre_approval_execution(审批前执行)
│
└─ Trace 2(追踪 2)
   post_approval_resume(审批后恢复)
逐项注释(5)
- Session
- Session:会话。
- Task
- Task:任务。
- Trace
- Trace:调用轨迹。
- pre_approval_execution
- pre_approval_execution:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- post_approval_resume
- post_approval_resume:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
两次 Trace(追踪)通过:
Session ID(会话 ID)、Task ID(任务 ID)或者 Span Link(执行片段链接)
进行关联。
通常没有必要强行做一个:
持续几十个小时的巨大 Trace(追踪)。
3.7 Parent-child(父子关系)和 Span Link(执行片段链接)怎么选?
Parent-child(父子 Span 关系)更适合:
明确的嵌套执行生命周期。
Agent(智能体)系统还常见:
- Async Tool(异步工具)
- Queue(任务队列)
- Background Job(后台任务)
- Parallel Calls(并行调用)
- Retry(重试)
- Handoff(任务移交)
- Resume(恢复执行)
例如:
Agent(智能体)
↓
Queue(任务队列)
↓
Worker after 5 min(5 分钟后的工作进程)
逐项注释(5)
- Agent
- Agent:智能体。
- Queue
- Queue:队列。
- Worker
- Worker:执行子智能体。
- after
- after:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- min
- min:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
这里并不是严格同步嵌套关系。
可以通过:
- Span Link(执行片段链接)
- Correlation ID(关联 ID)
- Business ID(业务 ID)
表达:
有因果 / 业务关联,但不是严格父子生命周期。
3.8 阶段总结
Session(会话)、Trace(追踪)、Span(执行片段)不是三个简单 ID。
它们定义了三个不同观察尺度:
Session(会话)看长期 Journey(交互旅程)。
Trace(追踪)看一次完整执行。
Span(执行片段)看具体一步。
真正工程难点不是:
会背定义。
而是:
边界怎么切得稳定、可读、可查、可聚合。
四、Trace Schema(追踪模型)与产品设计
4.1 一个好的 Agent Trace(智能体追踪)应该长什么样?
好的 Trace Schema(追踪数据模型)不应该只是一条:
技术调用链。
而应该成为:
Agent(智能体)的可解释执行语言。
例如:
Trace(完整执行): answer_business_question(回答业务问题)

├─ Agent(智能体操作): understand_intent(理解意图)
├─ Retriever(检索操作): retrieve_metric_definition(检索指标定义)
├─ Tool(工具操作): schema_lookup(查询数据结构)
├─ Generation(模型生成): generate_sql(生成 SQL)
├─ Tool(工具操作): execute_sql(执行 SQL)
├─ Agent(智能体操作): analyze_result(分析结果)
└─ Generation(模型生成): generate_answer(生成答案)
逐项注释(14)
- Trace
- Trace:调用轨迹。
- answer_business_question
- answer_business_question:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Agent
- Agent:智能体。
- understand_intent
- understand_intent:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Retriever
- Retriever:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- retrieve_metric_definition
- retrieve_metric_definition:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Tool
- Tool:工具。
- schema_lookup
- 函数或步骤名:查询数据结构定义。
- Generation
- Generation:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- generate_sql
- generate_sql:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- SQL
- SQL:结构化查询语言。
- execute_sql
- 函数或工具名:执行传入的 SQL 语句。
- analyze_result
- analyze_result:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- generate_answer
- generate_answer:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
如果所有节点都只是:
Generic Span(通用执行片段)
人虽然能看到 Trace(追踪):
但读不懂 Agent(智能体)到底做了什么。
4.2 Span(执行片段)粒度怎么设计?
Span(执行片段)太粗:
agent_run(智能体整体执行) = 10 seconds(10 秒)逐项注释(2)
- agent_run
- agent_run:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- seconds
- seconds:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
无法知道:
哪一步慢、哪一步错。
Span(执行片段)太细:
JSON Parsing(JSON 解析)、Dictionary Lookup(字典查询)、Framework Internal Node(框架内部节点)全部变成 Span。
又会导致:
- 噪声过多
- 存储量增加
- UI(用户界面)难读
- Root Cause Analysis(根因分析)更复杂
适合作为 Span(执行片段)的 Operation(操作)一般满足:
有独立业务语义 + 有独立故障边界 + 有性能意义 + 有诊断价值
例如:
- Agent Turn(智能体执行轮次)
- Model Call(模型调用)
- Retrieval(检索)
- Tool Call(工具调用)
- Handoff(任务移交)
- State Transition(状态转换)
- Guardrail(护栏检查)
- Business Validation(业务校验)
4.3 Span Name(执行片段名称)怎么设计?
这是非常典型的生产踩坑。
错误:
span_name(执行片段名称) = gpt_5_call(GPT-5 调用)
span_name(执行片段名称) = model_x_v3_call(模型 X V3 调用)
span_name(执行片段名称) = retry_2(第 2 次重试)
逐项注释(7)
- span_name
- span_name:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- gpt_5_call
- gpt_5_call:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- GPT-5
- GPT-5:该纯文本块中的状态、决策或错误枚举值。
- model_x_v3_call
- model_x_v3_call:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- X
- X:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- V3
- V3:该纯文本块中的状态、决策或错误枚举值。
- retry_2
- retry_2:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
问题是:
模型、版本变化以后:
- Dashboard(看板)统计断裂
- Saved Filter(已保存过滤条件)失效
- Evaluator Selector(评测器筛选条件)失效
- Historical Comparison(历史对比)困难
更合理:
span_name(执行片段名称) = generate_answer(生成答案)
model(模型) = model_x(模型 X)
prompt_version(Prompt 版本) = v23(版本 23)
retry_count(重试次数) = 2(重试 2 次)
逐项注释(9)
- span_name
- span_name:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- generate_answer
- generate_answer:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- model
- model:模型。
- model_x
- model_x:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- X
- X:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- prompt_version
- 字段名:提示词版本。
- Prompt
- Prompt:提示词。
- v23
- v23:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- retry_count
- retry_count:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
所以:
Span Name(执行片段名称)应该像一个稳定 API(应用程序接口),而不是一次执行的动态描述。
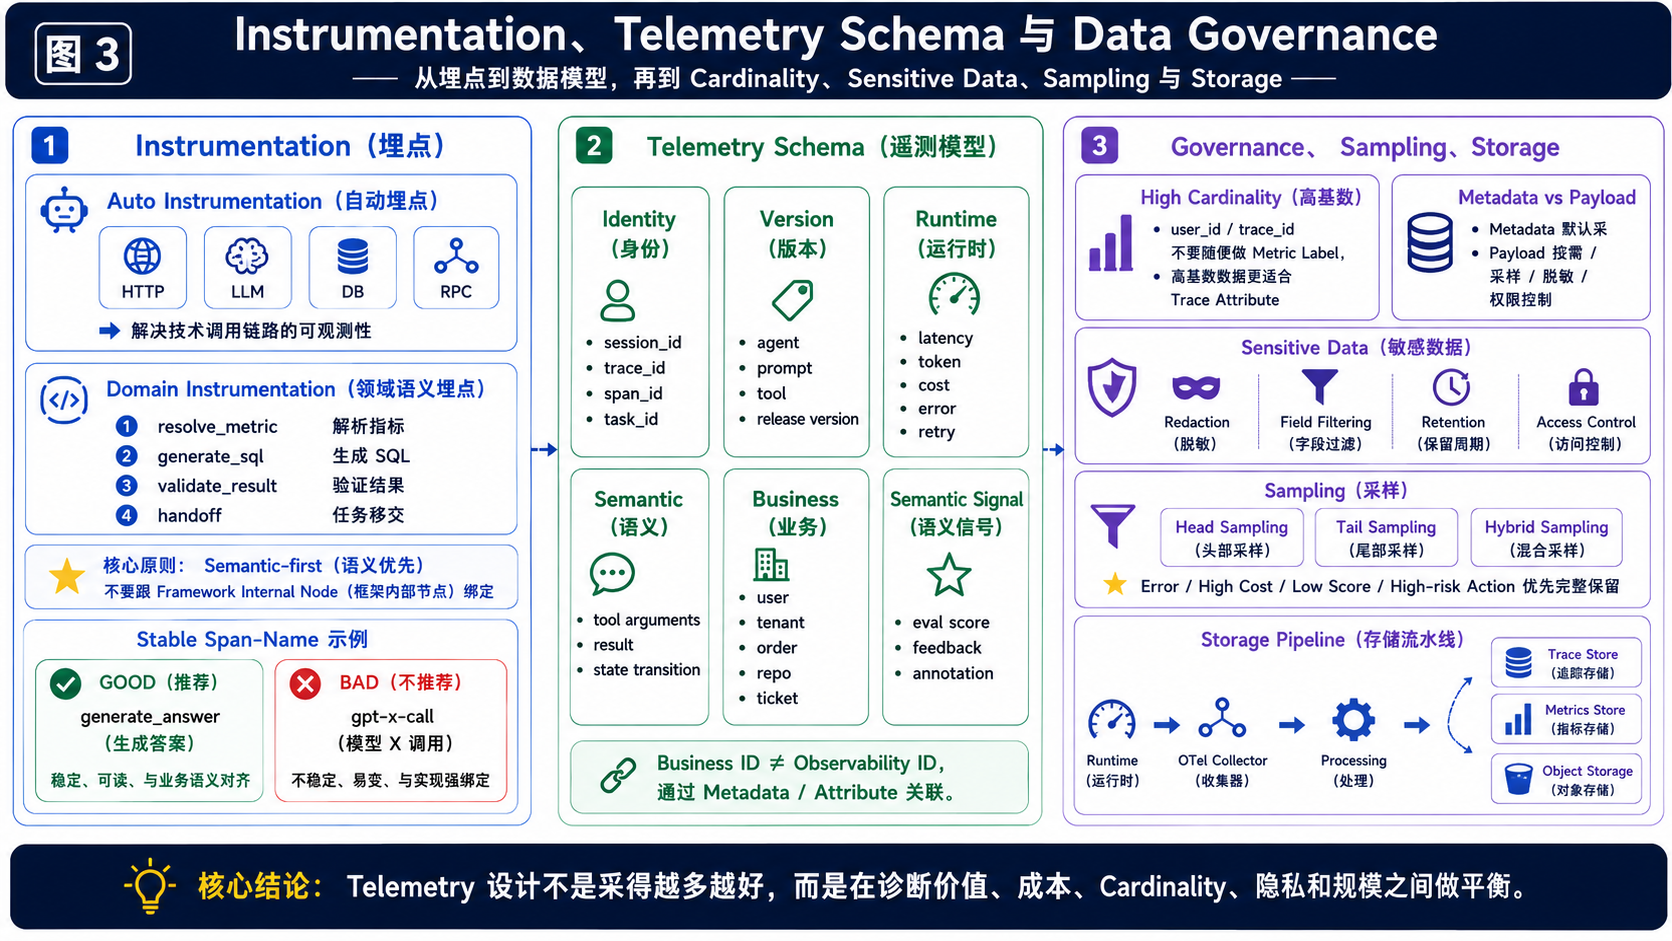
4.4 为什么 Instrumentation(埋点)应该 Semantic-first(语义优先)?
Instrumentation(埋点)不应该跟着 Framework(框架)的内部实现结构变化。
错误:
RunnableSequence(框架执行序列)
Node_3(框架节点 3)
ExecutorStep_4(执行器步骤 4)
逐项注释(3)
- RunnableSequence
- RunnableSequence:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Node_3
- Node_3:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- ExecutorStep_4
- ExecutorStep_4:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
如果以后换框架:
整个 Trace Schema(追踪模型)都会变化。
更稳定:
resolve_metric(解析指标)
generate_sql(生成 SQL)
execute_query(执行查询)
validate_result(验证结果)
generate_answer(生成答案)
逐项注释(6)
- resolve_metric
- resolve_metric:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- generate_sql
- generate_sql:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- SQL
- SQL:结构化查询语言。
- execute_query
- execute_query:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- validate_result
- validate_result:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- generate_answer
- generate_answer:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
所以:
Instrumentation should be semantic-first, not framework-first(埋点应该语义优先,而不是框架优先)。
4.5 为什么 Auto Instrumentation(自动埋点)不够?
Auto Instrumentation(自动埋点)通常可以看到:
- HTTP(超文本传输协议)调用
- Database(数据库)调用
- LLM(大语言模型)调用
- RPC(远程过程调用)
但是未必知道:
每一个步骤在业务语义上到底是什么。
例如:
generation_1(第 1 次模型生成)
tool_2(第 2 个工具调用)
span_3(第 3 个执行片段)
逐项注释(3)
- generation_1
- generation_1:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- tool_2
- tool_2:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- span_3
- span_3:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
看不出:
- 哪一步是 Metric Resolution(指标解析)
- 哪一步是 Result Validation(结果校验)
因此企业级 Agent(智能体)通常采用:
Auto Instrumentation(自动埋点) + Domain Instrumentation(领域语义埋点)
4.6 Observability Product(可观测产品)应该有哪些核心视图?
至少需要四类。
Session View(会话视图)
适合看:
完整用户 / 任务 Journey(交互旅程)。
关注:
- 多轮 Trace(追踪)
- Total Tokens(总 Token)
- Total Cost(总成本)
- Handoff(任务移交)
- Feedback(反馈)
- Resolution Status(问题解决状态)
Trace Tree(追踪树)
适合看:
调用关系和 Agent(智能体)执行语义。
Timeline / Waterfall(时间线 / 瀑布图)
适合看:
- 哪一个 Span(执行片段)最慢
- 是否存在并行执行
- Queue Wait(队列等待)
- Tool Wait(工具等待)
- LLM Wait(模型等待)
Agent Graph(智能体协作图)
适合看:
Multi-Agent(多智能体)整体协作拓扑。
例如:
Supervisor(主管智能体)
├─ Research Agent(研究智能体)
├─ SQL Agent(SQL 智能体)
└─ Writer Agent(写作智能体)
逐项注释(5)
- Supervisor
- Supervisor:监督者智能体。
- Research
- Research:研究。
- Agent
- Agent:智能体。
- SQL
- SQL:结构化查询语言。
- Writer
- Writer:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
需要区分:
Trace Tree(追踪树)看这一次执行怎么走。
Agent Graph(智能体协作图)看整个系统中 Agent(智能体)之间如何协作。
4.7 阶段总结
好的 Trace Schema(追踪模型)本质上是在定义:
Agent(智能体)的可解释执行语言。
它必须做到:
- 人能读懂
- 机器能查询
- Metrics(指标)能聚合
- Evaluator(评测器)能消费
- 版本变化以后结构仍然稳定
五、Telemetry Schema(遥测模型)与数据治理
5.1 Agent(智能体)应该记录哪些数据?
建议至少分六类。
Identity(身份信息)
- trace_id(追踪 ID)
- span_id(执行片段 ID)
- parent_span_id(父执行片段 ID)
- session_id(会话 ID)
- task_id(任务 ID)
Agent Context(智能体上下文)
- agent_name(智能体名称)
- agent_version(智能体版本)
- workflow_name(工作流名称)
- prompt_version(Prompt 版本)
- model(模型)
- tool_version(工具版本)
Runtime Telemetry(运行时遥测)
- latency(延迟)
- token(Token 使用量)
- cost(成本)
- error(错误)
- retry(重试)
- status(执行状态)
- cache_usage(缓存使用情况)
Semantic Data(语义数据)
- input(输入)
- output(输出)
- tool_arguments(工具参数)
- tool_result(工具结果)
- state_transition(状态转换)
- handoff_target(移交目标)
Business Metadata(业务元数据)
- user_id(用户 ID)
- tenant_id(租户 ID)
- order_id(订单 ID)
- repo_id(代码仓库 ID)
- ticket_id(工单 ID)
- release_version(发布版本)
Semantic Signal(语义信号)
- quality_score(质量得分)
- feedback(反馈)
- annotation(人工标注)
5.2 Business ID(业务 ID)和 Observability ID(可观测 ID)怎么关联?
例如 Enterprise Refund Agent(企业退款智能体):
customer_id(客户 ID)
case_id(售后案例 ID)
order_id(订单 ID)
session_id(会话 ID)
trace_id(追踪 ID)
span_id(执行片段 ID)
逐项注释(7)
- customer_id
- customer_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- ID
- ID:唯一标识符。
- case_id
- case_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- order_id
- 字段或变量名:订单的唯一标识。
- session_id
- session_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- trace_id
- trace_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- span_id
- span_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
其中:
case_id(售后案例 ID)
可能跨:
- 多个 Session(会话)
- 多天
- Agent(智能体)与人工流程
- Async Task(异步任务)
所以:
Observability ID(可观测 ID)不能替代 Business ID(业务 ID)。
更合理:
Business Identity(业务身份)
↓
Session(会话)
↓
Trace(完整执行)
↓
Span(具体执行片段)
逐项注释(5)
- Business
- Business:业务领域或业务规则。
- Identity
- Identity:身份。
- Session
- Session:会话。
- Trace
- Trace:调用轨迹。
- Span
- Span:调用链中的操作区间。
5.3 为什么 session_id(会话 ID)不能直接等于 user_id(用户 ID)?
错误设计:
session_id(会话 ID) = user_id(用户 ID)逐项注释(3)
- session_id
- session_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- ID
- ID:唯一标识符。
- user_id
- user_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
结果:
一个用户半年所有行为都成为一个 Session(会话)。
导致:
- Session Replay(会话回放)失真
- Cost Aggregation(成本聚合)错误
- Conversation Analytics(对话分析)失真
- Session(会话)无限膨胀
正确理解:
user_id(用户 ID) = 谁
session_id(会话 ID) = 哪一段会话 / 任务周期
trace_id(追踪 ID) = 哪一次完整执行
span_id(执行片段 ID) = 哪一步
5.4 High Cardinality(高基数)怎么处理?
Metrics(指标)系统非常怕:
High Cardinality(高基数)。
错误:
trace_id(追踪 ID) = xxx(动态追踪值)
user_id(用户 ID) = xxx(动态用户值)
user_query(用户问题) = xxx(动态问题内容)
逐项注释(5)
- trace_id
- trace_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- ID
- ID:唯一标识符。
- xxx
- xxx:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- user_id
- user_id:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- user_query
- user_query:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
全部作为 Metrics Label(指标标签)。
最终会造成:
Cardinality Explosion(基数爆炸)。
更适合做 Metrics Label(指标标签)的字段:
agent_type(智能体类型) = data_agent(数据智能体)
tool_name(工具名称) = sql_tool(SQL 工具)
environment(环境) = production(生产环境)
status(执行状态) = success(成功)
逐项注释(9)
- agent_type
- agent_type:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- data_agent
- data_agent:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- tool_name
- tool_name:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- sql_tool
- sql_tool:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- SQL
- SQL:结构化查询语言。
- environment
- environment:环境。
- production
- production:生产环境。
- status
- status:状态。
- success
- success:成功。
而:
- user_id(用户 ID)
- trace_id(追踪 ID)
- session_id(会话 ID)
- query(查询内容)
更适合放:
Trace Attribute(追踪属性)或者 Log Attribute(日 志属性)。
5.5 Metadata(元数据)和 Payload(业务负载)应该怎么分?
Metadata(元数据)例如:
- model(模型)
- latency(延迟)
- token(Token)
- tool_name(工具名称)
- status(状态)
- version(版本)
通常风险比较低。
Payload(业务负载)例如:
- Prompt(提示词)
- Conversation(对话内容)
- Tool Arguments(工具参数)
- SQL(结构化查询语言)
- Tool Result(工具结果)
- Document Content(文档内容)
通常更敏感。
所以生产系统更合理的默认策略:
Metadata default-on(元数据默认采集)。
Payload controlled-capture(业务负载受控采集)。
5.6 Sensitive Data(敏感数据)怎么治理?
Agent Trace(智能体追踪)里可能出现:
- PII(Personally Identifiable Information,个人身份信息)
- 财务数据
- 内部 SQL(结构化查询语言)
- Tool Result(工具结果)
- Credential(凭证)片段
- 用户对话
因此至少需要:
- Redaction(脱敏)
- Field Filtering(字段过滤)
- Sampling(采样)
- Data Retention(数据保留周期)
- Access Control(访问控制)
- Environment Separation(环境隔离)
5.7 阶段总结
Telemetry(遥测)设计不是:
采集越多越好。
而是:
在诊断价值、存储成本、Cardinality(基数)、隐私和可运营性之间做工程平衡。
六、Sampling(采样)与 Storage(存储)
6.1 为什么不能永久保存 100% Full Trace(全量完整追踪)?
Agent Trace(智能体追踪)通常具有:
- Span(执行片段)多
- Prompt(提示词)大
- Tool Result(工具结果)大
- Long-running Task(长时间任务)多
- 并发量大
- 敏感数据多
如果永久全量保存:
- Storage Cost(存储成本)高
- Network Cost(网络成本)高
- Collector Pressure(采集器压力)高
- Query Cost(查询成本)高
- Privacy Risk(隐私风险)高
6.2 Head Sampling(头部采样)是什么?
Head Sampling(头部采样):
在请求开始时决定是否采集。
优点:
- 简单
- 成本可预测
缺点:
无法提前知道这个请求最终是不是 Bad Case(坏案例)。
6.3 Tail Sampling(尾部采样)是什么?
Tail Sampling(尾部采样):
执行结束后,根据最终结果决定是否保留。
例如:
Error(系统错误)
→ Retain 100%(全部保留)

High Latency(高延迟)
→ Retain 100%(全部保留)

High Cost(高成本)
→ Retain 100%(全部保留)

Low Eval Score(低评测得分)
→ Retain 100%(全部保留)

Normal Traffic(普通正常流量)
→ Retain 5%(保留 5%)
逐项注释(10)
- Error
- Error:错误。
- Retain
- Retain:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- High
- High:高等级。
- Latency
- Latency:延迟。
- Cost
- Cost:成本。
- Low
- Low:低等级。
- Eval
- Eval:评测。
- Score
- Score:分数。
- Normal
- Normal:正常状态。
- Traffic
- Traffic:流量。
这非常适合 Agent(智能体):
很多 Bad Case(坏案例)只有执行结束以后才能识别。
6.4 Tail Sampling(尾部采样)有什么代价?
Tail Sampling(尾部采样)需要:
请求结束前先暂存 Trace(追踪)。
因此增加:
- Buffer Memory(缓冲内存)
- Collector Complexity(采集器复杂度)
- Processing Delay(处理延迟)
- Infrastructure Cost(基础设施成本)
所以成熟系统经常采用:
Hybrid Sampling(混合采样)。
例如:
High-risk Action(高风险动作)
→ Head Sampling 100%(开始时全部采集)

Normal Traffic(普通流量)
→ Head Sampling 10%(开始时采集 10%)

Error / Low Score(错误 / 低评分)
→ Tail Retain 100%(执行结束后全部保留)
逐项注释(12)
- High
- High:高等级。
- risk
- risk:风险。
- Action
- Action:动作。
- Head
- Head:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Sampling
- Sampling:采样。
- Normal
- Normal:正常状态。
- Traffic
- Traffic:流量。
- Error
- Error:错误。
- Low
- Low:低等级。
- Score
- Score:分数。
- Tail
- Tail:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Retain
- Retain:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
6.5 Trace Storage(追踪存储)怎么设计?
大型 Agent Observability Platform(智能体可观测平台)通常不会:
把所有数据塞进一个日志数据库。
更合理的数据 Pipeline(数据管道):
Agent Runtime(智能体运行时)
↓
Telemetry SDK(遥测软件开发工具包)
↓
OpenTelemetry Collector / Event Bus(OpenTelemetry 采集器 / 事件总线)
↓
Redaction / Sampling / Processing(脱敏 / 采样 / 数据处理)
↓
Trace Store(追踪存储)
+ Metrics Store(指标存储)
+ Object Storage(对象存储)
+ Data Warehouse(数据仓库)
逐项注释(18)
- Agent
- Agent:智能体。
- Runtime
- Runtime:运行时系统。
- Telemetry
- Telemetry:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- SDK
- SDK:该纯文本块中的状态、决策或错误枚举值。
- OpenTelemetry
- OpenTelemetry:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Collector
- Collector:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Event
- Event:事件。
- Bus
- Bus:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Redaction
- Redaction:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Sampling
- Sampling:采样。
- Processing
- Processing:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Trace
- Trace:调用轨迹。
- Store
- Store:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Metrics
- Metrics:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Object
- Object:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Storage
- Storage:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Data
- Data:数据。
- Warehouse
- Warehouse:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
例如:
- Span Metadata(执行片段元数据)→ Columnar Store(列式存储)
- Metrics(指标)→ TSDB(Time-series Database,时序数据库)
- Large Payload(大型业务负载)→ Object Storage(对象存储)
重点不是:
一定选择哪个数据库。
而是:
不同数据按不同访问模式进行分层存储。
6.6 阶段总结
Sampling(采样)和 Storage(存储)本质上解决:
哪些数据值得长期保存,以及规模扩大以后如何仍然存得起、查得动。
七、Metrics(指标)与 Monitoring(监控)
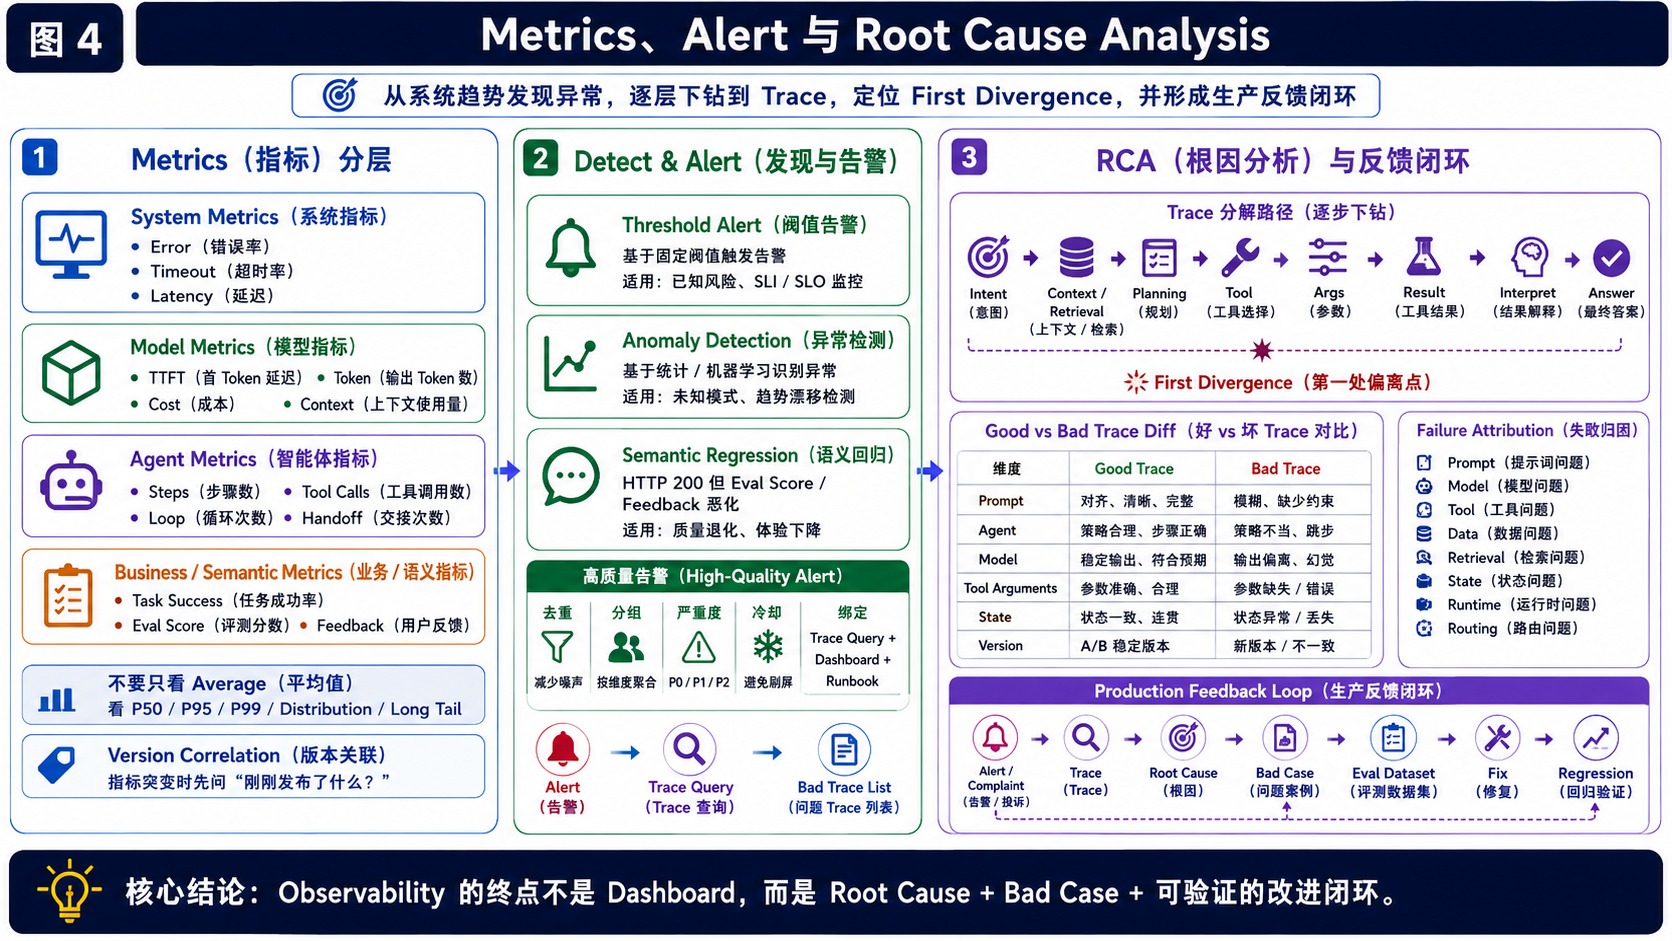
7.1 Agent Metrics(智能体指标)应该怎么分层?
建议至少四层。
System Metrics(系统指标)
- QPS(Queries Per Second,每秒请求量)
- Error Rate(错误率)
- Timeout Rate(超时率)
- Infrastructure Latency(基础设施延迟)
Model Metrics(模型指标)
- Input Tokens(输入 Token)
- Output Tokens(输出 Token)
- Cached Tokens(缓存 Token)
- TTFT(Time To First Token,首 Token 延迟)
- Generation Latency(生成延迟)
- Context Size(上下文长度)
- Model Error Rate(模型错误率)
Agent Metrics(智能体行为指标)
- Steps per Task(单任务步骤数)
- Tool Calls per Task(单任务工具调用数)
- Retry Rate(重试率)
- Handoff Rate(任务移交率)
- Loop Rate(循环率)
- Agent Turns(智能体执行轮次)
- Completion Rate(完成率)
Business / Semantic Metrics(业务 / 语义指标)
- Task Success(任务成功率)
- Online Eval Score(在线评测得分)
- User Feedback(用户反馈)
- Escalation Rate(转人工率)
- Autonomous Completion Rate(自动完成率)
7.2 为什么不能只看 Average(平均值)?
例如:
Avg Task Latency(平均任务延迟)为 8 秒。
看起来还可以。
但可能:
- P50(50 分位)为 3 秒
- P95(95 分位)为 18 秒
- P99(99 分位)为 50 秒
说明:
Long Tail(长尾)非常严重。
Agent Steps(智能体步骤数)同样如此。
平均:
5 步。
实际可能:
- 90% 请求为 3 步
- 10% 请求为 25 步
这通常意味着:
一部分任务正在 Agent Loop(智能体循环)或者严重绕路。
因此必须关注:
- Distribution(分布)
- P50 / P95 / P99(分位数)
- Long Tail(长尾)
- Segment Breakdown(分群分析)
7.3 为什么 Agent Metrics(智能体指标)比传统指标更特殊?
可能出现:
Task Success(任务成功率)基本没有变化。
但:
- Avg Steps(平均步骤数)从 5 增加到 11
- Tool Calls(工具调用数)从 3 增加到 9
- Cost(成本)上涨 150%
说明:
Agent(智能体)行为已经退化。
但传统 Error Rate(错误率)可能仍然正常。
所以:
Agent 行为本身也必须成为 Metrics(指标)。
7.4 Release / Version Correlation(发布 / 版本关联)为什么重要?
真实线上问题经常表现为:
“昨天 17:00 以后 Avg Steps(平均步骤数)突然增加 40%。”
第一反应往往不是:
阅读每条模型输出。
而是:
17:00 上了哪个 Release(发布版本)?
例如:
agent_version(智能体版本) = v21(版本 21)
avg_steps(平均步骤数) = 5.1(平均 5.1 步)

agent_version(智能体版本) = v22(版本 22)
avg_steps(平均步骤数) = 9.7(平均 9.7 步)
逐项注释(4)
- agent_version
- 字段名:智能体版本。
- v21
- v21:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- avg_steps
- avg_steps:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- v22
- v22:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
然后继续:
比较 v21(版本 21)和 v22(版本 22)的 Trace(追踪)。
因此必须关联:
- agent_version(智能体版本)
- prompt_version(Prompt 版本)
- tool_version(工具版本)
- model(模型)
- feature_flag(功能开关)
- release_version(发布版本)
7.5 Long-running Agent(长时间智能体)的 Latency(延迟)怎么算?
例如:
Trace 1(追踪 1) = 2 minutes(2 分钟)
Human Wait(人工等待) = 20 hours(20 小时)
Trace 2(追踪 2) = 3 minutes(3 分钟)
逐项注释(5)
- Trace
- Trace:调用轨迹。
- minutes
- minutes:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Human
- Human:人工或人类。
- Wait
- Wait:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- hours
- hours:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
Task Latency(任务延迟)到底是:
20 小时 5 分钟?
还是:
5 分钟?
真实系统应该区分:
- Wall-clock Duration(墙钟总时长)
- Active Execution Time(活跃执行时长)
- Human Wait Time(人工等待时长)
- Queue Wait Time(队列等待时长)
- Tool Wait Time(工具等待时长)
否则:
P95 Agent Latency(智能体 P95 延迟)
会失去可解释性。
7.6 Dashboard(看板)应该怎么设计?
Dashboard(看板)不是最终 Root Cause Analysis(根因分析)工具。
它主要负责:
Detect(发现异常) + Triage(初步分流)。
Product View(产品视图)
关注:
- Task Volume(任务量)
- Task Success(任务成功率)
- Cost(成本)
- Feedback(反馈)
- Autonomous Completion(自动完成)
Agent Runtime View(智能体运行时视图)
关注:
- Steps(步骤数)
- Tool Calls(工具调用数)
- Retry(重试)
- Loop(循环)
- Handoff(任务移交)
Model View(模型视图)
关注:
- Token(Token 使用量)
- TTFT(首 Token 延迟)
- Cost(成本)
- Generation Latency(生成延迟)
- Model Mix(模型使用分布)
Tool View(工具视图)
关注:
- Tool Volume(工具调用量)
- Error Rate(错误率)
- Latency(延迟)
- 429 Rate(限流率)
- Timeout Rate(超时率)
发现异常以后:
必须可以 Drill Down(逐层下钻)到具体 Trace(追踪)。
7.7 阶段总结
Metrics(指标)的意义是:
让 Observability(可观测性)从“这个 Case(案例)为什么错”提升成“整个系统正在发生什么变化”。
八、异常发现与 Alerting(告警)
8.1 Agent(智能体)应该对哪些问题告警?
Infrastructure Alert(基础设施告警)
- 5xx(服务器错误)
- 429(限流)
- Timeout(超时)
- Latency Spike(延迟突增)
Agent Behavior Alert(智能体行为告警)
- Steps Spike(步骤数突增)
- Tool Calls Spike(工具调用数突增)
- Loop Rate Spike(循环率突增)
- Handoff Rate Spike(移交率突增)
Semantic / Quality Alert(语义 / 质量告警)
- Online Eval Score(在线评测得分)下降
- Negative Feedback(负反馈)增加
- Task Success(任务成功率)下降
Cost Alert(成本告警)
- Token Spike(Token 使用量突增)
- Cost per Task Spike(单任务成本突增)
- Model Mix(模型使用分布)异常
8.2 为什么 Agent Alert(智能体告警)更难?
因为可能:
HTTP Status(HTTP 状态) = 200(成功)
System Error(系统错误) = false(无错误)
Latency(延迟) = normal(正常)
逐项注释(7)
- HTTP
- HTTP:超文本传输协议。
- Status
- Status:状态。
- System
- System:系统。
- Error
- Error:错误。
- false
- false:错误的或假阳性的。
- Latency
- Latency:延迟。
- normal
- normal:正常状态。
但:
Quality Score(质量得分)已经从 0.9 降到 0.5。
所以 Agent Alert(智能体告警)不能只依赖:
Infrastructure Signal(基础设施信号)。
还必须结合:
Behavior Signal(行为信号) + Semantic Signal(语义信号)。
8.3 Threshold Alert(阈值告警)和 Anomaly Detection(异常检测)怎么选?
Threshold Alert(阈值告警)适合:
有明确业务边界。
例如:
Tool Error Rate(工具错误率)超过 5%。
Anomaly Detection(异常检测)适合:
没有固定阈值,但明显偏离历史分布。
例如:
Avg Steps(平均步骤数)从 5.3 突然增加到 9.8。
8.4 怎么避免 Alert Fatigue(告警疲劳)?
不能:
所有指标都告警。
需要结合:
- User Impact(用户影响)
- Risk Level(风险等级)
- Duration(持续时间)
- Rate(发生比例)
- Correlation(关联异常)
还需要:
- Deduplication(去重)
- Grouping(分组)
- Severity(告警级别)
- Suppression(告警抑制)
- Cooldown(冷却时间)
更好的生产实践是:
告警直接绑定 Trace Query(追踪查询条件)、Dashboard(看板)以及 Runbook(故障处理手册)。
这样 On-call Engineer(值班工程师)收到告警后:
Alert(告警)
↓
Trace Query(追踪查询)
↓
Bad Trace List(异常追踪列表)
↓
Root Cause Analysis(根因分析)
逐项注释(6)
- Alert
- Alert:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Trace
- Trace:调用轨迹。
- Query
- Query:查询。
- Bad Trace
- 异常轨迹:包含错误、低效或违规行为的执行轨迹。
- List
- List:列表。
- Root Cause Analysis
- 根因分析:基于证据定位问题底层机制并制定防复发措施,常缩写为 RCA。
而不是重新从零搜索。
8.5 阶段总结
好的 Alerting(告警体系)不是:
告警数量更多。
而是:
发现得准、入口清楚,并且能够直接进入 Trace(追踪)和 Root Cause(根因)。
九、Root Cause Analysis(根因分析)与 Failure Attribution(失败归因)
9.1 Agent(智能体)出错怎么做 Root Cause Analysis(根因分析)?
Observability(可观测性)的最终目标不是:
Dashboard(看板)。
而是:
Root Cause Analysis(根因分析)。
例如 Data Agent(数据智能体)最终答案错误:
User Intent(用户意图)
↓
Context / Retrieval(上下文 / 检索)
↓
Metric Resolution(指标解析)
↓
Planning(规划)
↓
Tool Selection(工具选择)
↓
Arguments(工具参数)
↓
Tool Result(工具结果)
↓
State(状态)
↓
Interpretation(结果解释)
↓
Final Answer(最终回答)
逐项注释(13)
- User
- User:用户。
- Intent
- Intent:意图。
- Context
- Context:上下文。
- Retrieval
- Retrieval:检索。
- Metric
- Metric:指标。
- Resolution
- Resolution:解决方案或分辨率,依上下文确定。
- Planning
- Planning:规划。
- Tool Selection
- 工具选择:判断当前步骤应调用哪个工具。
- Arguments
- Arguments:参数集合。
- Tool Result
- 工具结果:外部工具执行后返回的输出。
- State
- State:状态。
- Interpretation
- Interpretation:解释。
- Final Answer
- 最终答案:智能体完成执行后呈现给用户的最终输出。
然后沿 Trace(追踪)寻找:
First Divergence(第一处偏离点)。
9.2 Observability(可观测性)和 First Divergence(第一处偏离点)的关系是什么?
Quality(质量)负责:
判断哪一步开始出错。
Observability(可观测性)负责:
有没有留下足够 Evidence(证据)让它可以被发现。
例如:
Metric Retrieval(指标检索) ✅
SQL Generation(SQL 生成) ✅
SQL Result(SQL 结果) ✅
Result Interpretation(结果解释) ❌
Final Answer(最终回答) ❌
逐项注释(6)
- Metric Retrieval
- 指标检索:找到任务需要使用的指标定义。
- SQL
- SQL:结构化查询语言。
- Generation
- Generation:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Result
- Result:结果。
- Interpretation
- Interpretation:解释。
- Final Answer
- 最终答案:智能体完成执行后呈现给用户的最终输出。
Root Cause(根因)是:
Result Interpretation(结果解释错误)。
如果只保存:
Input(输入) + Final Output(最终输出)
就无法真正定位。
9.3 为什么要做 Good Trace vs Bad Trace Diff(正常追踪与异常追踪差异对比)?
只盯一个 Bad Trace(异常追踪)有时很难找到问题。
更高效的方法:
Good Trace vs Bad Trace Diff(正常追踪 / 异常追踪差异对比)。
可以比较:
- Prompt Version(Prompt 版本)
- Agent Version(智能体版本)
- Model(模型)
- Retrieved Context(检索上下文)
- Tool Arguments(工具参数)
- Tool Result(工具结果)
- State(状态)
- Step Count(步骤数量)
- Latency(延迟)
例如:
Good Trace(正常追踪)
prompt_version(Prompt 版本) = v21(版本 21)
generate_sql(生成 SQL) = SQL_A(正常 SQL A)

Bad Trace(异常追踪)
prompt_version(Prompt 版本) = v22(版本 22)
generate_sql(生成 SQL) = SQL_B(异常 SQL B)
逐项注释(13)
- Good
- Good:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Trace
- Trace:调用轨迹。
- prompt_version
- 字段名:提示词版本。
- Prompt
- Prompt:提示词。
- v21
- v21:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- generate_sql
- generate_sql:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- SQL
- SQL:结构化查询语言。
- SQL_A
- SQL_A:该纯文本块中的状态、决策或错误枚举值。
- A
- A:示例标识 A。
- Bad Trace
- 异常轨迹:包含错误、低效或违规行为的执行轨迹。
- v22
- v22:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- SQL_B
- SQL_B:该纯文本块中的状态、决策或错误枚举值。
- B
- B:示例标识 B。
很快就可以怀疑:
Release v22(发布版本 22)可能引入 Regression(回归问题)。
成熟 Root Cause Analysis(根因分析)通常结合:
Single Trace RCA(单追踪根因分析)
Good / Bad Trace Diff(正常 / 异常追踪差异对比)
Version / Segment Comparison(版本 / 分群对比)
9.4 Failure Attribution(失败归因)怎么分类?
常见 Root Cause(根因)包括:
- Prompt Problem(Prompt 问题)
- Model Problem(模型问题)
- Tool Problem(工具问题)
- Data Problem(数据问题)
- Retrieval Problem(检索问题)
- State Problem(状态问题)
- Runtime Problem(运行时问题)
- Routing / Handoff Problem(路由 / 移交问题)
9.5 Multi-Agent(多智能体)怎么做 Responsibility Attribution(责任归因)?
例如:
Supervisor(主管智能体)
↓
Research Agent(研究智能体)
↓
SQL Agent(SQL 智能体)
↓
Database Tool(数据库工具)
逐项注释(6)
- Supervisor
- Supervisor:监督者智能体。
- Research
- Research:研究。
- Agent
- Agent:智能体。
- SQL
- SQL:结构化查询语言。
- Database
- Database:数据库。
- Tool
- Tool:工具。
结果错误。
必须知道:
- 谁创建了 Subtask(子任务)
- 谁选择了 Worker Agent(执行智能体)
- 谁生成 SQL(结构化查询语言)
- 谁解释 Tool Result(工具结果)
- 谁聚合最终答案
因此至少应该记录:
- source_agent(来源智能体)
- target_agent(目标智能体)
- task_id(任务 ID)
- parent_task_id(父任务 ID)
- delegation_reason(委派原因)
- agent_version(智能体版本)
- handoff_event(任务移交事件)
这样才能支持:
Cross-Agent Responsibility Attribution(跨智能体责任归因)。
9.6 阶段总结
Observability(可观测性)真正的高潮不是:
“我有 Trace(追踪)。”
而是:
我能够基于 Trace(追踪)找到 First Divergence(第一处偏离点),解释 Root Cause(根因),并证明问题和哪个 Version(版本)、Agent(智能体)、Tool(工具)或者 Data(数据)变化有关。
十、生产反馈闭环
10.1 线上问题怎么进入改进闭环?
一个成熟的生产闭环:
Alert / User Complaint(告警 / 用户投诉)
↓
Trace Investigation(追踪调查)
↓
Root Cause(根因)
↓
Bad Case(坏案例)
↓
Eval Dataset(评测数据集)
↓
Fix(修复)
↓
Regression Validation(回归验证)
↓
Production(重新上线生产环境)
逐项注释(12)
- Alert
- Alert:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- User
- User:用户。
- Complaint
- Complaint:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Trace
- Trace:调用轨迹。
- Investigation
- Investigation:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Root Cause
- 根因:能够解释问题发生机制并指导永久修复的底层原因。
- Bad Case
- 失败样本:线上或评测中表现不符合预期的具体案例。
- Eval Dataset
- 评测数据集:用于系统化验证模型或智能体能力的一组输入与期望。
- Fix
- Fix:修复。
- Regression
- Regression:回归。
- Validation
- Validation:验证。
- Production
- Production:生产环境。
Observability(可观测性)负责:
捕获和还原线上 Failure(失败)。
Quality(质量)负责:
把 Failure(失败)转化成可以重复执行的 Evaluation(评测)和 Regression(回归测试)。
10.2 为什么 Online Eval Score(在线评测得分)属于 Observability Signal(可观测信号)?
可能:
- Error Rate(错误率)正常
- Latency(延迟)正常
- Tool(工具)正常
但:
Online Eval Score(在线评测得分)从 0.85 降到了 0.55。
Observability(可观测平台)应该:
发现这个 Semantic Regression(语义回归)。
但是:
Score(得分)怎么计算
仍然属于 Quality(质量)。
10.3 阶段总结
Observability(可观测性)的终点不是:
数据展示。
而是:
让线上失败能够被捕获、被解释,并进入下一轮系统改进。
十一、真实产品设计与生产踩坑
11.1 平台应该支持哪两种 Debug(排障)入口?
Top-down(自上而下)
从:
Dashboard(看板) / Alert(告警)
开始:
Metric(指标)
↓
Trace List(追踪列表)
↓
Trace(完整追踪)
↓
Span(具体执行片段)
逐项注释(4)
- Metric
- Metric:指标。
- Trace
- Trace:调用轨迹。
- List
- List:列表。
- Span
- Span:调用链中的操作区间。
例如:
SQL Tool Error Rate(SQL 工具错误率)突然升高。
Bottom-up(自下而上)
客服反馈:
Order 123(订单 123)有问题。
通过:
order_id(订单 ID)
↓
Business Task(业务任务)
↓
Session(会话)
↓
Trace(完整追踪)
↓
Span(具体步骤)
逐项注释(7)
- order_id
- 字段或变量名:订单的唯一标识。
- ID
- ID:唯一标识符。
- Business
- Business:业务领域或业务规则。
- Task
- Task:任务。
- Session
- Session:会话。
- Trace
- Trace:调用轨迹。
- Span
- Span:调用链中的操作区间。
所以企业级平台必须同时支持:
Aggregate → Trace(聚合指标下钻到追踪)
以及:
Business ID → Trace(业务 ID 定位到追踪)
11.2 最常见的生产踩坑有哪些?
坑一:一个 Conversation(对话)一个巨大 Trace(追踪)
结果:
Trace Tree(追踪树)爆炸。
坑二:session_id(会话 ID)直接使用 user_id(用户 ID)
结果:
一个用户半年变成一个 Session(会话)。
坑三:Span(执行片段)太粗
只能看到:
Agent Run(智能体执行)耗时 10 秒。
无法 Root Cause Analysis(根因分析)。
坑四:Span(执行片段)太细
Framework Internal Detail(框架内部细节)全部进入 Trace。
最终噪声大于价值。
坑五:Span Name(执行片段名称)绑定 Model(模型)
换模型以后:
Dashboard(看板)、Evaluation(评测)、Saved Filter(保存过滤条件)全部失效。
坑六:没有 Version Metadata(版本元数据)
线上出现问题以后:
不知道哪个 Release(发布版本)引入。
坑七:High Cardinality(高基数)字段成为 Metrics Label(指标标签)
导致:
Metrics Storage(指标存储)膨胀。
坑八:全量永久保存 Prompt(提示词)与 Result(结果)
产生:
Privacy / Compliance(隐私 / 合规)风险。
坑九:只有 Auto Instrumentation(自动埋点)
看到技术调用:
看不到 Agent(智能体)业务语义。
坑十:跨 Worker(工作进程)没有传播 Trace Context(追踪上下文)
Long-running Agent(长时间智能体)恢复以后:
链路断裂。
坑十一:所有异步关系都强行使用 Parent-child(父子关系)
导致:
Trace(追踪)的真实因果关系失真。
坑十二:Dashboard(看板)很多,但是不能 Drill Down(逐层下钻)到 Trace(追踪)
最后只能知道:
系统有问题。
却不知道:
为什么。
11.3 阶段总结
真实 Observability(可观测性)项目最容易失败的地方通常不是:
没有接 SDK(软件开发工具包)。
而是:
数据模型不稳定、语义埋点不足、Correlation(关联)设计错误,导致真正线上排障时数据根本用不起来。
十二、行业平台与技术路线
12.1 真实平台的数据模型有什么共同点?
不同平台名称不同,但底层抽象非常接近。
| 平台 | 长期上下文 | 一次执行 | 单步骤 |
|---|---|---|---|
| Langfuse | Session(会话) | Trace(追踪) | Observation(观测单元) |
| LangSmith | Thread(对话线程) | Trace(追踪) | Run(执行单元) |
| Phoenix | Session(会话) | Trace(追踪) | Span(执行片段) |
| OpenAI Agents SDK | Group / Conversation(分组 / 对话) | Trace(追踪) | Span(执行片段) |
| OpenTelemetry | Business Correlation(业务关联) | Trace(追踪) | Span(执行片段) |
本质都是:
Long-lived Context(长期上下文) → Execution(一次执行) → Operation(具体操作)
12.2 行业方案可以分成哪三类?
SDK-native(SDK 原生路线)
例如:
OpenAI Agents SDK Tracing(OpenAI 智能体 SDK 原生追踪)
优势:
- Agent(智能体)语义深
- 接入成本低
- 原生理解 Tool(工具)、Handoff(任务移交)、Generation(模型生成)
Standards-first(标准优先路线)
例如:
OpenTelemetry(开放遥测标准) + 企业传统 APM(应用性能监控)
优势:
- 跨语言
- 跨框架
- 容易和企业已有基础设施融合
- Vendor Lock-in(厂商绑定)较低
AI-native Platform(AI 原生平台路线)
例如:
- LangSmith
- Langfuse
- Phoenix
- Braintrust
更强调:
Trace(追踪) + Evaluation(评测) + Feedback(反馈) + Dataset(数据集) + Experiment(实验) + Monitoring(监控)
12.3 Traditional APM(传统 APM)和 AI-native Observability(AI 原生可观测性)是二选一吗?
通常不是。
Traditional APM(传统应用性能监控)擅长:
- Infrastructure(基础设施)
- Service Trace(服务链路追踪)
- Error(错误)
- Latency(延迟)
- Database / RPC(数据库 / 远程过程调用)
AI-native Observability(AI 原生可观测性)补充:
- Prompt / Completion(提示词 / 模型完成结果)
- Session(会话)
- Agent / Tool Semantic(智能体 / 工具语义)
- Generation(模型生成)
- Handoff(任务移交)
- Eval Score(评测得分)
- Feedback(反馈)
- Dataset(数据集)
- Experiment(实验)
更成熟的架构通常是:
OpenTelemetry / Unified Telemetry(OpenTelemetry / 统一遥测)
↓
Traditional APM(传统应用性能监控)
+
Agent-native Observability(智能体原生可观测平台)
+
Evaluation Platform(评测平台)
逐项注释(10)
- OpenTelemetry
- OpenTelemetry:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Unified
- Unified:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Telemetry
- Telemetry:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Traditional
- Traditional:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- APM
- APM:该纯文本块中的状态、决策或错误枚举值。
- Agent
- Agent:智能体。
- native
- native:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Observability
- Observability:可观测性。
- Evaluation
- Evaluation:评估。
- Platform
- Platform:平台。
而不是:
接了 AI-native Observability(AI 原生可观测平台)就不再需要传统 APM(应用性能监控)。
12.4 企业应该 Build vs Buy(自研还是采购)?
大型企业更合理的架构通常是:
Agent SDK / Runtime(智能体 SDK / 运行时)
↓
Unified Telemetry Schema(统一遥测模型)
↓
OpenTelemetry / Internal Pipeline(开放遥测 / 内部数据管道)
↓
Traditional APM(传统应用性能监控)
+ Agent Trace UI(智能体追踪界面)
+ Metrics / Alert(指标 / 告警)
+ Evaluation Platform(评测平台)
+ Data Warehouse(数据仓库)
逐项注释(19)
- Agent
- Agent:智能体。
- SDK
- SDK:该纯文本块中的状态、决策或错误枚举值。
- Runtime
- Runtime:运行时系统。
- Unified
- Unified:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Telemetry
- Telemetry:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Schema
- Schema:结构模式。
- OpenTelemetry
- OpenTelemetry:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Internal
- Internal:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Pipeline
- Pipeline:流水线。
- Traditional
- Traditional:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- APM
- APM:该纯文本块中的状态、决策或错误枚举值。
- Trace
- Trace:调用轨迹。
- UI
- UI:User Interface,用户界面。
- Metrics
- Metrics:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Alert
- Alert:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Evaluation
- Evaluation:评估。
- Platform
- Platform:平台。
- Data
- Data:数据。
- Warehouse
- Warehouse:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
关键原则:
Telemetry Standardization(遥测标准化)和 Observability Product(可观测产品)解耦。
避免 Agent Runtime(智能体运行时):
强绑定某一个第三方产品的专有数据结构。
12.5 企业选型真正应该比较什么?
应该比较:
- Trace Data Model(追踪数据模型)
- Session Support(会话支持)
- Agent Semantic Type(智能体语义类型)
- OpenTelemetry Compatibility(OpenTelemetry 兼容性)
- Evaluation Integration(评测集成)
- Alerting(告警能力)
- Dataset / Experiment(数据集 / 实验)
- Self-host(自托管能力)
- Privacy(隐私)
- Query / Scale(查询 / 规模能力)
- Existing Infrastructure Integration(现有基础设施集成能力)
而不是:
谁的菜单功能最多。
12.6 阶段总结
行业平台真正值得研究的不是:
产品功能列表。
而是:
它们如何定义 Session(会话)、Trace(追踪)、Span(执行片段)等数据模型,如何保留 Agent(智能体)语义,如何支持 Root Cause Analysis(根因分析),以及如何接入企业现有 Telemetry Infrastructure(遥测基础设施)。
十三、与其他模块的边界
13.1 Observability(可观测性)和其他生产能力怎么区分?
用同一个 Data Agent(数据智能体)案例最容易理解。
用户问:
为什么昨天 GMV(商品交易总额)下降?
| 能力 | 核心问题 | 同一个案例中的职责 |
|---|---|---|
| Quality(质量) | 做对了吗? | 判断 Result Interpretation(结果解释)是否错误 |
| Reliability(稳定性) | 失败以后还能稳定恢复吗? | SQL Tool Timeout(SQL 工具超时)以后能否安全 Retry(重试) |
| Controllability(可控性) | 行为能不能被约束? | 高风险数据访问是否需要 Approval(审批) |
| Observability(可观测性) | 发生了什么,为什么? | 重建 Metric(指标)→ SQL(查询)→ Result(结果)→ Answer(答案)完整链路 |
| Performance(性能) | 为什么慢,怎么更快? | 发现 Tool Span(工具执行片段)占总耗时 70%,进一步优化 |
| Cost(成本) | 为什么贵,怎么更省? | 发现 Replanning(重新规划)过多导致 Token / Tool Cost(Token / 工具成本)过高 |
例如:
Observability(可观测性)
→ 发现两个 SQL Tool Call(SQL 工具调用)占总延迟 80%

Performance(性能)
→ 决定是否并行执行、缓存或者减少 Tool Call(工具调用)

Observability(可观测性)
→ 发现 Token Cost(Token 成本)异常升高

Cost(成本)
→ 决定如何压缩 Context(上下文)或者进行 Model Routing(模型路由)
逐项注释(10)
- Observability
- Observability:可观测性。
- SQL
- SQL:结构化查询语言。
- Tool
- Tool:工具。
- Call
- Call:调用。
- Performance
- Performance:性能。
- Token
- Token:模型处理文本的词元。
- Cost
- Cost:成本。
- Context
- Context:上下文。
- Model
- Model:模型。
- Routing
- Routing:路由:根据条件选择模型、工具或处理路径。
所以:
Observability(可观测性)负责建立事实和证据。
它不会代替:
- Quality Judgment(质量判断)
- Reliability Recovery(稳定性恢复)
- Performance Optimization(性能优化)
- Cost Optimization(成本优化)
13.2 阶段总结
Observability(可观测性)是其他生产能力的重要信息基础。
但它自己的职责始终是:
看清、关联、度量、诊断。
十四、P0 / P1 / P2(面试优先级)
14.1 P0:必须掌握
- 什么是 Agent Observability(Agent 可观测性)?
- Observability(可观测性)和 Monitoring(监控)有什么区别?
- Observability(可观测性)和 Evaluation(评测)有什么区别?
- 为什么 Traditional APM(传统应用性能监控)不够?
- Logs(日志)、Metrics(指标)、Traces(追踪)、Events(事件)有什么区别?
- Session(会话)、Trace(追踪)、Span(执行片段)分别是什么?
- 一个 Agent Trace(智能体追踪)应该怎么切?
- Span Granularity(执行片段粒度)怎么设计?
- Trace Schema(追踪模型)应该记录什么?
- Span Name(执行片段名称)怎么设计?
- 为什么 Auto Instrumentation(自动埋点)不够?
- Agent Metrics(智能体指标)怎么分层?
- High Cardinality(高基数)怎么处理?
- Sampling(采样)怎么设计?
- Sensitive Data(敏感数据)怎么治理?
- Agent(智能体)出错怎么做 Root Cause Analysis(根因分析)?
- First Divergence(第一处偏离点)怎么定位?
- Long-running Agent(长时间运行智能体)怎么关联 Trace(追踪)?
- Multi-Agent Trace(多智能体追踪)怎么设计?
- Observability Product(可观测产品)应该有哪些核心 View(视图)?
- Production Trace(生产追踪)怎么进入改进闭环?
14.2 P1:高级工程实践
重点包括:
- Session Boundary(会话边界)
- Business ID Correlation(业务 ID 关联)
- Parent-child vs Span Link(父子关系与执行片段链接)
- Semantic-first Instrumentation(语义优先埋点)
- Release / Version Correlation(发布 / 版本关联)
- Good Trace vs Bad Trace Diff(正常 / 异常追踪差异对比)
- Agent Graph vs Trace Tree(智能体协作图与追踪树)
- Distribution / Long Tail(分布 / 长尾)
- Wall-clock vs Active Execution Time(墙钟总时长与活跃执行时长)
- Hybrid Sampling(混合采样)
- Metadata / Payload Separation(元数据与业务负载分离)
- Tail Sampling Infrastructure Cost(尾部采样基础设施成本)
- Multi-Agent Responsibility Attribution(多智能体责任归因)
- Context Propagation(上下文传播)
- Trace Retention(追踪保留策略)
- Top-down / Bottom-up Debug(自上而下 / 自下而上排障)
P1(高级优先级)的重点是:
体现是否真正做过 Agent Runtime(智能体运行时)或者 Observability Platform(可观测平台)。
14.3 P2:平台与架构
重点包括:
- OpenTelemetry(开放遥测标准)
- GenAI Semantic Conventions(生成式 AI 语义约定)
- Unified Telemetry Schema(统一遥测模型)
- Trace Storage Architecture(追踪存储架构)
- Columnar Trace Store(列式追踪存储)
- Large Payload Storage(大型业务负载存储)
- Sampling Pipeline(采样管道)
- Multi-tenant Isolation(多租户隔离)
- Query / Index Design(查询 / 索引设计)
- Telemetry / Product Decoupling(遥测与产品解耦)
- Build vs Buy(自研还是采购)
- LangSmith / Langfuse / Phoenix / Braintrust 平台选型
- Enterprise Agent Observability Platform Architecture(企业级智能体可观测平台架构)
十五、高价值追问链
15.1 Session(会话)/ Trace(追踪)/ Span(执行片段)
Session、Trace、Span 是什么? ↓ 一个 Chat Turn(对话轮次)为什么通常一个 Trace? ↓ 为什么整个 Conversation(对话)不建议一个巨大 Trace? ↓ Coding Agent(代码智能体)运行 3 小时怎么办? ↓ HITL(Human-in-the-loop,人在回路中)第二天 Resume(恢复执行)怎么关联? ↓ Parent-child(父子关系)和 Span Link(执行片段链接)怎么选?
15.2 Trace Schema(追踪模型)
Trace 应该记录什么? ↓ 为什么不能只记录 Input(输入) / Output(输出)? ↓ Span Granularity(执行片段粒度)怎么定? ↓ Span Name(执行片段名称)怎么设计? ↓ 为什么不能把 Model Name(模型名称)作为业务 Span Name? ↓ Release Version(发布版本)为什么必须记录?
15.3 Metrics(指标)
Agent Metrics(智能体指标)看什么? ↓ Error(错误) / Latency(延迟)够吗? ↓ Steps(步骤数) / Tool Calls(工具调用数)为什么重要? ↓ 为什么不能只看 Average(平均值)? ↓ P95 / P99(95 / 99 分位数)说明什么? ↓ Version Regression(版本回归)怎么发现?
15.4 Sampling(采样)
为什么不能永久保存 100% Full Trace(全量完整追踪)? ↓ Head Sampling(头部采样)是什么? ↓ Tail Sampling(尾部采样)为什么适合 Agent? ↓ Tail Sampling 的代价是什么? ↓ Hybrid Sampling(混合采样)怎么设计?
15.5 Root Cause Analysis(根因分析)
Final Answer(最终答案)错了怎么查? ↓ First Divergence(第一处偏离点)怎么找? ↓ Model / Prompt / Tool / Data(模型 / Prompt / 工具 / 数据)怎么归因? ↓ 为什么要找 Good Trace(正常追踪)做对比? ↓ Multi-Agent(多智能体)怎么确定责任 Agent? ↓ 怎么把 Trace(追踪)变成 Regression Case(回归案例)?
十六、核心记忆点
- Observability(可观测性)提供 Evidence(证据),Evaluation(评测)提供 Judgment(判断)。
- Session(会话)看长期 Journey(交互旅程),Trace(追踪)看一次执行,Span(执行片段)看具体步骤。
- Event(事件)表示瞬时事实,Span(执行片段)表示有生命周期的 Operation(操作)。
- 一个能独立 Debug(调试)和 Evaluation(评测)的逻辑单元通常适合作为一个 Trace(追踪)。
- 巨大 Trace(追踪)和巨大 Session(会话)都是常见生产坑。
- Span(执行片段)粒度应该围绕业务语义、故障边界和诊断价值设计。
- Span Name(执行片段名称)应保持稳定,Model(模型)和 Version(版本)放 Attribute(属性)。
- Instrumentation(埋点)应该 Semantic-first(语义优先),而不是 Framework-first(框架优先)。
- Auto Instrumentation(自动埋点)解决基础链路,Domain Instrumentation(领域埋点)补业务语义。
- Business ID(业务 ID)不等于 Observability ID(可观测 ID)。
- High Cardinality(高基数)数据适合 Trace(追踪)查询,不适合随便做 Metric Label(指标标签)。
- Metadata(元数据)可以默认采,Payload(业务负载)应该谨慎采。
- Tail Sampling(尾部采样)适合捕获 Error(错误)、High Cost(高成本)、Low Score(低评分)案例,但基础设施更复杂。
- HTTP 200(HTTP 成功)不代表 Agent(智能体)成功。
- Agent Metrics(智能体指标)不只看 Error(错误)和 Latency(延迟),还要看 Steps(步骤)、Tool Calls(工具调用)、Loop(循环)、Handoff(任务移交)。
- 不能只看 Average(平均值),还要看 Distribution(分布)和 Long Tail(长尾)。
- Release(发布版本)、Prompt(提示词)、Agent(智能体)、Tool Version(工具版本)必须与 Trace(追踪)关联。
- Long-running Agent(长时间智能体)要区分 Wall-clock Duration(墙钟总时长)和 Active Execution Time(活跃执行时长)。
- Dashboard(看板)是异常发现入口,不是 Root Cause Analysis(根因分析)终点。
- Good Trace vs Bad Trace Diff(正常 / 异常追踪对比)是非常有效的生产诊断方式。
- Quality(质量)判断 First Divergence(第一处偏离点),Observability(可观测性)提供找到它的 Evidence(证据)。
- Multi-Agent(多智能体)需要同时具备 Trace Tree(追踪树)和 Agent Graph(智能体协作图)视角。
- 平台必须同时支持 Aggregate → Trace(聚合指标下钻到追踪)和 Business ID → Trace(业务 ID 定位追踪)。
- Telemetry Schema(遥测模型)应该和具体 Observability Product(可观测产品)解耦。
- Observability(可观测性)的终点是 Root Cause(根因)和生产反馈闭环,而不是漂亮的 Trace Page(追踪页面)。
十七、2~3 分钟标准回答
如果面试官问:
你怎么理解生产级 Agent Observability(Agent 可观测性)?
可以回答:
生产级 Agent Observability(Agent 可观测性)不能简单理解成打日志或者接传统 APM(应用性能监控)。Agent(智能体)和普通 Backend(后端服务)最大的区别,是执行路径部分由 Model(模型)在 Runtime(运行时)动态决定,而且很多失败属于 Semantic Failure(语义失败),例如 Tool(工具)选错、参数错误、Retrieval(检索)错误、Tool Result(工具结果)被错误解释或者 Multi-Agent Routing(多智能体路由)错误。这种情况下 HTTP(超文本传输协议)请求可能全部返回 200,所以传统 Error(错误)和 Latency(延迟)指标并不能告诉我们 Agent(智能体)是否真正工作正常。
我通常从五个能力理解 Agent Observability(Agent 可观测性):Reconstructability(可重建性),也就是能不能重建一次完整 Agent Run(智能体执行);Correlatability(可关联性),也就是 Session(会话)、Trace(追踪)、Span(执行片段)、Agent(智能体)、Tool(工具)、Worker(工作进程)和 Business ID(业务 ID)能不能串起来;Measurability(可度量性),也就是单次 Trace(追踪)能不能聚合成系统级 Metrics(指标);Diagnosability(可诊断性),也就是能不能定位 First Divergence(第一处偏离点)和 Root Cause(根因);以及 Actionability(可行动性),也就是发现问题以后能不能进入 Alert(告警)、Bad Case(坏案例)、Evaluation(评测)和 Regression(回归验证)。
数据模型上,我会明确区分 Session(会话)、Trace(追踪)、Span(执行片段)和 Event(事件)。Session(会话)表示长期 Conversation(对话)或者 Task Lifetime(任务生命周期);Trace(追踪)表示一个能够独立 Debug(调试)和 Evaluation(评测)的完整逻辑执行;Span(执行片段)表示 Trace(追踪)里的一个具体 Operation(操作);Event(事件)则适合表示 Retry(重试)、Handoff(任务移交)、Approval Received(收到审批)这种瞬时事实。
Trace(追踪)切分本身很重要。Chat Agent(对话智能体)一般适合一轮一个 Trace(追踪),多轮 Conversation(对话)用 Session(会话)关联。Coding Agent(代码智能体)运行几个小时,不建议全部塞到一个巨大 Trace(追踪),可以按照 Investigation(调查)、Implementation(实现)、Test(测试)、Verification(验证)切成多个 Trace(追踪),再通过 task_id(任务 ID)和 session_id(会话 ID)串起来。Long-running Agent(长时间运行智能体)跨 HITL(人在回路中)或者跨 Worker(工作进程)恢复执行时,也不能只依赖进程内 Trace Context(追踪上下文),而应该持久化业务关联 ID,并通过 Span Link(执行片段链接)或者 Correlation ID(关联 ID)建立后续关系。
Trace Schema(追踪模型)设计上,我会强调 Semantic-first(语义优先)。Span(执行片段)应该围绕 resolve_metric(解析指标)、generate_sql(生成 SQL)、execute_query(执行查询)、validate_result(验证结果)这些稳定业务语义设计,而不是围绕 Framework Node(框架节点)或者 Model Name(模型名称)设计。Model(模型)、Prompt Version(提示词版本)、Agent Version(智能体版本)、Tool Version(工具版本)应该作为 Attribute(属性),这样换模型或者 Release(发布版本)以后,Dashboard(看板)、Evaluator(评测器)和历史分析仍然稳定。
Instrumentation(埋点)一般采用 Auto Instrumentation(自动埋点)和 Domain Instrumentation(领域语义埋点)结合。自动埋点解决 HTTP(超文本传输协议)、LLM(大语言模型)、Database(数据库)等基础链路,业务埋点补 Agent(智能体)真正的语义步骤。Telemetry(遥测)还必须处理 High Cardinality(高基数)、Sensitive Data(敏感数据)和 Sampling(采样)。例如 trace_id(追踪 ID)和 user_id(用户 ID)不应该随便作为 Metrics Label(指标标签),Prompt(提示词)和 Tool Result(工具结果)属于敏感 Payload(业务负载),应该按需采集、脱敏和权限控制。
线上 Metrics(指标)也不能只看 Error(错误)和 Average Latency(平均延迟)。我会同时看 System Metrics(系统指标)、Model Metrics(模型指标)、Agent Metrics(智能体指标)和 Business Metrics(业务指标),尤其关注 Steps per Task(单任务步骤数)、Tool Calls per Task(单任务工具调用数)、Loop Rate(循环率)、Handoff Rate(任务移交率),以及 P50、P95、P99 等 Distribution(分布)和 Long Tail(长尾)。另外必须能够按照 agent_version(智能体版本)、prompt_version(提示词版本)、model(模型)、tool_version(工具版本)以及 release_version(发布版本)做 Correlation(关联),因为很多真实线上问题首先表现为某个版本上线以后 Agent(智能体)行为突然漂移。
出现 Bad Case(坏案例)以后,我会沿 Trace(追踪)从 Intent(意图)、Context(上下文)、Planning(规划)、Tool Selection(工具选择)、Arguments(工具参数)、Tool Result(工具结果)、State(状态)一路到 Final Answer(最终回答),寻找 First Divergence(第一处偏离点),同时找到一个 Good Trace(正常追踪)和 Bad Trace(异常追踪)做 Diff(差异对比),再结合 Release / Version Comparison(发布 / 版本对比)判断到底是 Prompt(提示词)、Model(模型)、Tool(工具)、Data(数据)、State(状态)还是 Routing(路由)问题。Multi-Agent(多智能体)还要记录 source_agent(来源智能体)、target_agent(目标智能体)、subtask(子任务)、handoff(任务移交)和 parent_task(父任务)信息,才能进行跨智能体责任归因。
平台层面,我不会让 Agent Runtime(智能体运行时)强绑定某一个 Observability Product(可观测产品)。我更倾向于先定义 Unified Telemetry Schema(统一遥测模型),尽量兼容 OpenTelemetry(开放遥测标准),然后分别接入 Traditional APM(传统应用性能监控)、Agent Trace UI(智能体追踪界面)、Metrics / Alert(指标 / 告警)、Evaluation Platform(评测平台)和 Data Warehouse(数据仓库)。这样 Telemetry Standardization(遥测标准化)和 Product Layer(产品层)解耦,未来切换平台或者同时接多个系统都会更容易。
所以我认为生产级 Agent Observability(Agent 可观测性)的本质是:
让 Agent(智能体)的每一次行为都能够被完整重建、跨上下文关联、系统化度量并最终定位 Root Cause(根因),然后把线上失败转化成真正可以推动系统改进的生产证据。
十八、最终记忆模型
18.1 五个系统能力
Reconstructability(可重建性) Correlatability(可关联性) Measurability(可度量性) Diagnosability(可诊断性) Actionability(可行动性)
18.2 三级数据模型
Session(会话) → Trace(追踪) → Span(执行片段)
对应:
长期上下文 → 一次完整执行 → 一个具体操作
18.3 四类基础 Telemetry Signal(遥测信号)
Logs(日志) Metrics(指标) Traces(追踪) Events(事件)
18.4 两类观测信号
Runtime Telemetry(运行时遥测):Logs(日志) / Metrics(指标) / Traces(追踪) / Events(事件)
AI Semantic Signals(AI 语义信号):Eval Score(评测得分) / Feedback(反馈) / Annotation(人工标注)
18.5 八步主链路
建模 → 采集 → 串联 → 聚合 → 监控 → 发现 → 诊断 → 反馈
18.6 三个产品观察尺度
Session View(会话视图):看完整用户 / 任务 Journey(交互旅程)
Trace Tree / Timeline(追踪树 / 时间线):看一次执行和性能路径
Agent Graph(智能体协作图):看 Multi-Agent(多智能体)协作关系
18.7 一句话
Agent Observability(Agent 可观测性)的本质,是让每一次 Agent(智能体)行为都可重建、可关联、可度量、可诊断,并最终转化成可以采取行动的生产证据。