性能 - 如何让 Agent 更快而不牺牲质量?
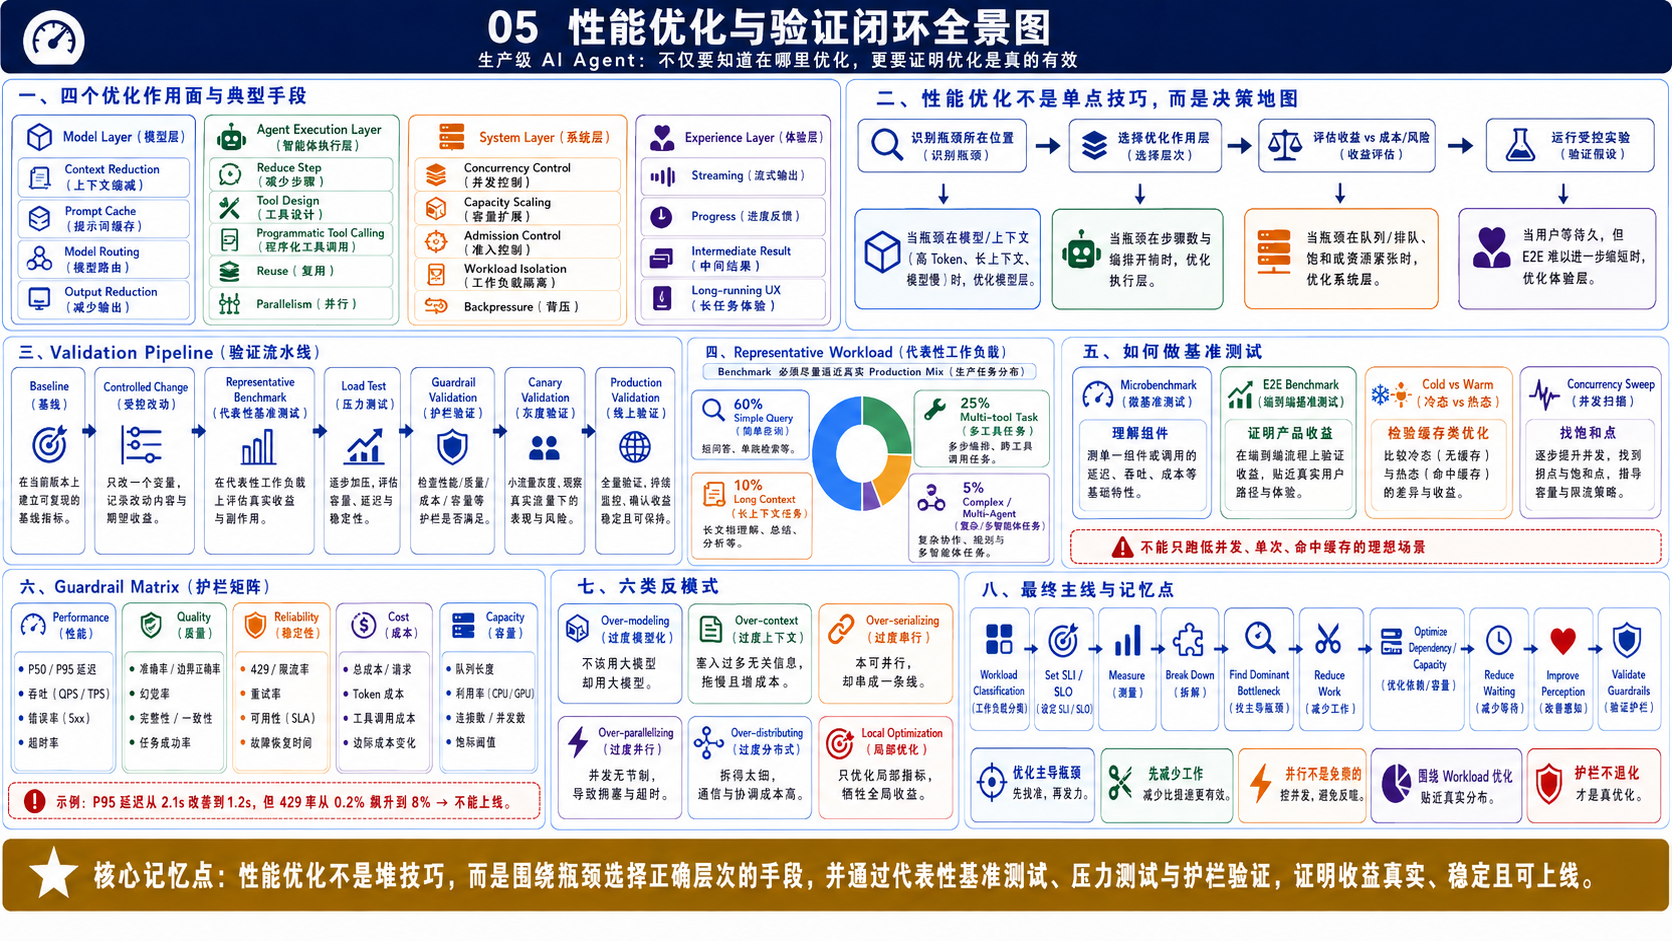
一、Performance Fundamentals(性能基础)
1.1 什么是 Agent Performance(智能体性能)?
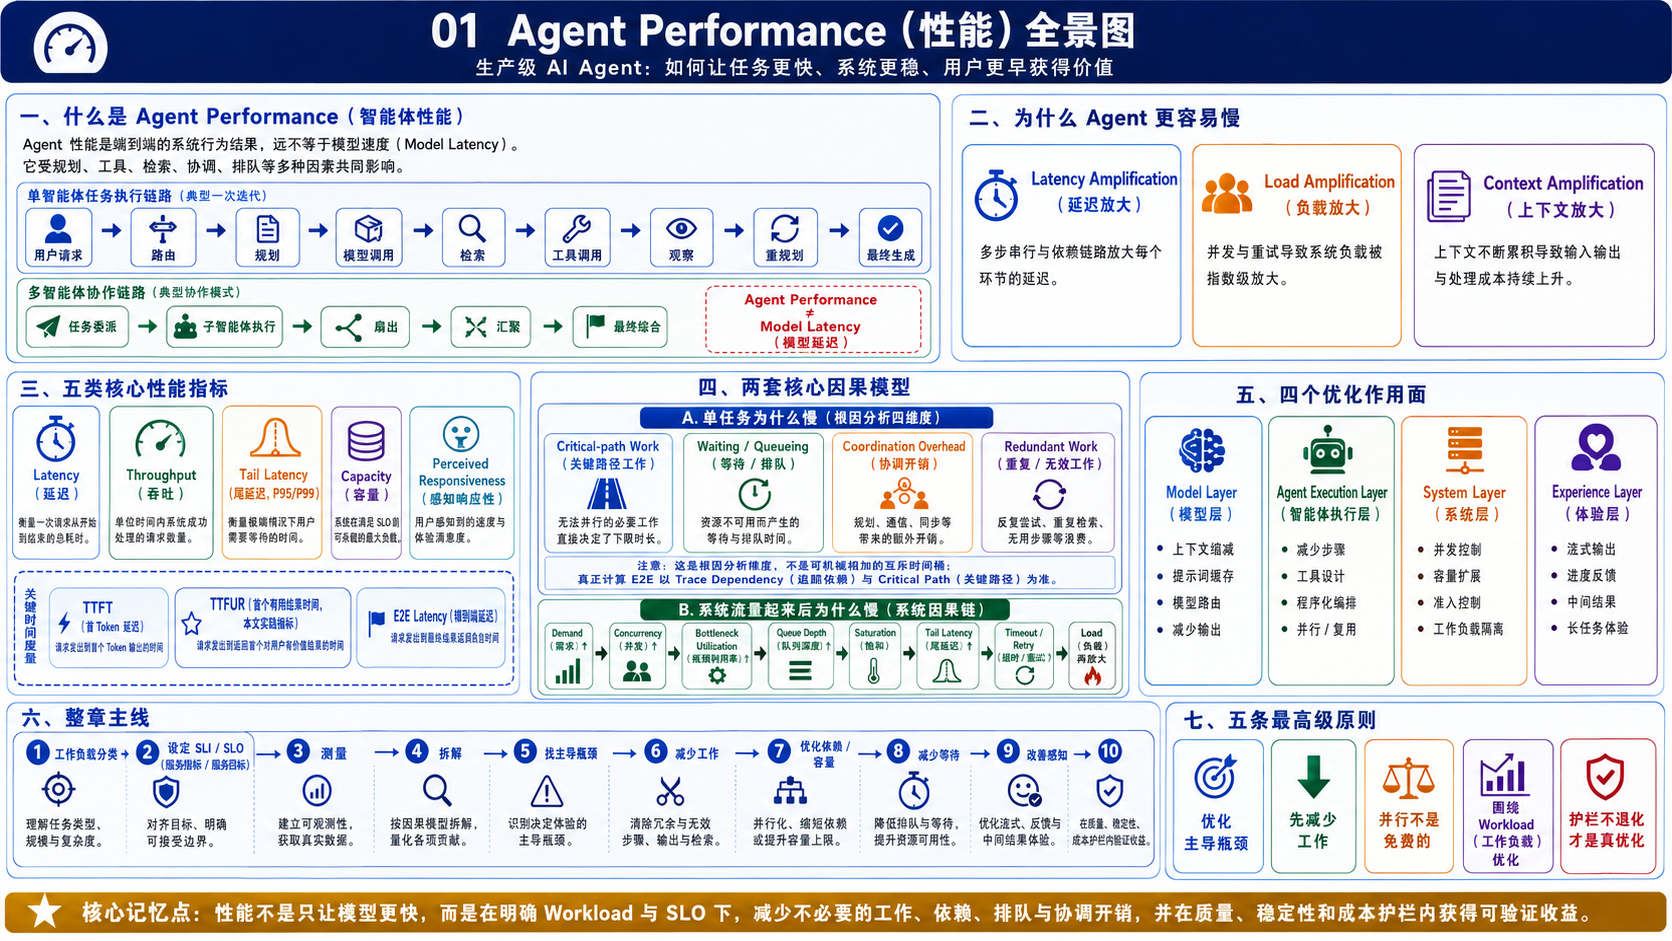
Agent Performance(智能体性能)不是简单衡量“模型生成速度有多快”,而是:
在明确的 Workload(工作负载)和业务约束下,Agent 能否以可预测的速度完成任务、持续承载目标负载,并尽可能早地向用户释放有效价值。
一次真实 Agent Task(智能体任务)可能经过:
User Request(用户请求)
→ Routing(路由)
→ Planning(规划)
→ Model Call(模型调用)
→ Retrieval(检索)
→ Tool Call(工具调用)
→ Observation(观察工具结果)
→ Replanning(重新规划)
→ More Tool Calls(更多工具调用)
→ Final Generation(最终生成)
逐项注释(14)
- User
- User:用户。
- Request
- Request:请求。
- Routing
- Routing:路由:根据条件选择模型、工具或处理路径。
- Planning
- Planning:规划。
- Model
- Model:模型。
- Call
- Call:调用。
- Retrieval
- Retrieval:检索。
- Tool
- Tool:工具。
- Observation
- Observation:观察。
- Replanning
- Replanning:重新规划。
- More
- More:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Calls
- Calls:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Final
- Final:最终的。
- Generation
- Generation:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
如果是 Multi-Agent(多智能体),还可能增加:
Delegation(任务委派)
→ Sub-Agent Execution(子智能体执行)
→ Handoff(任务移交)
→ Fan-out(任务扇出)
→ Fan-in(结果汇聚)
→ Final Synthesis(最终综合)
逐项注释(8)
- Delegation
- Delegation:委派。
- Sub-Agent
- Sub-Agent:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Execution
- Execution:执行。
- Handoff
- Handoff:移交。
- Fan-out
- 扇出:一个上游任务并行分发为多个下游任务。
- Fan-in
- 扇入:多个并行分支在同一节点汇聚。
- Final
- Final:最终的。
- Synthesis
- Synthesis:综合生成。
所以首先要建立一个非常重要的认知:
Agent Performance ≠ Model Latency(模型延迟)。
例如一个 Data Agent(数据智能体)总耗时 10 秒:
Planning(规划)                 1s
Model Call(模型调用)           1s
SQL Tool(SQL 工具)             6s
Queue Wait(排队等待)           1s
Final Answer(最终回答)         1s

E2E Latency(端到端延迟)       10s
逐项注释(11)
- Planning
- Planning:规划。
- s
- s:秒或示例变量 S,依上下文确定。
- Model
- Model:模型。
- Call
- Call:调用。
- SQL
- SQL:结构化查询语言。
- Tool
- Tool:工具。
- Queue
- Queue:队列。
- Wait
- Wait:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Final Answer
- 最终答案:智能体完成执行后呈现给用户的最终输出。
- E2E
- E2E:该纯文本块中的状态、决策或错误枚举值。
- Latency
- Latency:延迟。
如果真正的 Bottleneck(瓶颈)是 SQL Tool,那么即使把模型速度提升 30%,用户感知也可能只改善几百毫秒。
因此生产级 Performance Engineering(性能工程)不是:
找到所有慢的地方并逐个优化。
而是:
找到真正主导业务性能目标的 Bottleneck,并优先消除它。
Agent Performance 至少需要从五类结果维度理解:
- Latency(延迟):一次任务需要多长时间;
- Throughput(吞吐):单位时间能够完成多少任务;
- Tail Latency(尾延迟):P95 / P99 等尾部耗时是否稳定;
- Capacity(容量):满足目标服务质量时能够持续承载多少负载;
- Perceived Responsiveness(用户感知响应性):用户多久第一次获得有价值的反馈。
记忆锚点:
Agent 性能好,不只是“模型快”,而是任务快、系统扛得住、尾部稳定、用户早得到价值。
1.2 为什么 Agent 比普通 API 更容易出现性能问题?
Agent 的一个核心特征是:
一个用户请求会被展开成大量 Model(模型)、Tool(工具)、Sub-Agent(子智能体)和状态操作。
例如:
1 User Request(1 个用户请求)
→ 8 Model Calls(8 次模型调用)
→ 12 Tool Calls(12 次工具调用)
→ 3 Replans(3 次重新规划)
→ 2 Sub-Agents(2 个子智能体)
逐项注释(7)
- User
- User:用户。
- Request
- Request:请求。
- Model
- Model:模型。
- Calls
- Calls:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Tool
- Tool:工具。
- Replans
- Replans:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Sub-Agents
- Sub-Agents:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
因此 Agent 特别容易出现 Amplification Effect(放大效应)。
Latency Amplification(延迟放大)
如果每次 Model Call 平均额外慢 300ms,一个 Agent Task 平均调用模型 10 次:
300ms × 10 ≈ 3s逐项注释(2)
- ms
- ms:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- s
- s:秒或示例变量 S,依上下文确定。
底层一个看起来不大的性能损耗,会被多步执行放大。
Load Amplification(负载放大)
例如:
1 Parent Agent(1 个主智能体)
→ 4 Sub-Agents(4 个子智能体)
→ 每个 Sub-Agent 调用 5 个 Tool(工具)
逐项注释(5)
- Parent
- Parent:父级智能体。
- Agent
- Agent:智能体。
- Sub-Agents
- Sub-Agents:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Sub-Agent
- Sub-Agent:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Tool
- Tool:工具。
那么一个用户请求可能变成:
4 × 5 = 20 个下游 Tool Request(工具请求)逐项注释(2)
- Tool
- Tool:工具。
- Request
- Request:请求。
如果同时有 100 个用户请求:
100 × 20
= 2000 个下游请求
这就是为什么 Agent 平台很容易出现:
用户流量只增长 2 倍,下游流量却增长远超 2 倍。
Context Amplification(上下文放大)
一个大型 Tool Result(工具结果)进入 Context(上下文)以后,后续多个 Model Call 可能反复重新处理它。
例如:
Tool Result(工具结果) = 50KB

Step 3(步骤 3)处理一次
Step 4 又携带一次
Step 5 又携带一次
Step 6 又携带一次
逐项注释(3)
- Tool Result
- 工具结果:外部工具执行后返回的输出。
- KB
- KB:该纯文本块中的状态、决策或错误枚举值。
- Step
- Step:步骤。
于是:
一次 Tool Result 的成本被多个后续步骤反复放大。
因此整章有一个非常重要的原则:
Reduce Work Before Making Work Faster(先减少工作,再让工作更快)。
例如:
方案 A:
10 Steps(10 个步骤)
× 平均 1s
≈ 10s

方案 B:
4 Steps(4 个步骤)
× 平均 1.2s
≈ 4.8s
逐项注释(4)
- A
- A:示例标识 A。
- Steps
- Steps:多个步骤。
- s
- s:秒或示例变量 S,依上下文确定。
- B
- B:示例标识 B。
虽然方案 B 的每一步更慢,整体却快了一倍。
这也是 Agent Performance 与传统单接口微优化最大的差异之一。
二、SLO & Diagnosis(性能目标与诊断)
2.1 Agent 应该看哪些 Performance Metrics(性能指标)?
生产环境不能只看 Average Latency(平均延迟)。
Latency(延迟)
最常见的包括:
- TTFT(Time To First Token,首 Token 延迟)
- Step Latency(步骤延迟)
- E2E Latency(End-to-End Latency,端到端延迟)
Agent 产品还值得增加一个实践指标:
Time to First Useful Result(首个有用结果时间,本文简称 TTFUR)
它和 TTFT 不一样。
例如一个 Data Agent:
0.4s
开始输出“正在分析”

1.8s
第一张有效数据表返回

6.0s
完整分析完成
逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
那么:
TTFT ≈ 0.4s
TTFUR ≈ 1.8s
E2E Latency ≈ 6s
逐项注释(5)
- TTFT
- TTFT:该纯文本块中的状态、决策或错误枚举值。
- s
- s:秒或示例变量 S,依上下文确定。
- TTFUR
- TTFUR:该纯文本块中的状态、决策或错误枚举值。
- E2E
- E2E:该纯文本块中的状态、决策或错误枚举值。
- Latency
- Latency:延迟。
TTFT 回答:
模型什么时候开始输出?
TTFUR 回答:
用户什么时候第一次真正拿到有价值的信息?
E2E Latency 回答:
整个任务什么时候完成?
需要特别说明:
TTFUR 是本文为了 Agent 产品与性能分析采用的实践指标名称,并非与 TTFT 一样高度标准化的行业术语。
Throughput(吞吐)
Throughput 表示:
单位时间系统完成多少 Agent Task。
例如:
20 Tasks / Second
(每秒完成 20 个任务)
逐项注释(2)
- Tasks
- Tasks:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Second
- Second:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
Latency 和 Throughput 不是同一个概念。
一个 Agent Task 平均执行 10 秒,不代表:
系统一定每 10 秒才能完成一个任务。
如果系统能够稳定并发运行 1000 个任务:
Throughput 依然可以很高。
Tail Latency(尾延迟)
生产系统尤其应该关注:
- P50
- P95
- P99
- Distribution(延迟分布)
- Long Tail(长尾)
例如:
Average Latency(平均延迟) = 3s
P95 = 5s
P99 = 30s
逐项注释(5)
- Average
- Average:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Latency
- Latency:延迟。
- s
- s:秒或示例变量 S,依上下文确定。
- P95
- P95:第 95 百分位值。
- P99
- P99:该纯文本块中的状态、决策或错误枚举值。
这意味着:
平均体验很好,但 1% 的请求可能等待约 30 秒。
对于交互型 Agent 来说,这可能已经是严重问题。
Agent 特别容易产生 Tail Latency,因为一次任务可能依赖很多:
- Model
- Tool
- Retrieval(检索)
- Sub-Agent
只要其中一个 Branch(分支)偶发变慢,就可能拖住整个任务。
Capacity(容量)
Capacity 不应该简单理解为:
系统理论最高 QPS。
更准确应该是:
在目标 P95 / P99、错误率和稳定性约束下,系统可以长期持续承载多少 Workload。
例如:
100 QPS 时:

P95 ≤ 5s
P99 ≤ 10s
Error Rate(错误率)≤ 0.5%
逐项注释(6)
- QPS
- QPS:该纯文本块中的状态、决策或错误枚举值。
- P95
- P95:第 95 百分位值。
- s
- s:秒或示例变量 S,依上下文确定。
- P99
- P99:该纯文本块中的状态、决策或错误枚举值。
- Error
- Error:错误。
- Rate
- Rate:比率或速率。
如果达到 120 QPS 后:
P99 = 30s
429 Rate(429 比例)= 5%
逐项注释(3)
- P99
- P99:该纯文本块中的状态、决策或错误枚举值。
- s
- s:秒或示例变量 S,依上下文确定。
- Rate
- Rate:比率或速率。
那么即使系统“还能接请求”,也不能说:
有效 Capacity 是 120 QPS。
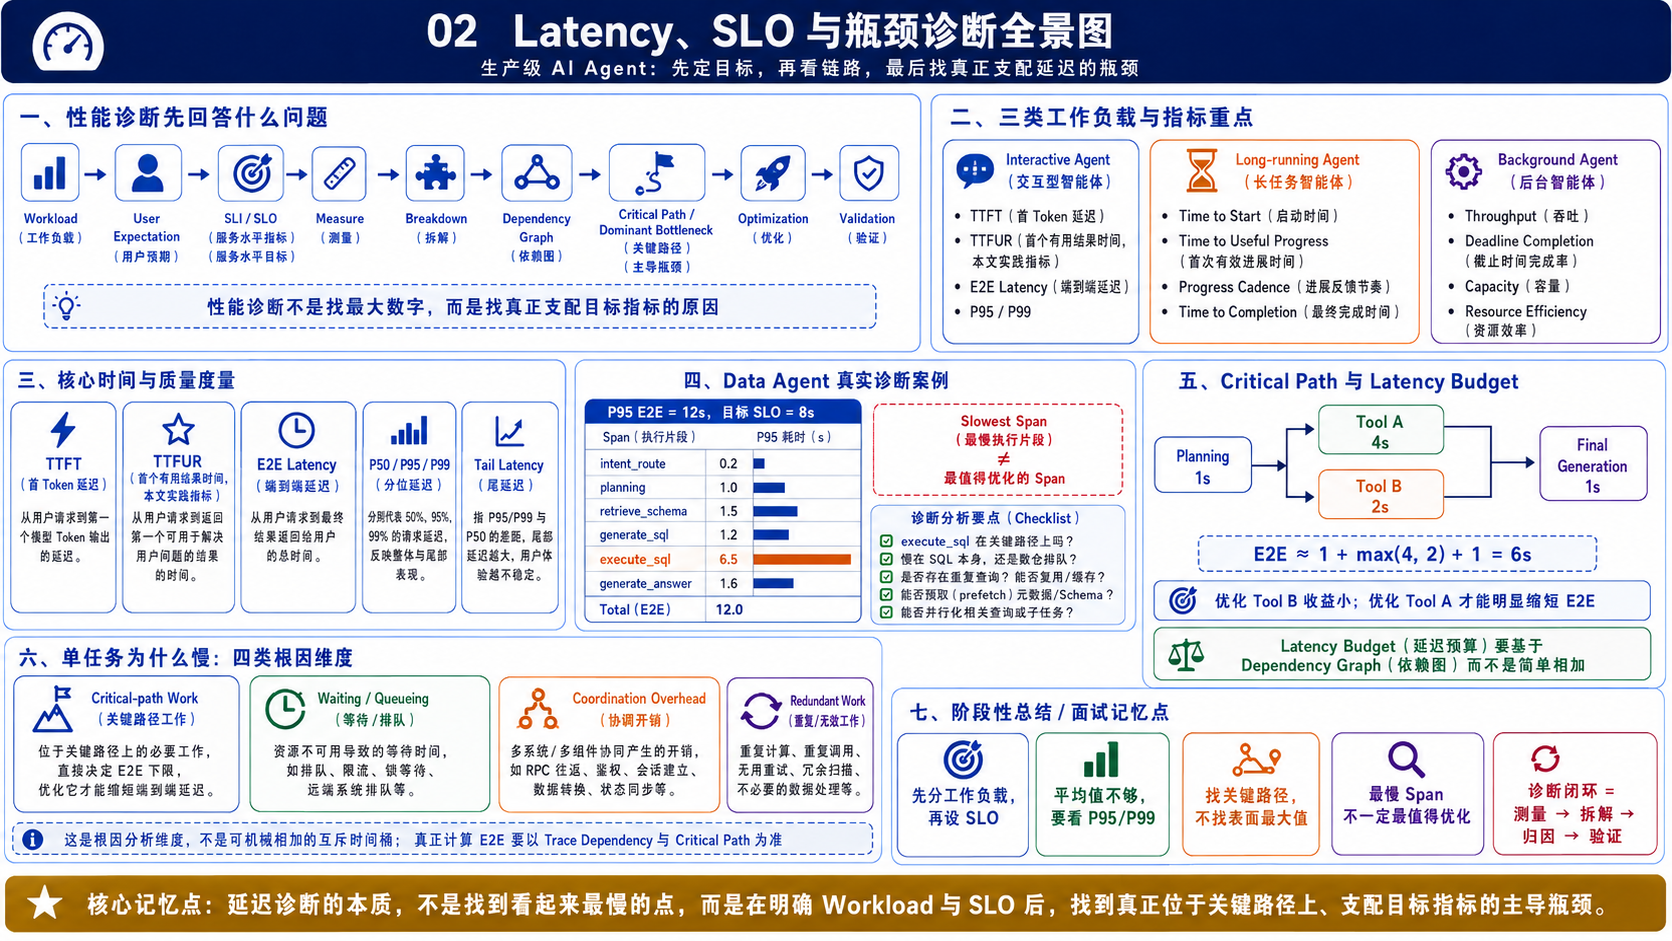
2.2 怎么根据 Workload(工作负载)设计 SLI / SLO?
正确顺序是:
Workload Class(工作负载类型) → User Expectation(用户预期) → SLI(Service Level Indicator,服务水平指标) → SLO(Service Level Objective,服务水平目标) → Performance Budget(性能预算)
不能直接规定:
所有 Agent 都必须 P95 ≤ 5s。
Interactive Agent(交互型智能体)
例如:
- Data Agent
- Customer Support Agent(客服智能体)
用户正在屏幕前等待。
可以使用:
SLI(服务水平指标):

P95 TTFUR
P95 E2E Latency


SLO(服务水平目标):

P95 TTFUR ≤ 2s
P95 E2E Latency ≤ 8s
逐项注释(7)
- SLI
- SLI:服务等级指标:直接度量服务表现。
- P95
- P95:第 95 百分位值。
- TTFUR
- TTFUR:该纯文本块中的状态、决策或错误枚举值。
- E2E
- E2E:该纯文本块中的状态、决策或错误枚举值。
- Latency
- Latency:延迟。
- SLO
- SLO:服务等级目标:为服务等级指标设定的目标。
- s
- s:秒或示例变量 S,依上下文确定。
Long-running Agent(长任务智能体)
例如:
- Coding Agent(编码智能体)
- Deep Research Agent(深度研究智能体)
任务可能运行:
5 分钟、10 分钟甚至几十分钟。
此时 TTFT 已经不足以代表用户体验。
应该更加关注:
- Time to Start(启动时间)
- Time to Useful Progress(首次产生有效进展的时间)
- Progress Cadence(进展反馈节奏)
- Time to Completion(最终完成时间)
Background Agent(后台智能体)
例如:
- Batch Processing(批处理)
- Nightly Analysis(夜间分析)
- Offline Agent(离线智能体)
用户并不实时等待。
重点可能变成:
- Throughput(吞吐)
- Deadline Completion(截止时间完成率)
- Capacity(容量)
- Resource Efficiency(资源效率)
所以:
不存在脱离 Workload 的最佳 Performance SLO。
2.3 一个 Agent 慢了,应该怎么诊断?
不要一上来:
加 Cache、换模型或者开启 Parallelism(并行)。
生产诊断应该按照:
Performance SLO Miss(性能目标未达成)
→ Measure(测量)
→ Breakdown(拆解)
→ Dependency Analysis(依赖分析)
→ Find Dominant Bottleneck(寻找主导瓶颈)
→ Root Cause(定位根因)
→ Intervention(优化干预)
→ Validation(验证)
逐项注释(13)
- Performance
- Performance:性能。
- SLO
- SLO:服务等级目标:为服务等级指标设定的目标。
- Miss
- Miss:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Measure
- Measure:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Breakdown
- Breakdown:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Dependency
- Dependency:依赖。
- Analysis
- Analysis:分析。
- Find
- Find:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Dominant
- Dominant:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Bottleneck
- Bottleneck:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Root Cause
- 根因:能够解释问题发生机制并指导永久修复的底层原因。
- Intervention
- Intervention:人工或系统干预。
- Validation
- Validation:验证。
这里使用:
Dominant Bottleneck(主导瓶颈)
而不是把所有性能问题都等同于 Critical Path(关键路径)。
因为不同目标有不同诊断模型。
单 Task Latency(单任务延迟)问题
重点找:
Critical Path。
Throughput(吞吐)问题
重点找:
Bottleneck Capacity(瓶颈容量)。
Tail Latency(尾延迟)问题
重点找:
- Queue(排队)
- Saturation(饱和)
- Variance(耗时波动)
- Straggler(慢分支)
Case:Data Agent 端到端耗时 12 秒
Trace(追踪):
intent_route(意图路由)          0.2s
planning(规划)                  1.0s
retrieve_schema(检索 Schema)    1.5s
generate_sql(生成 SQL)          1.2s
execute_sql(执行 SQL)           6.5s
generate_answer(生成答案)       1.6s
逐项注释(9)
- intent_route
- intent_route:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- s
- s:秒或示例变量 S,依上下文确定。
- planning
- planning:规划。
- retrieve_schema
- retrieve_schema:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- Schema
- Schema:结构模式。
- generate_sql
- generate_sql:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- SQL
- SQL:结构化查询语言。
- execute_sql
- 函数或工具名:执行传入的 SQL 语句。
- generate_answer
- generate_answer:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
第一眼:
execute_sql最慢。
但不能立即得到:
“数据库就是 Root Cause。”
还应该继续问:
execute_sql是否位于 Critical Path?- 是 SQL 本身慢,还是 Data Warehouse Queue(数据仓库排队)慢?
- 是否存在重复 Query(查询)?
- 是否可以 Reuse(复用)已有结果?
- 是否可以 Cache(缓存)?
- 是否 Tool Design(工具设计)导致一次 Task 调用太多 Query?
- 是否其他并行 Branch 才是真正阻塞最终答案的路径?
性能诊断不是:
找最大的数字。
而是:
找真正支配目标指标的原因。
2.4 Critical Path(关键路径)是什么?
Critical Path 指:
从任务开始到结束,决定最终完成时间的最长依赖路径。
例如:
Planning(规划) 1s
       │
       ├── Tool A(工具 A) 4s
       │
       └── Tool B(工具 B) 2s
       │
Final Generation(最终生成) 1s
逐项注释(7)
- Planning
- Planning:规划。
- s
- s:秒或示例变量 S,依上下文确定。
- Tool
- Tool:工具。
- A
- A:示例标识 A。
- B
- B:示例标识 B。
- Final
- Final:最终的。
- Generation
- Generation:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
如果 A 和 B 可以并行:
E2E
≈ 1 + max(4, 2) + 1
= 6s
逐项注释(3)
- E2E
- E2E:该纯文本块中的状态、决策或错误枚举值。
- max
- max:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- s
- s:秒或示例变量 S,依上下文确定。
优化 Tool B:
2s → 0.5s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
最终仍然:
≈ 6s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
但优化 Tool A:
4s → 2s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
最终可以:
≈ 4s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
所以:
不要优化所有 Slow Span(慢执行片段),优先优化真正位于 Critical Path 上并影响业务指标的 Bottleneck。
Latency Budget(延迟预算)也要基于依赖图
假设:
Tool A = 4s
Tool B = 2s
逐项注释(4)
- Tool
- Tool:工具。
- A
- A:示例标识 A。
- s
- s:秒或示例变量 S,依上下文确定。
- B
- B:示例标识 B。
如果并行执行:
Tool Budget ≠ 4 + 2逐项注释(1)
- Tool Budget
- 工具预算:允许调用工具的次数或成本上限。
真正进入关键路径的是:
max(4, 2) = 4s逐项注释(2)
- max
- max:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- s
- s:秒或示例变量 S,依上下文确定。
因此成熟的 Performance Budget 需要考虑:
- Dependency Graph(依赖图)
- Branch Budget(分支预算)
- Join Deadline(汇合截止时间)
- Critical Branch(关键分支)
一个严谨性边界
前面我们会把单次任务慢的原因理解为:
Critical-path Work(关键路径工作) Waiting / Queueing(等待 / 排队) Coordination Overhead(协调开销) Redundant Work(重复 / 无效工作)
需要注意:
这四类是 Root-cause Dimensions(根因分析维度),不是四个可以机械相加、互相完全独立的“时间桶”。
例如一次远程 Agent 调用耗时 3 秒:
Remote Agent Call(远程智能体调用) 3s

其中:

Network Wait(网络等待) 0.5s
Remote Queue(远端排队) 1.0s
Remote Execution(远端执行) 1.5s
逐项注释(8)
- Remote
- Remote:远程的。
- Agent
- Agent:智能体。
- Call
- Call:调用。
- s
- s:秒或示例变量 S,依上下文确定。
- Network
- Network:网络。
- Wait
- Wait:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Queue
- Queue:队列。
- Execution
- Execution:执行。
不能一边把 3 秒全部算作 Coordination Overhead,又额外把 Queue 1 秒重新相加。
真正计算 E2E Latency 时:
以 Trace Dependency(追踪依赖关系)和 Critical Path 为准。
三、Execution Efficiency(执行效率)
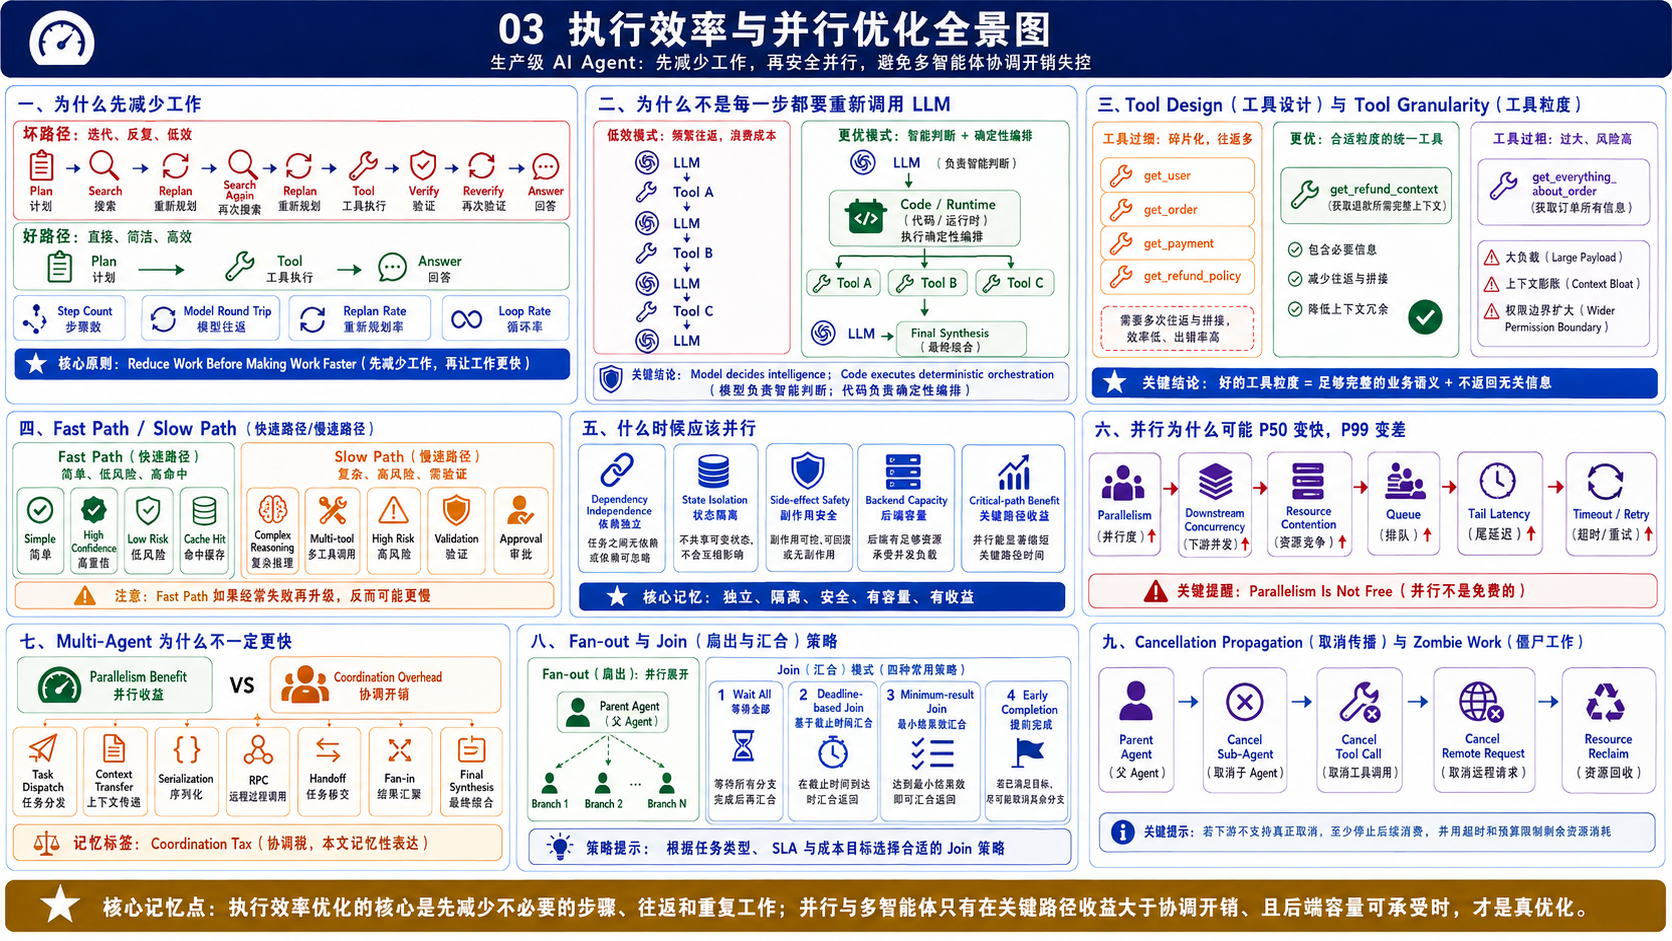
3.1 为什么 Step Count(步骤数量)这么重要?
Agent 经常不是某一步特别慢,而是:
走了太多没有必要的步骤。
例如:
Bad Path(低效路径)

Plan(规划)
→ Search(搜索)
→ Replan(重新规划)
→ Search Again(重复搜索)
→ Replan
→ Tool(工具调用)
→ Verify(验证)
→ Reverify(重复验证)
→ Answer(回答)
逐项注释(10)
- Bad
- Bad:不良或失败的。
- Path
- Path:路径。
- Plan
- Plan:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Search
- Search:搜索。
- Replan
- Replan:重新规划。
- Again
- Again:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Tool
- Tool:工具。
- Verify
- Verify:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Reverify
- Reverify:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Answer
- Answer:答案。
优化为:
Better Path(更优路径)

Plan(规划)
→ Tool(工具调用)
→ Answer(回答)
逐项注释(5)
- Better
- Better:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Path
- Path:路径。
- Plan
- Plan:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Tool
- Tool:工具。
- Answer
- Answer:答案。
即使每一个步骤的耗时完全不变:
E2E Latency 仍然可能下降一半以上。
所以应该监控:
- Steps per Task(单任务步骤数)
- Model Calls per Task(单任务模型调用数)
- Tool Calls per Task(单任务工具调用数)
- Replan Rate(重新规划率)
- Loop Rate(循环率)
例如:
优化前:

9.2 Steps / Task(每任务平均 9.2 步)
P95 E2E = 11s


优化后:

5.1 Steps / Task
P95 E2E = 7s
逐项注释(5)
- Steps
- Steps:多个步骤。
- Task
- Task:任务。
- P95
- P95:第 95 百分位值。
- E2E
- E2E:该纯文本块中的状态、决策或错误枚举值。
- s
- s:秒或示例变量 S,依上下文确定。
这就是非常典型的 Agent Performance Optimization。
真实经验:
少一次 2 秒的 LLM Call,通常比把一个 300ms Tool 优化到 150ms 更值得。
3.2 为什么不是每一步都应该调用 LLM?
典型 Tool-heavy Workflow(工具密集型工作流):
LLM(大语言模型)
→ Tool A(工具 A)
→ LLM
→ Tool B
→ LLM
→ Tool C
→ LLM
→ Final Answer(最终答案)
逐项注释(6)
- LLM
- LLM:大型语言模型。
- Tool
- Tool:工具。
- A
- A:示例标识 A。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
- Final Answer
- 最终答案:智能体完成执行后呈现给用户的最终输出。
如果 A → B → C 的顺序已经确定:
中间每一次重新进入 LLM 都会产生额外 Model Round Trip(模型往返)。
更合理:
LLM(负责智能判断)
↓
生成确定性执行计划
↓
Code / Runtime(代码 / 运行时)
├─ Tool A
├─ Tool B
└─ Tool C
↓
LLM
↓
Final Synthesis(最终综合)
逐项注释(9)
- LLM
- LLM:大型语言模型。
- Code
- Code:代码。
- Runtime
- Runtime:运行时系统。
- Tool
- Tool:工具。
- A
- A:示例标识 A。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
- Final
- Final:最终的。
- Synthesis
- Synthesis:综合生成。
核心原则:
Model decides intelligence(模型负责智能判断);Code executes deterministic orchestration(代码负责确定性编排)。
这样通常可以减少:
- Model Round Trip(模型往返)
- Token
- Context Growth(上下文增长)
- Latency
但不能极端化。
如果:
Tool A Result(工具 A 结果)
↓
需要新的语义判断
↓
才能决定 Tool B 还是 Tool C
逐项注释(5)
- Tool
- Tool:工具。
- A
- A:示例标识 A。
- Result
- Result:结果。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
那就依然需要 Model Replanning(模型重新规划)。
所以真正判断标准不是:
工具数量多不多。
而是:
中间决策是否具有确定性。
3.3 Tool Design(工具设计)为什么影响性能?
Tool Granularity(工具粒度)过细时:
get_user(获取用户)
get_order(获取订单)
get_payment(获取支付)
get_refund_policy(获取退款规则)
逐项注释(4)
- get_user
- get_user:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- get_order
- 函数或工具名:读取订单信息。
- get_payment
- get_payment:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- get_refund_policy
- get_refund_policy:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
一次退款决策可能需要:
四次 Tool Round Trip(工具往返)。
如果这些信息通常是完整业务上下文的一部分,可以设计:
get_refund_context(获取退款完整上下文)逐项注释(1)
- get_refund_context
- get_refund_context:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
一次返回:
- User(用户)
- Order(订单)
- Payment(支付)
- Policy(退款规则)
这样可以减少往返。
但 Tool 不是越粗越好。
例如:
get_everything_about_order
(获取订单所有相关信息)
逐项注释(1)
- get_everything_about_order
- get_everything_about_order:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
一次返回几百 KB。
虽然 Tool Call 数量下降:
4 → 1
却可能导致:
- Payload(载荷)巨大
- Network Latency(网络延迟)上升
- Context Bloat(上下文膨胀)
- 后续 Model Call Prefill(模型预填充)变慢
- Permission Boundary(权限边界)过宽
所以:
优秀的 Tool Granularity 是一次调用提供足够完整的业务语义,但不返回当前任务根本不需要的信息。
3.4 Fast Path / Slow Path(快速路径 / 慢速路径)怎么设计?
生产 Agent 不应该:
所有 Task 都运行同一个 Heavy Workflow(重型工作流)。
例如客服 Agent:
问题 A:
“如何修改手机号?”

问题 B:
“这个订单跨两个支付渠道退款失败,
而且订单状态与支付状态已经不一致。”
逐项注释(2)
- A
- A:示例标识 A。
- B
- B:示例标识 B。
显然不是同一复杂度。
Fast Path(快速路径)
适合:
- Simple(简单)
- High Confidence(高置信)
- Low Risk(低风险)
- Cache Hit(缓存命中)
例如:
FAQ(常见问题)
→ Retrieval(检索)
→ Fast Model(快速模型)
→ Answer(回答)
逐项注释(5)
- FAQ
- FAQ:该纯文本块中的状态、决策或错误枚举值。
- Retrieval
- Retrieval:检索。
- Fast
- Fast:快速。
- Model
- Model:模型。
- Answer
- Answer:答案。
Slow Path(慢速路径)
适合:
- Complex Reasoning(复杂推理)
- Multi-tool(多工具)
- Low Confidence(低置信)
- High Risk(高风险)
例如:
Full Planning(完整规划)
→ Multiple Tools(多个工具)
→ Validation(验证)
→ Approval(审批)
逐项注释(6)
- Full
- Full:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Planning
- Planning:规划。
- Multiple
- Multiple:多个。
- Tools
- Tools:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Validation
- Validation:验证。
- Approval
- Approval:审批。
本质:
不要让简单任务为复杂 Agent 的全部能力成本买单。
但 Fast Path 本身也可能成为负优化。
例如:
Fast Model(快速模型) 1s
→ 判断失败
→ Escalate(升级)
→ Strong Model(强模型) 4s

最终 ≈ 5s
逐项注释(5)
- Fast
- Fast:快速。
- Model
- Model:模型。
- s
- s:秒或示例变量 S,依上下文确定。
- Escalate
- Escalate:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Strong
- Strong:强等级。
而直接 Strong Model:
4s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
反而更快。
所以 Fast / Slow Path 应该验证:
- Route Accuracy(路由准确率)
- Fast-path Success Rate(快速路径成功率)
- Escalation Rate(升级率)
- E2E Latency
- Task Success(任务成功率)
- Cost(成本)
四、Parallelism & Multi-Agent(并行与多智能体)
4.1 什么时候应该并行?
并行的目标不是:
最大化 Parallelism(并行度)。
而是:
在可接受的风险和系统压力下缩短 Critical Path。
可以记住五个条件:
独立、隔离、安全、有容量、有收益。
Dependency Independence(依赖独立)
如果:
Tool B Input(工具 B 输入)
=
Tool A Output(工具 A 输出)
逐项注释(5)
- Tool
- Tool:工具。
- B
- B:示例标识 B。
- Input
- Input:输入。
- A
- A:示例标识 A。
- Output
- Output:输出。
则:
A → B 必须串行。
State Isolation(状态隔离)
两个并行 Task 是否会同时修改同一 State(状态)?
如果两个 Stateful Sub-Agent(有状态子智能体)同时更新同一个 Checkpoint(检查点):
可能产生 State Conflict(状态冲突)。
Side-effect Safety(副作用安全)
例如:
Tool A:Refund(退款)
Tool B:Close Order(关闭订单)
逐项注释(6)
- Tool
- Tool:工具。
- A
- A:示例标识 A。
- Refund
- Refund:退款。
- B
- B:示例标识 B。
- Close
- Close:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Order
- Order:订单或顺序,依上下文确定。
即使技术依赖独立:
业务状态转换也可能要求严格顺序。
Backend Capacity(后端容量)
一个 Data Agent 并行:
Query Sales(查询销售)
Query Inventory(查询库存)
Query Marketing(查询营销)
逐项注释(4)
- Query
- Query:查询。
- Sales
- Sales:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Inventory
- Inventory:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Marketing
- Marketing:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
单请求可能从:
6s → 2.5s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
效果很好。
但如果 1000 个 Task 同时运行:
3 × 1000
= 3000 个下游查询
可能直接打满数据库或外部 API。
Critical-path Benefit(关键路径收益)
即使技术上可以并行:
也要确认并行之后真的影响用户关心的指标。
如果任务不需要等待某两个 Branch:
并行它们可能没有任何 E2E 收益。
4.2 为什么 P50 变快,P99 却可能变慢?
理想情况:
串行:

A 2s
→ B 3s
→ C 2s

≈ 7s
逐项注释(4)
- A
- A:示例标识 A。
- s
- s:秒或示例变量 S,依上下文确定。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
并行:
A 2s ┐
B 3s ├→ Join(汇合)
C 2s ┘

≈ 3s
逐项注释(5)
- A
- A:示例标识 A。
- s
- s:秒或示例变量 S,依上下文确定。
- B
- B:示例标识 B。
- Join
- Join:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- C
- C:示例标识 C。
但是生产系统可能变成:
Parallelism(并行度)↑
→ Downstream Concurrency(下游并发)↑
→ Resource Contention(资源竞争)↑
→ Queue(排队)↑
→ Tail Latency(尾延迟)↑
→ Timeout(超时)↑
→ Retry(重试)↑
→ Load(负载)继续增加
逐项注释(11)
- Parallelism
- Parallelism:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Downstream
- Downstream:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Concurrency
- Concurrency:并发:多个任务同时推进。
- Resource
- Resource:资源。
- Contention
- Contention:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Queue
- Queue:队列。
- Tail
- Tail:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Latency
- Latency:延迟。
- Timeout
- 超时:单次操作允许等待的最长时长。
- Retry
- 重试:失败后再次执行同一操作。
- Load
- Load:负载。
于是:
P50 ↓
P95 ↓

但:

P99 ↑
429 ↑
Timeout ↑
逐项注释(4)
- P50
- P50:该纯文本块中的状态、决策或错误枚举值。
- P95
- P95:第 95 百分位值。
- P99
- P99:该纯文本块中的状态、决策或错误枚举值。
- Timeout
- 超时:单次操作允许等待的最长时长。
所以:
Parallelism Is Not Free(并行不是免费的)。
每次 Parallelism Optimization(并行优化)至少应该同时观察:
- P50 / P95 / P99
- Tool Backend Utilization(工具后端利用率)
- Queue Depth(队列深度)
- 429
- Timeout
- Task Success
- Cost
4.3 Multi-Agent 为什么可能比 Single-Agent 更慢?
Multi-Agent 的总耗时并不是简单:
max(A, B, C)逐项注释(4)
- max
- max:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- A
- A:示例标识 A。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
因为还需要支付:
- Task Dispatch(任务分发)
- Context Transfer(上下文传递)
- Serialization(序列化)
- RPC(Remote Procedure Call,远程过程调用)
- Handoff(任务移交)
- Fan-in(结果汇聚)
- Final Synthesis(最终综合)
这些属于:
Coordination Overhead(协调开销)
也可以用一个便于记忆的表达:
Coordination Tax(协调税,本文的记忆性表达,并非统一行业标准术语)
真正判断应该是:
Parallelism Benefit(并行收益) > Coordination Overhead(协调开销)
Multi-Agent 才有性能意义。
例如:
Manager Planning(管理 Agent 规划) 1s

├─ Market Agent(市场 Agent)       4s
├─ Competitor Agent(竞品 Agent)   5s
└─ Finance Agent(财务 Agent)      4s

Fan-in + Synthesis(汇聚 + 综合)   2s
逐项注释(9)
- Manager
- Manager:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Planning
- Planning:规划。
- Agent
- Agent:智能体。
- s
- s:秒或示例变量 S,依上下文确定。
- Market
- Market:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Competitor
- Competitor:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Finance
- Finance:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Fan-in
- 扇入:多个并行分支在同一节点汇聚。
- Synthesis
- Synthesis:综合生成。
总耗时约:
1 + max(4,5,4) + 2
= 8s
逐项注释(2)
- max
- max:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- s
- s:秒或示例变量 S,依上下文确定。
如果 Single-Agent 串行需要:
12s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
Multi-Agent 有明显收益。
但如果三个 Sub-Agent 每个只需要:
0.5s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
而:
Dispatch + Handoff + Fan-in
= 3s
逐项注释(4)
- Dispatch
- Dispatch:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Handoff
- Handoff:移交。
- Fan-in
- 扇入:多个并行分支在同一节点汇聚。
- s
- s:秒或示例变量 S,依上下文确定。
Multi-Agent 可能明显更慢。
4.4 Fan-out 后一定要等待全部结果吗?
不一定。
Wait All(等待全部)
优点:
信息最完整。
缺点:
被最慢 Straggler(慢分支)拖住。
Deadline-based Join(基于截止时间的汇合)
例如:
最多等待 5s

超过 Deadline(截止时间)的分支:
不再阻塞最终结果
逐项注释(2)
- s
- s:秒或示例变量 S,依上下文确定。
- Deadline
- 截止时间:整个请求或任务必须完成的绝对时间边界。
Minimum-result Join(满足最小结果数后汇合)
例如:
5 个 Research Agent

完成 4 个
即可继续 Synthesis(综合)
逐项注释(3)
- Research
- Research:研究。
- Agent
- Agent:智能体。
- Synthesis
- Synthesis:综合生成。
Early Completion(提前完成)
如果已经满足 Completion Criteria(完成条件):
可以提前结束等待。
但不能因为:
“已经等太久。”
就直接完成。
应该依据:
- Evidence Coverage(证据覆盖度)
- Business Requirement(业务要求)
- Confidence(置信度)
- Quality Guardrail(质量护栏)
Early Completion 后还要处理剩余任务
这一步非常容易被忽略。
如果:
A ✅
B ✅
C ✅
D ✅

E 仍在运行……
逐项注释(5)
- A
- A:示例标识 A。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
- D
- D:该流程或对比中的示例节点标识。
- E
- E:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
系统已经返回最终结果,却让 E 继续执行:
用户 Latency 是降低了,但后台资源仍然被占用。
因此对于支持取消的 Runtime / Tool,应传播:
Cancellation Propagation(取消传播)
例如:
Parent Agent(主智能体)
→ Cancel Sub-Agent(取消子智能体)
→ Cancel Tool Call(取消工具调用)
→ Cancel Remote Request(取消远程请求)
→ Resource Reclaim(资源回收)
逐项注释(10)
- Parent
- Parent:父级智能体。
- Agent
- Agent:智能体。
- Cancel
- Cancel:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Sub-Agent
- Sub-Agent:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Tool
- Tool:工具。
- Call
- Call:调用。
- Remote
- Remote:远程的。
- Request
- Request:请求。
- Resource
- Resource:资源。
- Reclaim
- Reclaim:重新接管。
如果某个外部 Tool / API 不支持真正取消:
不能假装调用 Cancel 就一定已经停止底层执行。
这时至少应该:
- 停止后续消费结果;
- 不再启动新的下游工作;
- 使用 Timeout(超时)限制;
- 使用 Budget(预算)限制;
- 让下游执行尽快自然结束。
这种已经没有业务价值但仍然持续占用资源的执行,可以理解为:
Zombie Work(僵尸工作)。
五、Context、Cache & Routing(上下文、缓存与路由)
5.1 Context 为什么会拖慢 Agent?
典型长会话:
Turn 1(第 1 轮)   10K Tokens
Turn 5(第 5 轮)   40K Tokens
Turn 10(第 10 轮) 100K Tokens
逐项注释(3)
- Turn
- Turn:轮次。
- K
- k:数量参数;在检索语境中通常表示返回的 Top-K 条目数。
- Tokens
- Tokens:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
Context 越大,通常意味着:
- Prefill Latency(预填充延迟)增加;
- Token Cost(Token 成本)增加;
- Tool Selection Difficulty(工具选择难度)增加;
- Attention Dilution(注意力稀释)风险增加。
Context Bloat(上下文膨胀)的常见来源:
- 完整 Conversation History(会话历史)
- 全部 Tool Schema(工具定义结构)
- 大量原始 Tool Result(工具结果)
- Workspace Context(工作区上下文)
- 重复 Prompt(提示词)
这里统一使用:
Tool Schema(工具定义结构)
表示模型看到的 Tool 名称、描述、参数结构等 Tool 定义,而不是含义模糊的“工具模式”。
核心原则:
Only Load What This Step Needs(每一步只加载当前真正需要的信息)。
常见方法:
- Trimming(裁剪)
- Summarization(摘要)
- Windowing(窗口化)
- Retrieval on Demand(按需检索)
- Dynamic Tool Loading(动态工具加载)
Tool Search(工具搜索)什么时候值得?
如果只有:
5 个 Tool(工具)逐项注释(1)
- Tool
- Tool:工具。
全部 Tool Schema 直接加载可能最简单、最快。
如果平台已经有:
100+
500+
甚至更多 Tool
逐项注释(1)
- Tool
- Tool:工具。
把所有 Tool Schema 永久放入 Context 会导致:
Context Bloat。
此时可以:
Tool Search(工具搜索)
→ Search Relevant Tools(搜索相关工具)
→ Load Selected Tool Schemas(只加载命中的工具定义)
逐项注释(7)
- Tool
- Tool:工具。
- Search
- Search:搜索。
- Relevant
- Relevant:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Tools
- Tools:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Load
- Load:负载。
- Selected
- Selected:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Schemas
- Schemas:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
但是 Tool Search 自己增加了:
Search Step(搜索步骤)。
所以:
Optimization Gain(优化收益)必须大于 Optimization Overhead(优化额外开销)。
不要把:
Tool Search
当成所有 Agent 的固定最佳实践。
5.2 Cache 怎么做才有净收益?
Cache(缓存)的目标不是:
架构里出现 Redis 或 Cache Layer(缓存层)。
真正目标是:
避免 Critical Path 上可以复用的重复工作。
常见包括:
- Prompt Cache(提示词缓存)
- Retrieval Cache(检索缓存)
- Tool Result Cache(工具结果缓存)
- Intermediate Result Reuse(中间结果复用)
例如 Multi-Agent:
错误:

Agent A → Query Order(查询订单)
Agent B → Query Order
Agent C → Query Order
逐项注释(6)
- Agent
- Agent:智能体。
- A
- A:示例标识 A。
- Query
- Query:查询。
- Order
- Order:订单或顺序,依上下文确定。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
可以变成:
Query Order Once(只查询一次订单)
↓
Shared Order Context(共享订单上下文)
↓
Agent A
Agent B
Agent C
逐项注释(9)
- Query
- Query:查询。
- Order
- Order:订单或顺序,依上下文确定。
- Once
- Once:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Shared
- Shared:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Context
- Context:上下文。
- Agent
- Agent:智能体。
- A
- A:示例标识 A。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
判断一个结果是否适合缓存,至少看:
- Cacheability(可缓存性)
- Hit Rate(缓存命中率)
- Lookup Overhead(缓存查询开销)
- Write Overhead(缓存写入开销)
- Freshness Requirement(数据新鲜度要求)
- Permission Boundary(权限边界)
- Version Dependence(版本依赖)
例如:
用户余额、权限状态、高风险订单状态
往往不能因为追求性能:
长时间复用旧值。
Prompt Cache 的典型坑
系统已经接入 Prompt Cache。
但每一次 Prompt Prefix(提示词前缀)都不同:
Request A Prefix ≠ Request B Prefix逐项注释(4)
- Request
- Request:请求。
- A
- A:示例标识 A。
- Prefix
- Prefix:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- B
- B:示例标识 B。
结果:
Hit Rate(缓存命中率)≈ 0逐项注释(2)
- Hit
- Hit:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Rate
- Rate:比率或速率。
于是:
- Cache Infrastructure(缓存基础设施)有了;
- 复杂度增加了;
- 性能收益却几乎没有。
所以 Cache Optimization(缓存优化)必须验证:
Hit Rate(命中率)
Saved Latency(节省延迟)
Freshness Error(陈旧数据错误)
Net Cost(净成本)
逐项注释(8)
- Hit
- Hit:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Rate
- Rate:比率或速率。
- Saved
- Saved:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Latency
- Latency:延迟。
- Freshness
- Freshness:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Error
- Error:错误。
- Net
- Net:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Cost
- Cost:成本。
而不是:
“加了缓存,所以性能一定更好了。”
5.3 Model Routing(模型路由)怎么优化性能?
不同 Agent Step 不需要使用相同模型。
例如 Data Agent:
Metric Intent Classification(指标意图分类)
→ Fast Model(快速模型)

SQL Planning(SQL 规划)
→ Strong Reasoning Model(强推理模型)

Result Formatting(结果格式化)
→ Code / Fast Model(代码 / 快速模型)
逐项注释(12)
- Metric
- Metric:指标。
- Intent
- Intent:意图。
- Classification
- Classification:分类。
- Fast
- Fast:快速。
- Model
- Model:模型。
- SQL
- SQL:结构化查询语言。
- Planning
- Planning:规划。
- Strong
- Strong:强等级。
- Reasoning
- Reasoning:推理。
- Result
- Result:结果。
- Formatting
- Formatting:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Code
- Code:代码。
更成熟的设计通常是:
Routing + Escalation(路由 + 升级)
例如:
Fast Model(快速模型)
↓
Confidence Enough?(置信度是否足够?)
├─ Yes(是)
│   → Continue(继续)
│
└─ No(否)
    → Escalate to Strong Model(升级到强模型)
逐项注释(10)
- Fast
- Fast:快速。
- Model
- Model:模型。
- Confidence
- Confidence:置信度。
- Enough
- Enough:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Yes
- Yes:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Continue
- Continue:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- No
- No:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Escalate
- Escalate:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- to
- to:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Strong
- Strong:强等级。
真正应该监控:
- Routing Accuracy(路由准确率)
- Escalation Rate(升级率)
- Task Success(任务成功率)
- E2E Latency
- Cost
典型反例:
Fast Model 1s
→ Fail(失败)
→ Escalate(升级)
→ Strong Model 4s

总耗时 ≈ 5s
逐项注释(6)
- Fast
- Fast:快速。
- Model
- Model:模型。
- s
- s:秒或示例变量 S,依上下文确定。
- Fail
- Fail:失败状态。
- Escalate
- Escalate:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Strong
- Strong:强等级。
而直接 Strong Model:
≈ 4s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
所以:
Model Routing 的目标不是把尽可能多的请求送给小模型,而是把正确的任务送给正确的模型。
六、Streaming & Long-running UX(流式与长任务体验)
6.1 Streaming(流式输出)到底优化什么?
常见误区:
开启 Streaming 后,Agent 就变快了。
很多时候实际上:
方案 A:

0s ─────────────── 8s
      无反馈           完整答案
逐项注释(2)
- A
- A:示例标识 A。
- s
- s:秒或示例变量 S,依上下文确定。
方案 B:
0.5s
开始响应

2s
第一张结果表

5s
阶段性分析

8s
最终答案
逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
两者:
E2E Latency = 8s逐项注释(3)
- E2E
- E2E:该纯文本块中的状态、决策或错误枚举值。
- Latency
- Latency:延迟。
- s
- s:秒或示例变量 S,依上下文确定。
但方案 B 的:
Perceived Latency(用户感知延迟)
显著更好。
Agent Streaming 可以包括:
- Token Streaming(Token 流式输出)
- Progress Streaming(进度流)
- Intermediate Result Streaming(中间结果流)
- Agent Event Streaming(智能体事件流)
所以:
Streaming 主要优化“价值什么时候到达用户”,不一定优化任务什么时候真正完成。
6.2 Long-running Agent 怎么优化等待体验?
Coding Agent 可能运行:
15 分钟用户不应该:
第 15 分钟第一次获得有效反馈。
更好的体验:
0.5s
Task Accepted(任务已接收)

3s
Relevant Files Found(已定位相关文件)

30s
Possible Root Cause Found(发现可能根因)

2min
Patch Generated(补丁已生成)

5min
Tests 6 / 10 Passed(10 项测试通过 6 项)

8min
One Test Failed, Fixing
(一个测试失败,正在修复)

15min
Completed(任务完成)
逐项注释(18)
- s
- s:秒或示例变量 S,依上下文确定。
- Task
- Task:任务。
- Accepted
- Accepted:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Relevant
- Relevant:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Files
- Files:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Found
- Found:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Possible
- Possible:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Root Cause
- 根因:能够解释问题发生机制并指导永久修复的底层原因。
- min
- min:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Patch
- Patch:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Generated
- Generated:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Tests
- Tests:多项测试。
- Passed
- Passed:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- One
- One:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Test
- Test:测试。
- Failed
- Failed:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Fixing
- Fixing:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Completed
- Completed:已完成状态。
因此 Long-running Agent 更应该关注:
- Time to Start(启动时间)
- Time to Useful Progress(首次有效进展时间)
- Progress Cadence(进展反馈节奏)
- Time to Completion(最终完成时间)
核心认知:
长任务性能不仅是减少最终完成时间,还包括减少“长时间没有任何有效反馈”的空白。
七、Throughput、Queue & Capacity(吞吐、排队与容量)
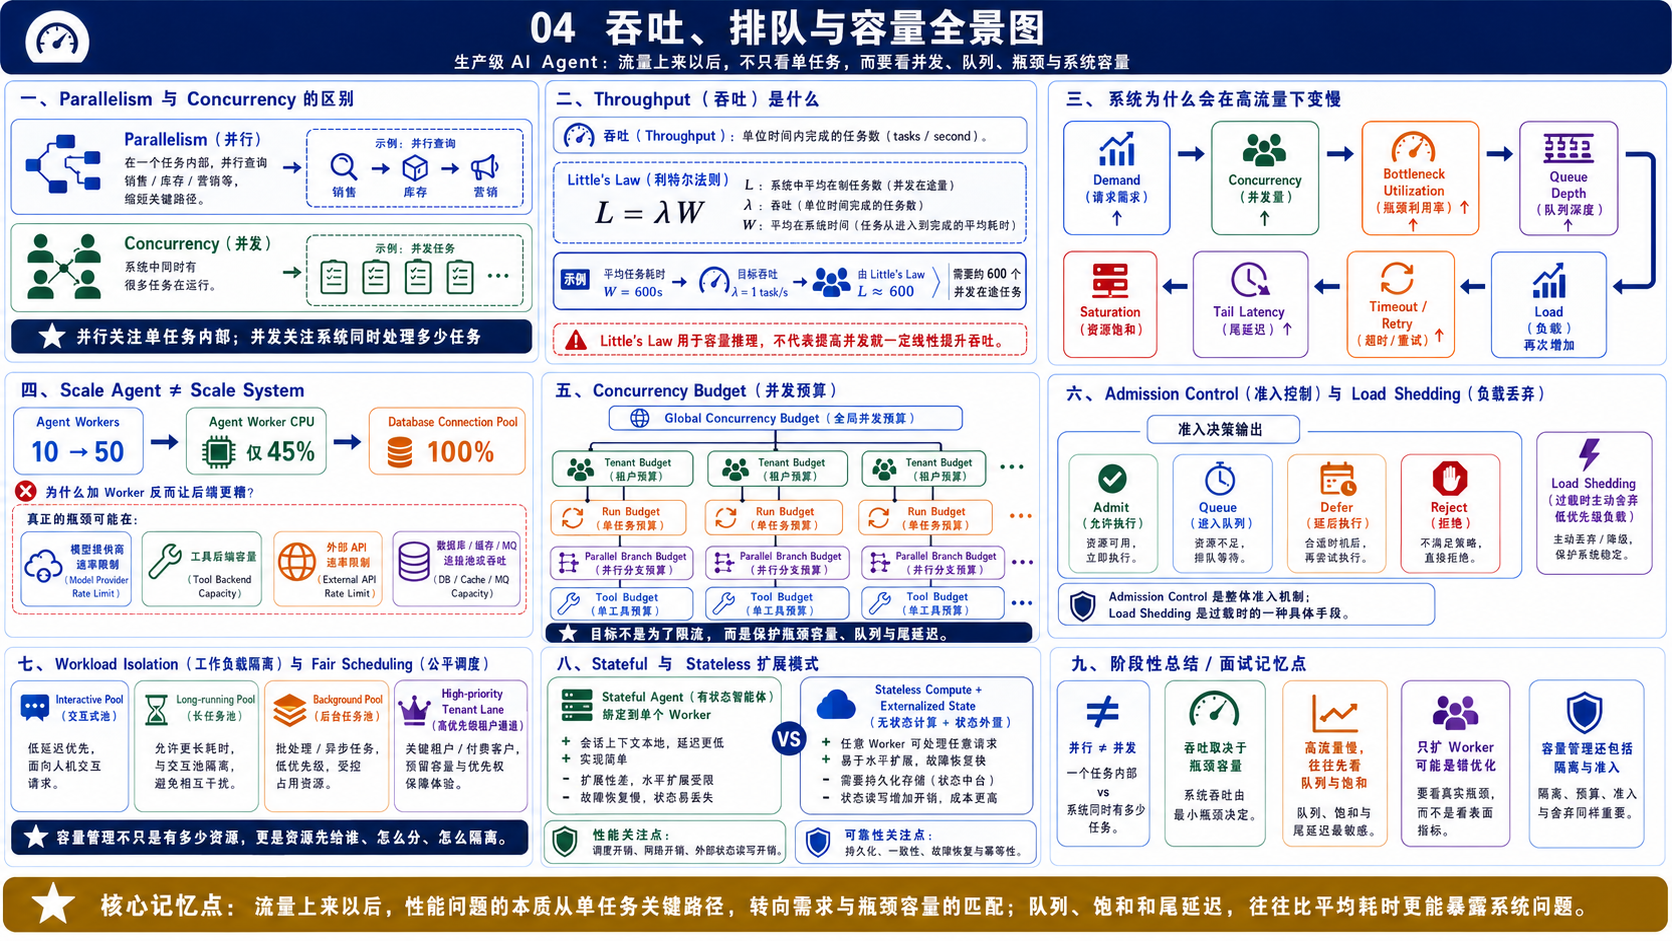
7.1 Concurrency(并发)和 Parallelism(并行)有什么区别?
这是必须严格区分的基础概念。
Parallelism(并行)
关注:
一个 Task 内部同时执行多少工作。
例如:
Data Agent Task(数据智能体任务)

├─ Query Sales(查询销售)
├─ Query Inventory(查询库存)
└─ Query Marketing(查询营销)
逐项注释(7)
- Data
- Data:数据。
- Agent
- Agent:智能体。
- Task
- Task:任务。
- Query
- Query:查询。
- Sales
- Sales:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Inventory
- Inventory:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Marketing
- Marketing:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
主要目的是:
缩短单任务 Critical Path。
Concurrency(并发)
关注:
整个系统同时处理多少个 Task。
例如:
Task 1
Task 2
Task 3
...
Task 1000
逐项注释(1)
- Task
- Task:任务。
主要影响:
- Throughput(吞吐)
- Capacity(容量)
二者叠加会导致:
Downstream Concurrency Amplification(下游并发放大)
例如:
100 Concurrent Runs(100 个并发任务)
×
10 Parallel Tool Calls / Run
(每任务 10 个并行工具调用)

=
1000 Downstream Calls
(1000 个下游调用)
逐项注释(7)
- Concurrent
- Concurrent:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Runs
- Runs:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Parallel
- Parallel:并行执行。
- Tool
- Tool:工具。
- Calls
- Calls:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Run
- Run:单次运行。
- Downstream
- Downstream:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
所以:
一个单任务内部看起来完全合理的 Parallelism 设计,在平台规模下可能成为严重问题。
7.2 Throughput 怎么理解?
Throughput 表示:
单位时间系统完成多少 Agent Task。
可以使用 Little’s Law(利特尔法则)的工程直觉:
L = λW
其中:
L:系统中平均在途任务数量;λ:平均 Throughput(吞吐率);W:平均任务停留时间。
例如 Coding Agent:
平均任务时间 W = 600s

目标吞吐 λ = 1 task/s
(每秒完成 1 个任务)
逐项注释(3)
- W
- W:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- s
- s:秒或示例变量 S,依上下文确定。
- task
- task:任务。
那么稳态下平均需要:
L = 1 × 600
  = 600
逐项注释(1)
- L
- L:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
大约 600 个任务同时在途。
这说明:
Long-running Agent 要获得高 Throughput,天然需要较大的 Concurrent Capacity(并发容量)。
但必须明确:
Little’s Law 描述稳态系统中平均在途量、吞吐和停留时间之间的关系,并不意味着提高 Concurrency 就一定线性提升 Throughput。
如果 Tool Backend 已经饱和:
Concurrency:

100
→ 500
→ 2000
逐项注释(1)
- Concurrency
- Concurrency:并发:多个任务同时推进。
增加的任务更多会进入:
Queue(排队)
于是:
Concurrency ↑
→ Queue ↑
→ W(停留时间)↑
→ P99 ↑
逐项注释(4)
- Concurrency
- Concurrency:并发:多个任务同时推进。
- Queue
- Queue:队列。
- W
- W:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- P99
- P99:该纯文本块中的状态、决策或错误枚举值。
而不是:
Throughput 无限增长。
所以 Little’s Law 在这里主要用于:
Capacity Reasoning(容量推理)
而不是:
“多开并发”的理论依据。
7.3 为什么低流量快,高流量 P99 会爆?
经典生产问题:
10 QPS
P95 = 3s

100 QPS
P95 = 20s
逐项注释(3)
- QPS
- QPS:该纯文本块中的状态、决策或错误枚举值。
- P95
- P95:第 95 百分位值。
- s
- s:秒或示例变量 S,依上下文确定。
正确的因果链:
Demand(请求需求)↑
→ Concurrency(并发量)↑
→ Bottleneck Utilization(瓶颈资源利用率)↑
→ Queue Depth(队列深度)↑
→ Saturation(资源饱和)
→ Tail Latency(尾延迟)↑
→ Timeout(超时)↑
→ Retry(重试)↑
→ Load(负载)再次增加
逐项注释(12)
- Demand
- Demand:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Concurrency
- Concurrency:并发:多个任务同时推进。
- Bottleneck
- Bottleneck:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Utilization
- Utilization:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Queue
- Queue:队列。
- Depth
- Depth:深度。
- Saturation
- Saturation:饱和度:资源接近或达到容量上限的程度。
- Tail
- Tail:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Latency
- Latency:延迟。
- Timeout
- 超时:单次操作允许等待的最长时长。
- Retry
- 重试:失败后再次执行同一操作。
- Load
- Load:负载。
最终形成:
延迟越高 → 超时越多 → 重试越多 → 负载越高 → 延迟继续恶化。
需要重点关注:
- Headroom(容量余量)
- Concurrency Limit(并发限制)
- Backpressure(背压)
- Autoscaling(自动扩缩容)
- Tool Backend Scaling(工具后端扩容)
7.4 为什么只扩 Agent Worker 可能更慢?
假设:
Agent Workers(智能体工作节点)

10 → 50
逐项注释(2)
- Agent
- Agent:智能体。
- Workers
- Workers:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
Agent Queue 下降。
但是所有 Worker 访问:
Same Database(同一数据库)
Same Search Backend(同一搜索后端)
Same Ticket API(同一工单 API)
逐项注释(6)
- Same
- Same:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Database
- Database:数据库。
- Search
- Search:搜索。
- Backend
- Backend:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Ticket
- Ticket:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- API
- API:应用程序编程接口。
于是:
Tool Backend Saturation(工具后端饱和)
→ Queue(排队)
→ Timeout(超时)
→ Retry(重试)
→ P99 ↑
逐项注释(7)
- Tool
- Tool:工具。
- Backend
- Backend:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Saturation
- Saturation:饱和度:资源接近或达到容量上限的程度。
- Queue
- Queue:队列。
- Timeout
- 超时:单次操作允许等待的最长时长。
- Retry
- 重试:失败后再次执行同一操作。
- P99
- P99:该纯文本块中的状态、决策或错误枚举值。
所以:
Scale Agent ≠ Scale System(扩智能体不等于扩整个系统)。
应该同时检查:
- Agent Worker Capacity(智能体工作节点容量)
- Model Provider Rate Limit(模型提供商速率限制)
- Database Capacity(数据库容量)
- Tool Backend Capacity(工具后端容量)
- External API Rate Limit(外部 API 速率限制)
- Network Capacity(网络容量)
系统 Capacity 最终受:
最窄 Bottleneck(瓶颈)
限制。
例如:
Agent Worker CPU(工作节点 CPU) = 45%
Database Connection Pool(数据库连接池) = 100%
逐项注释(6)
- Agent
- Agent:智能体。
- Worker
- Worker:执行子智能体。
- CPU
- CPU:该纯文本块中的状态、决策或错误枚举值。
- Database
- Database:数据库。
- Connection
- Connection:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Pool
- Pool:资源池。
此时继续扩 Worker:
基本属于错误优化。
7.5 Concurrency Budget(并发预算)怎么设计?
Multi-Agent 很容易出现:
Concurrency Explosion(并发爆炸)。
例如:
100 Concurrent Runs(100 个并发任务)
×
10 Sub-Agents / Run(每任务 10 个子智能体)
×
5 Tool Calls / Sub-Agent(每子智能体 5 次工具调用)

=
理论 5000 Tool Calls
逐项注释(7)
- Concurrent
- Concurrent:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Runs
- Runs:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Sub-Agents
- Sub-Agents:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Run
- Run:单次运行。
- Tool
- Tool:工具。
- Calls
- Calls:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Sub-Agent
- Sub-Agent:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
平台需要多层并发控制:
Global Concurrency Budget(全局并发预算)
│
├─ Tenant Budget(租户并发预算)
│
├─ Run Budget(单任务并发预算)
│   └─ Parallel Branch Budget(并行分支预算)
│
└─ Tool Budget(单工具并发预算)
逐项注释(8)
- Global
- Global:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Concurrency
- Concurrency:并发:多个任务同时推进。
- Budget
- Budget:预算。
- Tenant
- Tenant:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Run
- Run:单次运行。
- Parallel
- Parallel:并行执行。
- Branch
- Branch:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Tool Budget
- 工具预算:允许调用工具的次数或成本上限。
目标不是:
“为了限流而限流”。
而是:
保护 Bottleneck Capacity、Queue 和 Tail Latency。
7.6 什么时候需要 Admission Control(准入控制)?
当系统已经接近 Saturation(饱和)时:
无条件接收所有 Task,可能导致所有用户一起变慢。
Admission Control(准入控制)负责决定:
一个任务现在是否应该进入昂贵执行阶段。
可以根据:
- Current Capacity(当前容量)
- Tenant(租户)
- Priority(优先级)
- Workload Type(工作负载类型)
- Queue Depth(队列深度)
- Deadline(截止时间)
做出:
Admit(允许执行)

Queue(进入队列)

Defer(延后执行)

Reject(拒绝请求)

Load Shedding
(负载丢弃 / 过载时主动舍弃部分低优先级负载)
逐项注释(6)
- Admit
- Admit:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Queue
- Queue:队列。
- Defer
- Defer:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Reject
- Reject:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Load
- Load:负载。
- Shedding
- Shedding:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
这里要区分:
Admission Control(准入控制)是整体准入决策机制。
而:
Load Shedding(负载丢弃)是系统过载时的一种具体手段。
两者不是完全同义词。
Performance 关注:
避免无限 Queue 导致整个平台 P99 失控。
Reliability(稳定性)则更加关注:
过载情况下系统不要整体崩溃,以及之后如何恢复。
7.7 为什么需要 Workload Isolation(工作负载隔离)?
一个 Agent Platform(智能体平台)可能同时存在:
Interactive Query(交互查询)

Long-running Coding Agent
(长任务编码智能体)

Background Batch(后台批任务)

High-priority Tenant(高优先级租户)
逐项注释(10)
- Interactive
- Interactive:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Query
- Query:查询。
- Long-running
- 长时间运行:任务持续时间明显超过一次普通请求,需要持久状态和恢复能力。
- Coding
- Coding:编码。
- Agent
- Agent:智能体。
- Background
- Background:后台执行。
- Batch
- Batch:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- High
- High:高等级。
- priority
- priority:优先级。
- Tenant
- Tenant:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
如果全部进入一个:
FIFO(First In First Out,先进先出)Queue
那么大量后台任务可能占满:
- Model Capacity
- Tool Capacity
- Worker Capacity
导致交互请求明显变慢。
因此可能需要:
- Priority Queue(优先级队列)
- Workload Isolation(工作负载隔离)
- Per-Tenant Quota(单租户配额)
- Fair Scheduling(公平调度)
例如:
Interactive Pool(交互任务池)

Long-running Pool(长任务池)

Background Pool(后台任务池)
逐项注释(4)
- Interactive
- Interactive:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Pool
- Pool:资源池。
- Long-running
- 长时间运行:任务持续时间明显超过一次普通请求,需要持久状态和恢复能力。
- Background
- Background:后台执行。
这部分不需要深入各种 Scheduler(调度器)算法。
真正应该理解的是:
Capacity Management(容量管理)不仅是“有多少资源”,也包括“资源优先分配给谁”。
7.8 Stateful Agent(有状态智能体)为什么更难 Scale?
如果 Worker 自己保存大量 Session State(会话状态):
Task A
固定绑定
Worker 1
逐项注释(3)
- Task
- Task:任务。
- A
- A:示例标识 A。
- Worker
- Worker:执行子智能体。
Worker 1 过载后:
很难立即把 Task A 调度到 Worker 2。
更有利于 Scale-out(水平扩展)的设计通常倾向:
Stateless Compute(无状态计算) + Externalized State(状态外置)
例如:
Durable State Store(持久状态存储)
             ↑
     ┌───────┼───────┐
Worker A  Worker B  Worker C
逐项注释(6)
- Durable State
- 持久状态:跨进程和机器故障仍能保留的任务状态。
- Store
- Store:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Worker
- Worker:执行子智能体。
- A
- A:示例标识 A。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
这样更容易:
- Load Balancing(负载均衡)
- Worker Scaling(工作节点扩容)
- Task Migration(任务迁移)
- Failure Recovery(故障恢复)
但是:
State Externalization(状态外置)也不是免费的。
可能增加:
- Serialization(序列化)
- Storage IO(存储 IO)
- Checkpoint Write(检查点写入)
- Coordination(协调)
所以:
Statefulness / Durability(状态性 / 持久性)本身也存在 Runtime Overhead(运行时开销)。
这里的模块边界:
Performance
关注:
状态机制对调度、延迟和扩容的影响。
Reliability
关注:
状态持久化如何保证失败后的恢复。
八、Validation & Trade-offs(验证与权衡)
8.1 怎么证明一次 Performance Optimization 真正有效?
不能:
本地跑一次

5s → 3s
逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
然后宣布:
性能提高 40%。
生产级 Performance Validation(性能验证)应该是:
Baseline(基线) → Controlled Change(受控改动) → Benchmark(基准测试) → Load Test(压力测试) → Guardrail Validation(护栏验证) → Canary Validation(灰度验证) → Production Validation(线上验证)
Representative Workload(代表性工作负载)
Benchmark 不只是:
随便选几个 Case。
而应该尽量逼近真实 Production Mix(生产任务分布)。
例如线上:
60% Simple Query(简单查询)

25% Multi-tool Task(多工具任务)

10% Long Context(长上下文任务)

5% Complex / Multi-Agent
(复杂 / 多智能体任务)
逐项注释(8)
- Simple
- Simple:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Query
- Query:查询。
- Multi-tool
- Multi-tool:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Task
- Task:任务。
- Long
- Long:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Context
- Context:上下文。
- Complex
- Complex:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Multi-Agent
- 多智能体:多个具有不同职责或能力的智能体协作完成任务。
如果 Benchmark 只有:
100% Simple Query逐项注释(2)
- Simple
- Simple:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Query
- Query:查询。
即使性能非常漂亮:
也不代表真实线上性能。
Microbenchmark(微基准测试) vs E2E Benchmark(端到端基准测试)
Tool A:
1000ms → 500ms逐项注释(1)
- ms
- ms:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
Microbenchmark:
Component Performance(组件性能)提升 50%。
但完整 Agent:
10s → 9.8s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
E2E 只提升:
2%。
所以:
Microbenchmark 用来理解组件;E2E Benchmark 用来证明最终产品收益。
Cold vs Warm(冷态 vs 热态)
如果优化依赖 Cache,应该分别测试:
- Cold Cache(冷缓存)
- Warm Cache(热缓存)
- Realistic Hit Distribution(真实缓存命中分布)
不能只测:
100% Cache Hit(100% 缓存命中)逐项注释(2)
- Cache
- Cache:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Hit
- Hit:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
否则结果很可能严重高估线上收益。
Concurrency Sweep(并发扫描)
例如:
Concurrency(并发数):

1
10
50
100
500
逐项注释(1)
- Concurrency
- Concurrency:并发:多个任务同时推进。
分别观察:
- Throughput
- P50 / P95 / P99
- Queue Depth(队列深度)
- 429
- Timeout
这样可以找到:
Saturation Point(饱和点)
而不是只知道:
“低并发时看起来挺快”。
Controlled Comparison(受控比较)
如果验证 Parallelism:
不要一次同时:
- 换模型;
- 改 Prompt;
- 打开 Cache;
- 修改 Tool Schema。
否则无法知道:
性能收益到底来自哪里。
Agent 又是:
Non-deterministic System(非确定性系统)
所以不应该:
只运行 1 次。
应该用足够的代表性样本和重复运行来观察:
- Distribution
- P95
- P99
- Quality
而不是只看一次最快结果。
8.2 为什么必须有 Guardrail Matrix(护栏矩阵)?
性能优化不能只看:
Latency ↓
至少要同时观察:
| 维度 | 典型指标 |
|---|---|
| Performance(性能) | P50 / P95 / P99 / Throughput |
| Quality(质量) | Task Success(任务成功率) / Eval Score(评测分数) |
| Reliability(稳定性) | Error Rate(错误率) / Timeout Rate(超时率) / 429 |
| Cost(成本) | Token Cost(Token 成本) / Model Cost(模型成本) / Tool Cost(工具成本) |
| Capacity(容量) | Queue Depth(队列深度) / Utilization(利用率) / Saturation(饱和度) |
例如:
优化前 → 优化后

P95 Latency(P95 延迟)
8s → 4.5s ✅

Task Success(任务成功率)
92% → 91.8% ✅

Cost(成本)
+3% ✅

429 Rate(429 比例)
0.2% → 8% ❌
逐项注释(6)
- P95
- P95:第 95 百分位值。
- Latency
- Latency:延迟。
- s
- s:秒或示例变量 S,依上下文确定。
- Task Success
- 任务成功:任务满足预先定义的完成条件。
- Cost
- Cost:成本。
- Rate
- Rate:比率或速率。
最终结论:
不能上线。
因为这里只是:
把 Latency 问题转变成 Capacity / Reliability 问题。
所以最终原则:
A Latency Win Is Real Only If Guardrails Hold(只有护栏没有出现不可接受退化,延迟收益才是真实收益)。
8.3 六类 Performance Anti-pattern(性能反模式)
最终不需要背几十个细碎坑。
记住六类根因即可。
Over-modeling(过度模型化)
所有 Step 都重新调用 LLM。
Over-context(过度上下文)
所有 History(历史)、Tool Schema(工具定义结构)、Tool Result 永久进入 Context。
Over-serializing(过度串行)
明明独立的工作全部串行。
Over-parallelizing(过度并行)
只考虑“任务独立”,没有考虑:
- State
- Side Effect(副作用)
- Backend Capacity
- Tail Latency
Over-distributing(过度分布式)
原本进程内:
Agent-as-Tool(智能体作为工具)
就可以完成,却拆成大量:
Remote Agent(远程智能体)+ RPC。
Local Optimization(局部优化)
一个 Span:
2s → 1s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
看起来优化 50%。
但:
- 不在 Critical Path;
- E2E 几乎不变;
- P99 更差;
- Quality 下降;
- Cost 上升。
这种优化没有真正业务意义。
因此:
优秀 Performance Engineering 优化的是系统目标,而不是局部数字。
九、两个必须掌握的生产 Case(案例)
9.1 Case A:单请求慢
Data Agent:
P95 E2E = 12s

目标 SLO:

P95 E2E ≤ 8s
逐项注释(4)
- P95
- P95:第 95 百分位值。
- E2E
- E2E:该纯文本块中的状态、决策或错误枚举值。
- s
- s:秒或示例变量 S,依上下文确定。
- SLO
- SLO:服务等级目标:为服务等级指标设定的目标。
Trace:
intent_route(意图路由)        0.2s
planning(规划)                1.0s
retrieve_schema(检索定义)     1.5s
generate_sql(生成 SQL)        1.2s
execute_sql(执行 SQL)         6.5s
generate_answer(生成答案)     1.6s
逐项注释(8)
- intent_route
- intent_route:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- s
- s:秒或示例变量 S,依上下文确定。
- planning
- planning:规划。
- retrieve_schema
- retrieve_schema:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- generate_sql
- generate_sql:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
- SQL
- SQL:结构化查询语言。
- execute_sql
- 函数或工具名:执行传入的 SQL 语句。
- generate_answer
- generate_answer:该示例中的变量、字段、函数或工具标识;其组成词描述了所承载的数据或执行动作。
推荐回答:
SLO Miss(目标未达成)
→ Trace Breakdown(追踪拆解)
→ Dependency Graph(依赖图)
→ Critical Path(关键路径)
→ Root Cause(根因)
→ Optimization(优化)
→ Guardrail Validation(护栏验证)
逐项注释(12)
- SLO
- SLO:服务等级目标:为服务等级指标设定的目标。
- Miss
- Miss:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Trace
- Trace:调用轨迹。
- Breakdown
- Breakdown:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Dependency
- Dependency:依赖。
- Graph
- Graph:图结构。
- Critical
- Critical:关键或高严重度。
- Path
- Path:路径。
- Root Cause
- 根因:能够解释问题发生机制并指导永久修复的底层原因。
- Optimization
- Optimization:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Guardrail
- Guardrail:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Validation
- Validation:验证。
假设确认:
execute_sql位于 Critical Path。
继续分析:
- SQL 自身是不是慢?
- Data Warehouse 是否在 Queue?
- 是否重复 Query?
- 是否可以 Cache?
- 是否可以 Prefetch(预取)Schema / Metadata(元数据)?
- 是否 Tool Design 不合理?
- 是否部分查询可以并行?
优化完成以后还要看:
- P95
- P99
- Database Load(数据库负载)
- Task Success
- Cost
- Cache Hit Rate
这才是一个完整生产闭环。
9.2 Case B:低流量快,高流量慢
现象:
10 QPS
P95 = 3s

100 QPS
P95 = 20s
逐项注释(3)
- QPS
- QPS:该纯文本块中的状态、决策或错误枚举值。
- P95
- P95:第 95 百分位值。
- s
- s:秒或示例变量 S,依上下文确定。
诊断链:
Demand(请求需求)
→ Concurrency(并发)
→ Agent Worker(智能体工作节点)
→ Model Provider Rate Limit(模型提供商速率限制)
→ Tool Backend(工具后端)
→ Database(数据库)
→ Queue(排队)
→ Saturation(饱和)
逐项注释(12)
- Demand
- Demand:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Concurrency
- Concurrency:并发:多个任务同时推进。
- Agent
- Agent:智能体。
- Worker
- Worker:执行子智能体。
- Model
- Model:模型。
- Provider
- Provider:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Rate Limit
- 速率限制:限制单位时间内请求或调用次数的机制。
- Tool
- Tool:工具。
- Backend
- Backend:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Database
- Database:数据库。
- Queue
- Queue:队列。
- Saturation
- Saturation:饱和度:资源接近或达到容量上限的程度。
最终发现:
Agent Worker CPU = 45%

Database Connection Pool
(数据库连接池)
= 100%
逐项注释(6)
- Agent
- Agent:智能体。
- Worker
- Worker:执行子智能体。
- CPU
- CPU:该纯文本块中的状态、决策或错误枚举值。
- Database
- Database:数据库。
- Connection
- Connection:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Pool
- Pool:资源池。
结论:
Agent Worker 不是 Bottleneck。
如果继续:
Worker 数量:

10 → 50
逐项注释(1)
- Worker
- Worker:执行子智能体。
反而会:
进一步打满 Database。
真正可能的方案:
- Query Optimization(查询优化)
- Database Scaling(数据库扩容)
- Concurrency Limit(并发限制)
- Cache
- Workload Isolation(工作负载隔离)
- Admission Control(准入控制)
- Backpressure(背压)
这就是:
Scale Agent ≠ Scale System。
十、Performance 与其他模块的边界
Quality(质量)
回答:
Agent 优化后还做得对吗?
Reliability(稳定性)
回答:
超时、过载、失败以后系统是否仍能稳定运行和恢复?
Controllability(可控性)
回答:
性能优化是否绕过 Policy(策略)、Approval(审批)或状态边界?
Observability(可观测性)
负责提供:
- Trace
- Metric(指标)
- Queue
- Version(版本)
- Release(发布版本)
等 Evidence(证据)。
Performance 使用这些 Evidence:
做 Diagnosis(诊断)和 Intervention(优化干预)。
Cost(成本)
回答:
为获得这些性能,需要花多少钱?
因此模块边界可以压缩成:
Observability 提供事实;Performance 做性能决策;Quality、Reliability、Cost 是核心 Guardrail(护栏)。
十一、五条最高级原则
原则一:Optimize the Bottleneck(优化主导瓶颈)
Latency 问题:
找 Critical Path。
Throughput 问题:
找 Bottleneck Capacity。
Tail Latency 问题:
找 Queue / Saturation / Straggler。
原则二:Reduce Work Before Making Work Faster(先减少工作,再让工作更快)
优先减少:
- Step
- Model Round Trip
- Duplicate Tool Call(重复工具调用)
- Context
- Coordination
原则三:Parallelism Is Not Free(并行不是免费的)
记忆五判断:
独立、隔离、安全、有容量、有收益。
原则四:Optimize for the Workload(围绕工作负载优化)
Interactive / Long-running / Background Agent:
性能目标不同,优化策略自然也不同。
原则五:Guardrails Define Real Performance(护栏决定真实性能收益)
只有:
- Quality
- Reliability
- Cost
- Capacity
没有出现不可接受退化:
性能提升才是真正有意义的提升。
十二、最终主线
整章最终可以用这一条线重建:
分类 → 定目标 → 测量 → 拆解 → 找主导瓶颈 → 减少工作 → 优化依赖 / 容量 → 减少等待 → 改善感知 → 验证
Workload Classification(工作负载分类)
→ Set SLI / SLO(设定性能指标 / 服务目标)
→ Measure(测量)
→ Break Down(拆解)
→ Find Dominant Bottleneck(寻找主导瓶颈)
→ Reduce Work(减少工作)
→ Optimize Dependency / Capacity(优化依赖 / 容量)
→ Reduce Waiting(减少等待)
→ Improve Perception(改善用户感知)
→ Validate Guardrails(验证护栏)
逐项注释(21)
- Workload
- Workload:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Classification
- Classification:分类。
- Set
- Set:集合。
- SLI
- SLI:服务等级指标:直接度量服务表现。
- SLO
- SLO:服务等级目标:为服务等级指标设定的目标。
- Measure
- Measure:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Break
- Break:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Down
- Down:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Find
- Find:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Dominant
- Dominant:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Bottleneck
- Bottleneck:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Reduce
- Reduce:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Work
- Work:业务工作单元。
- Optimize
- Optimize:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Dependency
- Dependency:依赖。
- Capacity
- Capacity:容量:系统可承载的工作量。
- Waiting
- Waiting:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Improve
- Improve:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Perception
- Perception:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Validate
- Validate:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
- Guardrails
- Guardrails:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
十三、P0 / P1 / P2 面试优先级
P0:必须掌握
- Agent Performance 是什么?为什么不等于 Model Latency?
- Agent 为什么容易产生 Amplification Effect(放大效应)?
- Latency、Throughput、Tail Latency、Capacity 分别是什么?
- 怎么根据 Workload 设计 SLI / SLO?
- 一个 Agent 慢了怎么系统诊断?
- Critical Path 是什么?
- 为什么 Step Count 很重要?
- 为什么不是每一步都应该调用 LLM?
- Fast Path / Slow Path 怎么设计?
- 什么时候应该并行?
- Multi-Agent 为什么可能比 Single-Agent 更慢?
- Context 为什么会拖慢 Agent?
- Cache 怎么获得真正的性能收益?
- Model Routing 怎么设计?
- Streaming 和 Long-running Agent 如何优化用户体验?
- 为什么低流量很快,高流量 P99 会爆?
- Throughput / Concurrency / Capacity 怎么理解和优化?
- 怎么证明一次 Performance Optimization 真正有效?
P1:重要进阶
- Little’s Law(利特尔法则)的工程直觉
- Programmatic Tool Calling(程序化工具调用)
- Tool Granularity(工具粒度)
- Dynamic Tool Loading(动态工具加载)
- Tool Search(工具搜索)
- Join Strategy(汇合策略)
- Early Completion(提前完成)
- Cancellation Propagation(取消传播)
- Intermediate Result Reuse(中间结果复用)
- Concurrency Budget(并发预算)
- Admission Control(准入控制)
- Load Shedding(负载丢弃 / 过载拒绝)
- Workload Isolation(工作负载隔离)
- Fair Scheduling(公平调度)
- Stateless Compute + Externalized State(无状态计算 + 状态外置)
- Controlled Comparison(受控比较)
- Concurrency Sweep(并发扫描)
- Cold / Warm Benchmark(冷态 / 热态基准测试)
P2:高级扩展
- Prefetch(预取)
- Speculative Execution(推测执行)
- SWR(Stale-While-Revalidate,先返回旧缓存并在后台刷新)
- Hot Partition(热点分区)
- LLM Serving(大语言模型服务)底层性能机制
如果岗位是 Agent Application Engineer(智能体应用工程师)或 Agent Platform Engineer(智能体平台工程师),通常无需把本章扩展成:
- GPU Kernel(GPU 内核)
- CUDA
- Continuous Batching(连续批处理)
- KV Cache(Key-Value Cache,注意力键值缓存)
等完整 LLM Infra(大语言模型基础设施)课程。
除非岗位本身明确涉及:
Model Serving / LLM Infra(模型服务 / 大语言模型基础设施)。
十四、2~3 分钟标准面试回答
如果面试官问:
“你会怎么优化一个生产 Agent 的性能?”
可以这样回答:
我不会一开始就换模型、开缓存或者增加并行,而是先确定这个 Agent 属于什么 Workload。Interactive Agent、Long-running Agent 和 Background Agent 的性能目标并不一样:交互型更关注 TTFT、首次有用结果时间和 P95 E2E,长任务更关注首次有效进展和最终完成时间,后台任务则更关注 Throughput 和 Deadline。
明确 SLI / SLO 后,我会先测量和拆解。如果是单任务慢,我会通过 Trace 建立 Dependency Graph 并找 Critical Path;如果 Throughput 上不去,我会找 Bottleneck Capacity;如果 P99 恶化,我会重点检查 Queue、Saturation 和 Straggler。
对于单任务 Latency,我一般从关键路径工作、等待 / 排队、协调开销和重复工作几个根因维度分析,但真正计算 E2E 时仍然以 Trace Dependency 和 Critical Path 为准。优化时优先遵循“先减少工作,再让单步更快”,例如减少无效 Replan、重复 Tool Call、Model Round Trip 和 Context。对于不需要每一步重新进行语义判断的确定性 Tool Workflow,可以让 Code 负责编排,而不是每一步重新进入 LLM。
如果要并行,我会检查五件事:依赖是否独立、State 是否隔离、副作用是否安全、Backend 是否有容量,以及并行是否真的缩短 Critical Path。Multi-Agent 也不是天然更快,因为 Context Transfer、RPC、Handoff 和 Fan-in 都会产生 Coordination Overhead;如果已经满足完成条件,还应该取消不再需要的 Sub-Agent 或 Tool Work,避免 Zombie Work。
Context 层可以做 Trimming、按需检索和 Dynamic Tool Loading;重复工作可以用 Cache 或 Intermediate Result Reuse;不同 Step 可以通过 Model Routing 选择更匹配的模型;任务本身无法快速完成时,可以通过 Streaming、Progress 和 Intermediate Result 提前向用户释放价值。
流量上升以后,则不能只盯单任务 Trace,而要看 Demand、Concurrency、Bottleneck Capacity、Queue 和 Saturation。只扩 Agent Worker 并不代表整体系统容量增加,如果真正瓶颈是 Database 或 Tool Backend,继续扩 Worker 只会让 P99 更差。
最后所有优化都必须经过 Benchmark 和 Guardrail Validation。我不仅看 P95 是否下降,还会同时看 Quality、Reliability、Cost、429、Queue 和 Capacity。例如 P95 从 8 秒降到 4 秒,但 429 从 0.2% 上升到 8%,这不能算成功的性能优化。
所以我认为生产级 Agent Performance 的核心是:
围绕明确 Workload 和 SLO,找到真正主导目标指标的瓶颈,优先减少不必要的工作、依赖、排队和协调开销,并在质量、稳定性和成本护栏内获得可验证的性能收益。
十五、最终记忆压缩
单任务慢
**Critical-path Work(关键路径工作)
- Waiting(等待)
- Coordination(协调)
- Redundant Work(重复工作)**
注意:
这是根因分析维度,不是四个机械相加的互斥时间桶。
系统流量起来后慢
Demand(需求) vs Bottleneck Capacity(瓶颈容量) → Utilization(利用率) → Queue(排队) → Throughput / Tail Latency(吞吐 / 尾延迟)
四个优化作用面
Model Layer(模型层) Agent Execution Layer(智能体执行层) System Layer(系统层) Experience Layer(体验层)
并行五判断
独立、隔离、安全、有容量、有收益
五条最高级原则
找主导瓶颈 先减少工作 并行不是免费的 围绕 Workload 优化 护栏不退化才是真优化
十六、一句话本质
Agent Performance 的本质,不是让每一个模型、工具和步骤都尽可能快,而是在明确的 Workload(工作负载)与 SLO(服务水平目标)下,识别真正主导 Latency(延迟)、Throughput(吞吐)或 Tail Latency(尾延迟)的 Bottleneck(瓶颈),减少不必要的工作、依赖、排队与协调开销,并在 Quality(质量)、Reliability(稳定性)和 Cost(成本)护栏内持续获得可验证的性能收益。
十七、封版检查结果
本章最终已经覆盖:
基础技术理论
- Latency
- Throughput
- Concurrency
- Parallelism
- Capacity
- Tail Latency
- Critical Path
- SLI / SLO
- Little’s Law
- Queue / Saturation
Agent 特有性能问题
- Step Count
- Model Round Trip
- Context Amplification
- Load Amplification
- Tool Design
- Programmatic Orchestration
- Dynamic Tool Loading
- Multi-Agent Coordination
生产工程
- Concurrency Budget
- Admission Control
- Load Shedding
- Backpressure
- Workload Isolation
- Fair Scheduling
- Stateful / Stateless
- Tool Backend Capacity
- Cancellation Propagation
用户体验
- TTFT
- TTFUR
- Streaming
- Progress
- Long-running Agent
真实踩坑
- Over-modeling
- Over-context
- Over-serializing
- Over-parallelizing
- Over-distributing
- Local Optimization
- Cache 无命中
- Fast Path 升级反而更慢
- Worker 扩容打爆 Backend
- Zombie Work
生产验证
- Representative Workload
- Production Mix
- Microbenchmark
- E2E Benchmark
- Cold / Warm
- Concurrency Sweep
- Controlled Comparison
- Load Test
- Canary Validation
- Guardrail Matrix
当前继续增加内容,主要会进入:
- Cost(成本)
- Reliability(稳定性)
- Distributed Systems(分布式系统)
- LLM Serving(大语言模型服务基础设施)
的知识范围,而不是补充 Performance 的实质一级缺口。
因此本章正式标记为:
《第五章:Performance(性能)》V4 Final / SEALED(最终封版)