生产级 AI Agent 面试手册
准确性 - 如何证明一个 Agent 真正“做对了”?
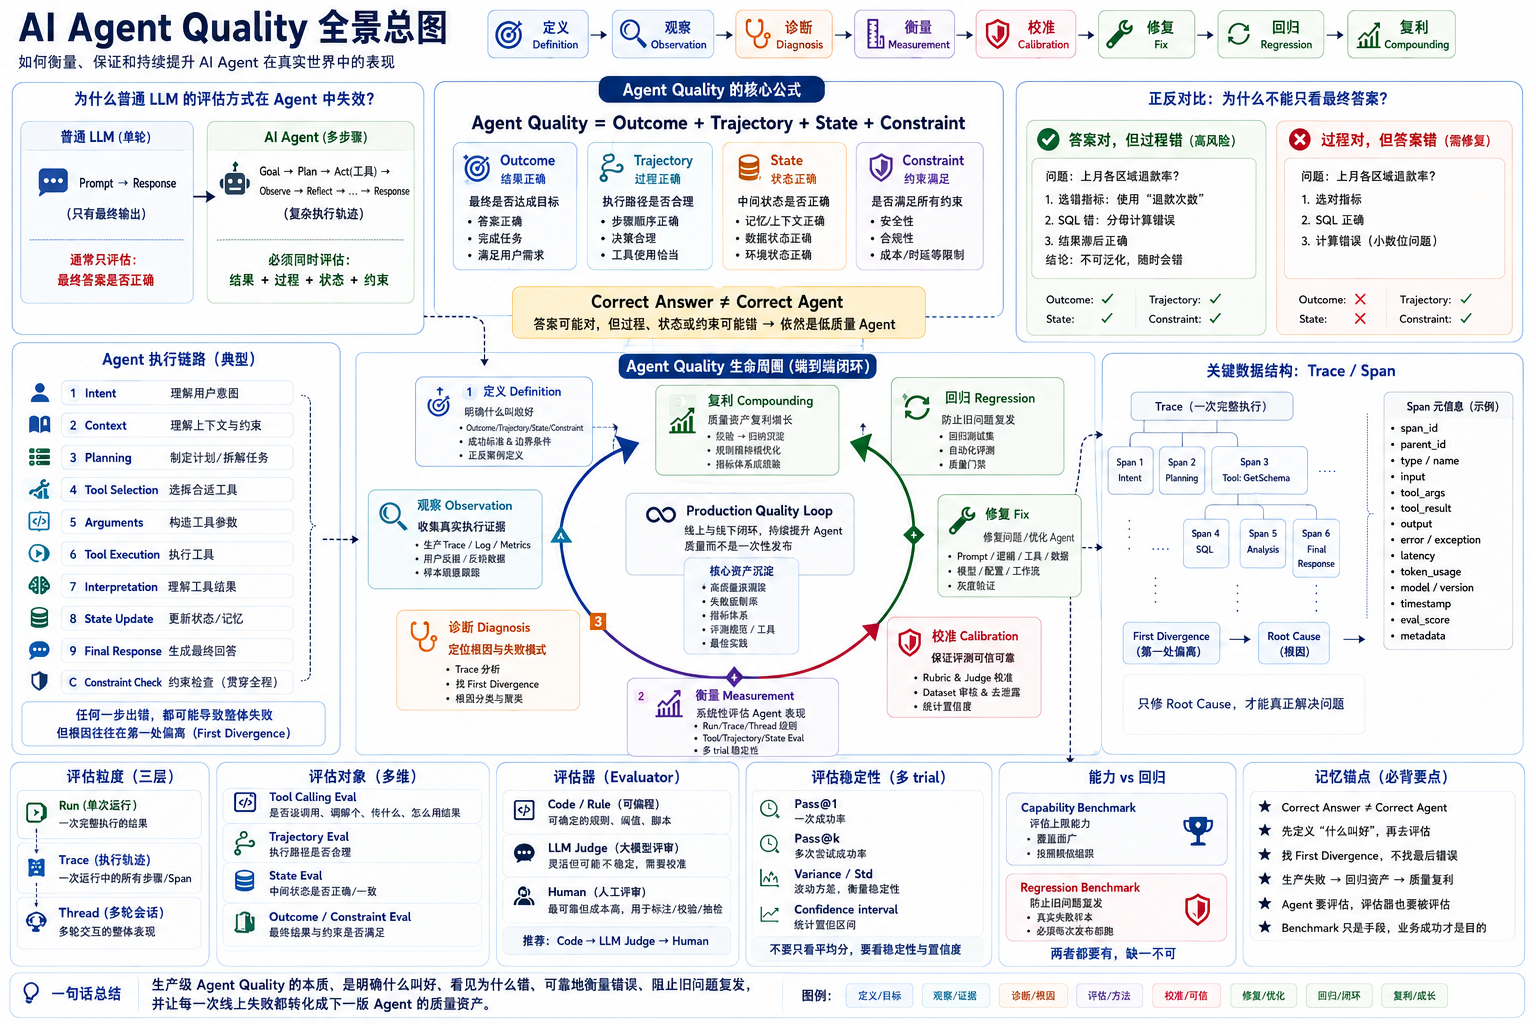
一、我们到底在评什么?
这是整个质量模块的第一性问题。
如果这个问题没有定义清楚,那么后面的:
- 准确率
- 大模型评分者(LLM-as-a-Judge)
- 评测用例集(Eval Dataset)
- 执行记录(Trace)
- 回归检查(Regression,防止旧问题重现)
- 线上评测(Online Eval)
都会变成一堆孤立技术点。
所以真正应该先问:
我们到底想证明 Agent 的什么?
1.1 普通大模型:主要看输入和输出
传统大模型应用很多可以简化成:
用户输入
   ↓
大语言模型(LLM)
   ↓
最终回答
例如:
用户:法国首都是哪里?
模型:巴黎。
这种情况下:
对这类简单问答,最终回答正确,通常就代表任务完成。
所以传统模型评测天然容易围绕最终输出展开。
1.2 生产级 Agent 则是一条执行链
真实 Agent 更接近:
用户目标
   ↓
理解用户意图(Intent)
   ↓
获取上下文(Context)
   ↓
制定计划(Planning)
   ↓
选择工具(Tool)
   ↓
生成工具参数(Tool Arguments)
   ↓
执行工具
   ↓
读取工具结果(Tool Result)
   ↓
根据结果继续决策
   ↓
可能再次规划 / 调用工具
   ↓
修改 Environment State / 外部环境状态
   ↓
判断任务是否完成
   ↓
生成最终回答(Final Response)
从运行机制看,则可以进一步抽象成:
目标(Goal)
   ↓
观察现状(Observe)
   ↓
判断并规划(Think & Plan)
   ↓
执行动作(Act)
   ↓
观察执行结果
   ↓
再次判断并规划
   ↓
再次执行动作
   ↓
...
   ↓
结束任务(Finish)
因此从工程角度,更准确的理解是:
Agent 是一个围绕目标不断进行感知、决策、行动、反馈和状态更新的非确定性执行系统。
这句话是整个 Quality 模块最重要的理论起点。
1.3 为什么这会彻底改变“正确”的定义?
看两个例子。
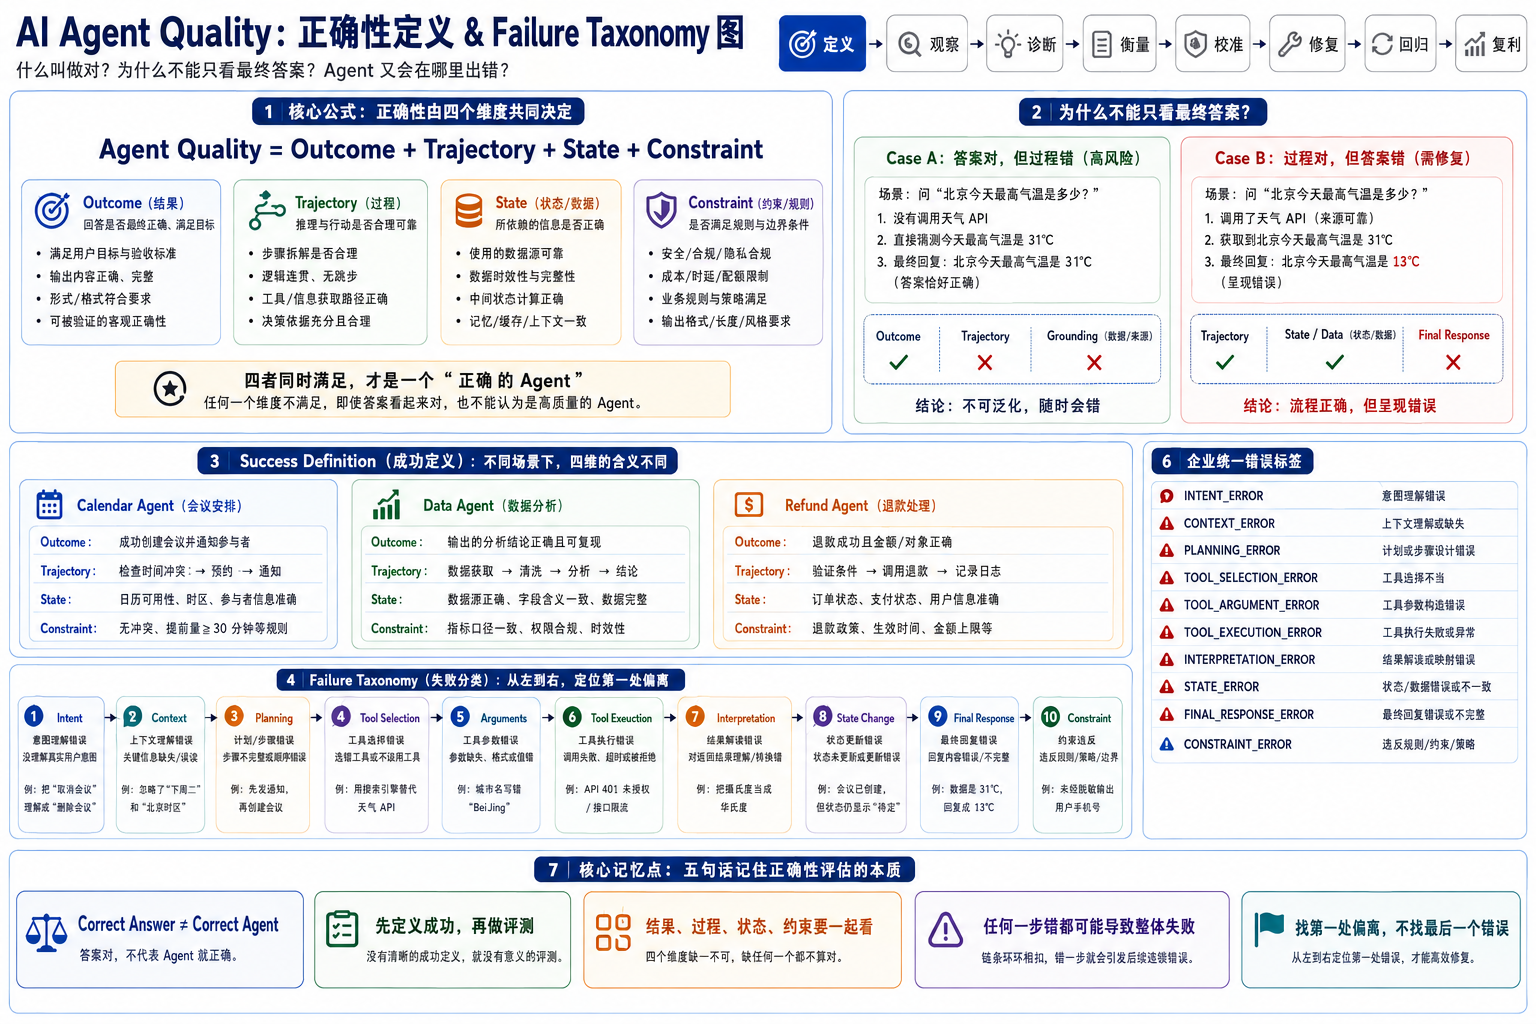
1.3.1 例子 A:答案正确,但 Agent 行为错误
用户:
北京今天多少度?
Agent:
没有调用实时天气工具
↓
直接根据模型已有知识猜
↓
回答:31℃
当天真实温度恰好也是:
31℃结果:
最终回答           ✅
工具选择           ❌
依据是否可靠       ❌
执行过程           ❌
如果只看最终回答:
通过但这个 Agent 显然不能作为可靠的天气助手使用。
原因是:
它不是稳定地做对,而是碰巧做对。
1.3.2 例子 B:过程正确,但最终回答错误
Agent:
调用天气接口         ✅
↓
返回 31℃              ✅
↓
正确解析数据           ✅
↓
最终回复写成 13℃       ❌
结果:
执行过程            ✅
工具执行            ✅
获取的数据          ✅
最终回答            ❌
所以两个例子放在一起,可以得到最核心的结论:
Agent 的结果正确性和过程正确性必须拆开评估。
1.4 Agent 质量的四个检查视角
一个真正“做对”的 Agent,至少同时满足四个条件:
                     Agent 质量
                           │
          ┌────────────────┼────────────────┐
          │                │                │
       结果正确          执行路径合理       真实状态正确
          │                │                │
          └────────────────┼────────────────┘
                           │
                       关键约束满足
可以记成:
Agent 质量要同时看:结果(Outcome)、过程(Trajectory)、真实状态(State)和约束(Constraint)。
这里的加号只是帮助记忆,不是把四项分数简单相加。
比如:退款是否成功要看真实状态;越权操作即使完成任务,也不能算通过。
1.4.1 结果正确(Outcome)
用户最终想完成的任务:
到底有没有完成?
1.4.2 执行轨迹合理(Trajectory)
Agent 是否:
- 理解正确
- 规划正确
- 选择正确工具
- 参数正确
- 正确理解中间结果
- 没有明显 Loop
- 没有进行无意义操作
- 没有执行危险动作
1.4.3 真实状态正确(State)
Agent 说:
“已经修改成功。”
并不能证明任务成功。
真正应该验证的是:
数据库、订单、文件、Calendar、Git 仓库里的真实状态有没有正确变化。
1.4.4 满足约束(Constraint)
包括:
- 业务规则
- 权限
- 审批
- 风控
- 合规
- 关键安全边界
1.5 整个质量模块的主线
后面的所有问题,本质上都在回答:
我们到底在评什么?
        ↓
Agent 为什么会错?
        ↓
第一次错在哪里?
        ↓
怎么观察全过程?
        ↓
怎么稳定地衡量?
        ↓
谁来评?
        ↓
用什么数据评?
        ↓
怎么证明评测自己可信?
        ↓
修改之后怎么防回退?
        ↓
线上新问题怎么重新进入评测?
        ↓
最终怎么形成持续质量闭环?
可以压缩成八个词:
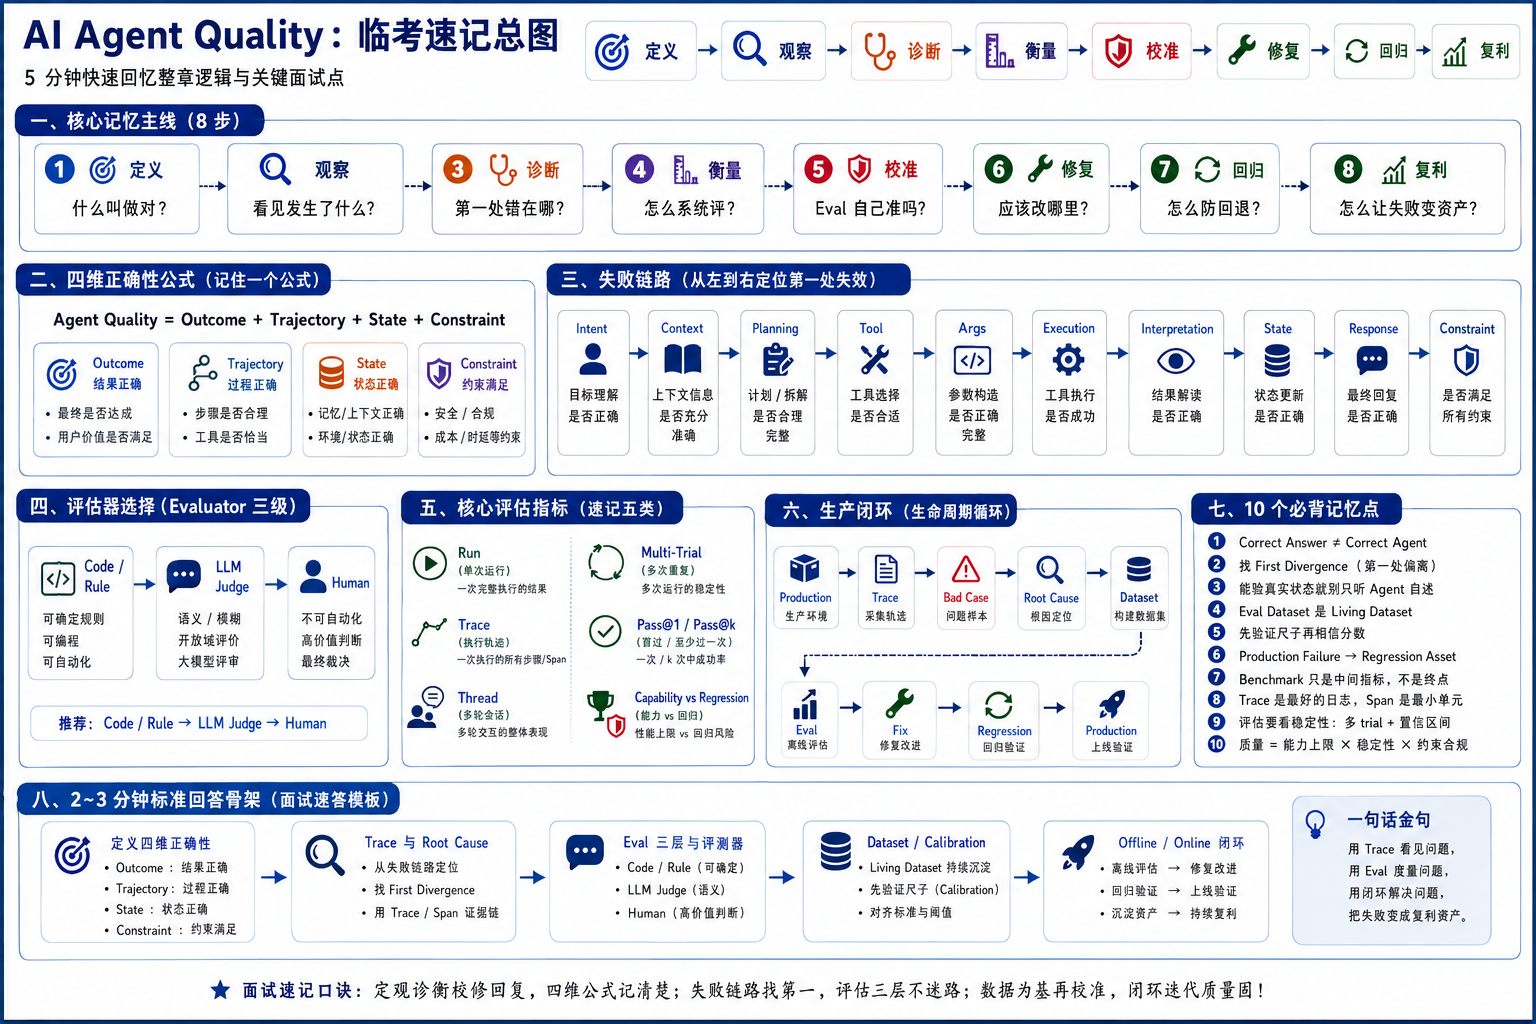
定义 → 观察 → 诊断 → 衡量 → 校准 → 修复 → 回归 → 复利
这八个词,比死记 29 道题更重要。
二、定义
2.1 什么叫一个 Agent“做对了”?
2.1.1 本质在考什么
面试官真正想知道的不是:
你是否知道 Accuracy。
而是:
你有没有把 Agent Quality 理解成系统级正确性。
2.1.2 核心结论
一个 Agent 真正成功,需要同时满足:
结果正确
+
执行过程合理
+
真实状态正确
+
关键约束满足
2.1.3 真实案例:Calendar Agent
用户:
把明天下午 3 点的产品评审改到 4 点。
Agent 最终回答:
已修改成功。
不能立刻判 PASS。
至少要验证:
2.1.3.1 结果:会议是否改对
目标会议是否确实变成 16:00?
2.1.3.2 过程:有没有走对步骤
Agent 有没有:
- 找对 Calendar
- 找对会议
- 调对 Tool
- 使用正确 eventId
- 没有误操作其他会议
2.1.3.3 状态:后台是否真的变化
Calendar 后台真实 event 是否真的变化?
2.1.3.4 约束:有没有越权或误操作
Agent 是否:
- 有权限修改
- 修改的是正确用户的数据
- 没有错误删除参与者
2.1.4 数据分析 Agent 例子
用户:
查询昨天华东区域 GMV,并分析环比变化。
Agent 最终回答:
华东 GMV 1.2 亿,环比下降 8%。
不能只看最终回答。
至少检查:
表结构选对了吗?
GMV 指标口径对吗?
昨天的日期范围对吗?
华东区域筛选对吗?
SQL 查询正确吗?
环比计算正确吗?
最终数字能从 SQL 结果核对吗?
分析结论有依据吗?
这也是为什么数据 Agent 的质量很容易出现这样的问题:
答案看起来很专业,但业务口径从第一步就错了。
2.1.5 工程上怎么实现
不要只记录一个笼统的成功标记:
success = true # 只记录“成功”,无法说明哪一步做对应该分别记录任务、执行路径、真实状态和约束是否正确。系统字段可以保留英文,但读者需要知道各字段的含义:
task_success             任务是否完成
trajectory_correctness   执行路径是否合理
state_correctness        真实状态是否正确
constraint_compliance    是否遵守关键约束
例如:
任务完成              通过
工具选择              通过
工具参数              通过
最终回答              通过
真实状态验证          通过
权限与策略约束        失败

总体结论              失败
2.1.6 一个非常重要的设计:Hard Gate
某些指标不能简单求平均。
例如:
回答质量:95
安全约束:未通过
金融、权限、删除、支付、隐私场景应该:
把关键约束作为 Hard Gate / 硬门禁。
也就是说:
回答质量分数很高
+
关键审批规则未通过

最终仍然不通过
2.1.7 面试官连续追问
2.1.7.1 最终答案正确,但多调用了一次 Tool,算 Quality 吗?
看影响。
- 多调用一次无害的只读工具:主要影响性能和成本
- 使用错误数据源:Quality
- 修改了额外状态:Quality
- 调用了高风险工具:涉及安全和行为可控性
2.1.7.2 Quality 的各维度要不要统一做一个总分?
可以有总分方便排序和趋势分析,但:
不能让总分覆盖关键失败。
核心安全、状态、权限约束最好单独做 Gate。
2.1.7.3 最终用户满意,但是路径不合理,还需要管吗?
需要。
因为:
用户只看到这一次,而工程团队关注下一万次是否仍然稳定。
2.1.8 一句话记忆
Agent 的“对”不是答案对,而是结果、过程、状态和约束一起对。
2.2 为什么 Agent 不能只评最终答案?
2.2.1 核心结论
因为:
答案正确,不等于 Agent 整个执行过程都正确。
最终答案可能掩盖:
- 错误 Tool
- 错误数据源
- 错误规划
- Loop
- 多余动作
- 危险状态修改
Agent 即使最终答案正确,也可能走了一条脆弱路径;这类 Agent 下一次执行同样任务时可能直接失败。
2.2.2 这里存在一个 Trade-off
是不是意味着:
每个任务都应该完整检查整个 Trajectory?
也不是。
2.2.2.1 高风险任务
例如:
身份校验 → 修改账户
审批 → 转账
退款资格 → 退款
需要检查关键轨迹。
2.2.2.2 开放任务
例如:
- Research
- Data Analysis
- 内容生成
通常更关注:
最终结果
+
关键约束
+
明显异常行为
而不应该把所有中间步骤锁死。
2.2.3 为什么不能过度约束?
因为会带来:
- 合理路径被判错
- Agent 探索空间下降
- Eval 和当前实现强耦合
- 换模型后大量误报
- Grader 维护成本高
所以真正成熟的原则是:
对结果严格,对关键行为严格,对开放路径保持弹性。
2.3 Agent 到底会在哪里出错?
需要建立统一:
Failure Taxonomy / 失败分类体系。
完整执行链:
理解意图
 ↓
获取上下文
 ↓
制定计划
 ↓
选择工具
 ↓
生成工具参数
 ↓
执行工具
 ↓
理解工具结果
 ↓
修改真实状态
 ↓
生成最终回答
2.3.1 意图错误(Intent Error)
用户:
把刚才那场会议推迟一小时。
Agent:
把下午所有会议推迟。
2.3.2 上下文错误(Context Error)
例如:
- RAG 找错文档
- Memory 使用过期信息
- Context 被截断
- Schema 获取错误
- 历史对话污染
- 获取了错误用户的数据
2.3.3 规划错误(Planning Error)
正确:
查订单
→ 判断退款资格
→ 判断金额
→ 必要时审批
→ 退款Agent:
直接退款2.3.4 工具选错(Tool Selection Error)
例如:
需要公司内部 DB。
却使用:
search_web # 搜索公开网页,找不到内部数据库中的权威数据2.3.5 工具参数错误(Tool Argument Error)
get_order(order_id=123) # 查询编号为 123 的订单实际应该:
order_id=132 # 实际应查询编号为 132 的订单2.3.6 工具执行错误(Tool Execution Error)
例如:
- Timeout
- HTTP 429
- HTTP 500
- 网络异常
- 权限不足
这一类之后会在 Reliability 深入。
2.3.7 结果理解错误(Interpretation Error)
Tool:
Revenue = 12.3M # 实际收入:1230 万Agent:
Revenue = 123M # 被误读成:1.23 亿2.3.8 状态修改错误(State Error)
例如:
Tool 成功执行,但修改了错误订单。
2.3.9 最终表达错误(Final Response Error)
后台已经成功。
Agent:
操作失败。
2.3.10 约束违规(Constraint Error)
退款成功。
但:
10 万元退款本应人工审批。
仍然 FAIL。
2.3.11 企业中最好统一错误标签(Error Label)
例如:
INTENT_ERROR            意图理解错误
CONTEXT_ERROR           上下文错误
PLANNING_ERROR          规划错误
TOOL_SELECTION_ERROR    工具选错
TOOL_ARGUMENT_ERROR     工具参数错误
TOOL_EXECUTION_ERROR    工具执行错误
INTERPRETATION_ERROR    工具结果理解错误
STATE_ERROR             真实状态修改错误
FINAL_RESPONSE_ERROR    最终回答错误
CONSTRAINT_ERROR        关键约束违规
有了统一分类之后,才能统计:
35% 上下文错误
22% 工具参数错误
17% 规划错误
...
从:
“这个 Case 怎么这么奇怪?”
升级为:
当前最大系统性问题是 Context,应该优先投资源优化 Context。
2.4 小结:质量的第一性问题不是评测,而是成功定义
必须先定义:
结果正确
执行路径合理
真实状态正确
关键约束满足
然后再看:
理解意图
获取上下文
制定计划
选择工具
生成参数
执行工具
理解结果
修改状态
生成回答
最重要的记忆点:
不要只问“最后为什么错”,要问“第一次从正确行为偏离发生在哪里”。
三、观察与诊断
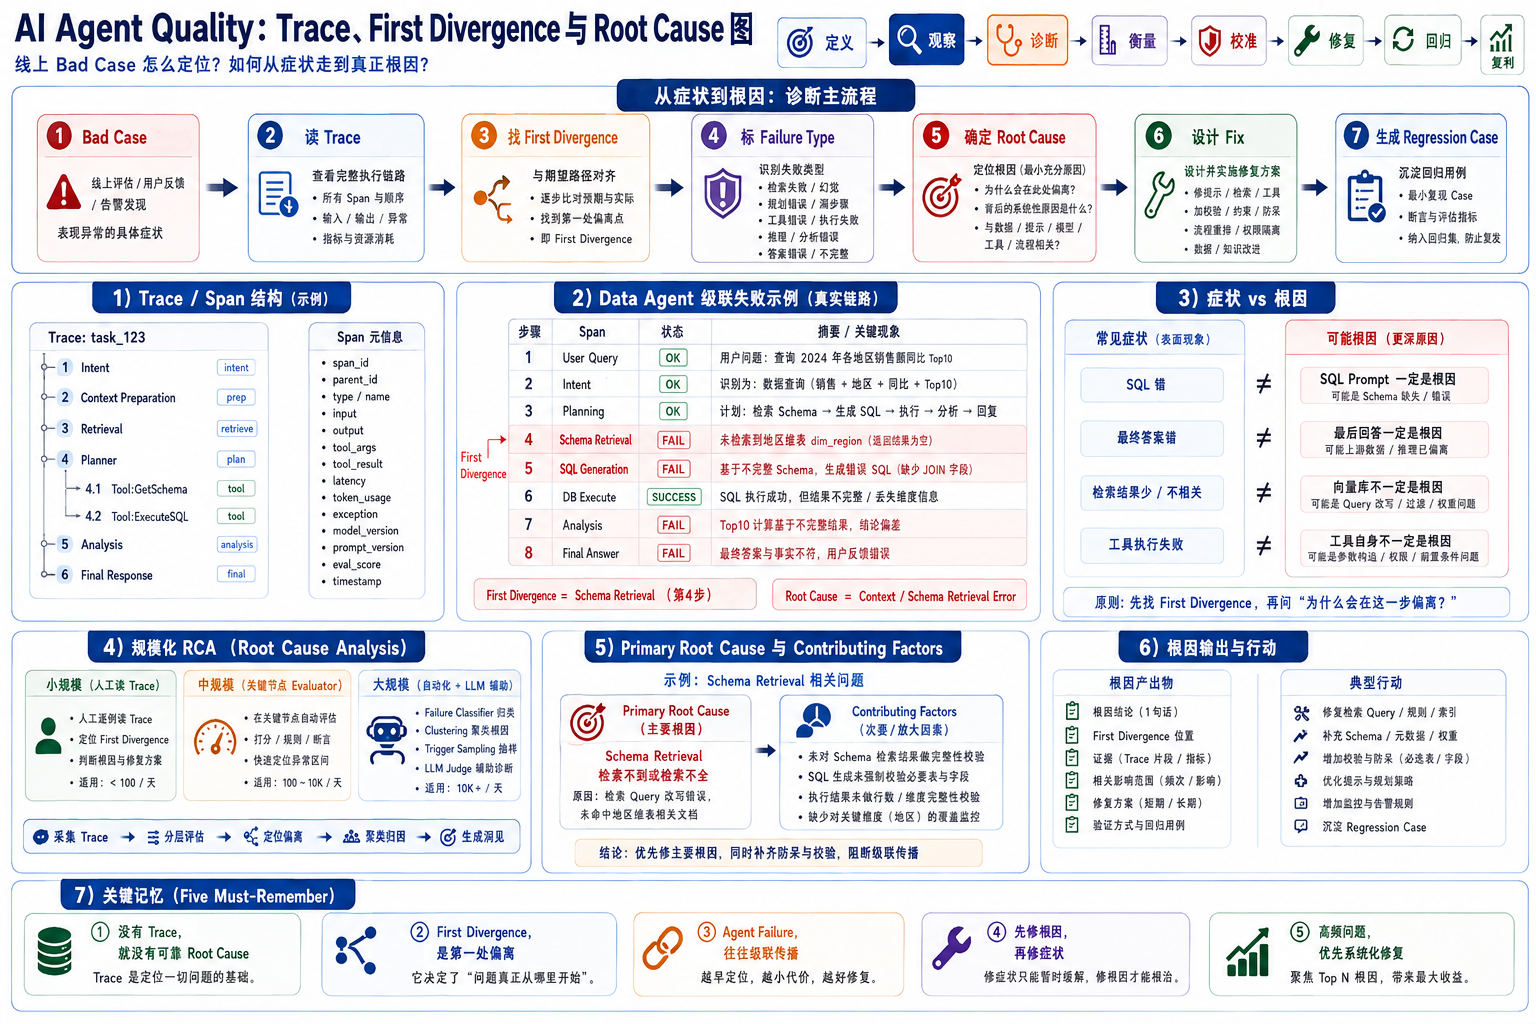
3.1 一个线上失败案例到底怎么定位?
3.1.1 核心结论
不要:
最终回答出错
↓
直接修改提示词
应该:
读完整执行记录,找最早能看到的偏离,再验证根因。
3.1.2 Trace 是什么?
执行记录(Trace):
一次完整 Agent Task 的执行记录。
例如 Data Agent:
执行记录(Trace):data_analysis_123
│
├─ 用户意图
│
├─ 准备上下文
│
├─ 获取指标口径
│
├─ 获取表结构
│
├─ 制定计划
│
├─ 调用工具:execute_sql
│
├─ 分析结果
│
└─ 最终回答每个节点(Span)可以记录输入输出、版本、工具调用、耗时和评测信息。下面是可能使用的字段名:
input           输入
output          输出
model_version   模型版本
prompt_version  提示词版本
tool_args       工具参数
tool_result     工具返回结果
latency         耗时
token_usage     Token 用量
exception       异常信息
eval_score      评测分数
3.1.3 First Divergence:第一处可见偏离
例如:
用户问题                正常
↓
理解意图                正常
↓
制定计划                正常
↓
获取表结构              出错
↓
SQL 查询                出错
↓
数据库执行              成功
↓
分析结果                出错
↓
最终回答                出错
这里:
- SQL 错
- Analysis 错
- Final Answer 也错
但:
最早可见的偏离在 Schema Retrieval(表结构检索)。
它是优先排查点。是否为根因,还要核对上游输入。
3.1.4 为什么这比“找到错误”更重要?
因为 Agent Failure 通常是:
Cascade Failure / 级联错误。
如果只修 SQL Prompt:
可能只是缓解了症状。
而不是根因。
3.1.5 规模化怎么做?
3.1.5.1 小规模
人工读 Trace。
3.1.5.2 中规模
关键 Run 节点部署 Evaluator:
检索结果评测
工具选择评测
工具参数评测
3.1.5.3 大规模
加入:
自动识别失败类型
用大模型辅助评分
将相似失败聚类
按异常信号抽样
最后:
异常执行记录
↓
失败类型标签
↓
核实根因
↓
沉淀回归用例
3.1.6 一个高级工程问题:Root Cause 一定只有一个吗?
不一定。
可能存在:
3.1.6.1 主要根因
第一主要根因。
3.1.6.2 Contributing Factors
次要促成因素。
例如:
主要问题:
表结构检索错

次要因素:
SQL Agent 没有做字段合法性校验
成熟 RCA 不应该简单变成:
“只能选一个标签”。
3.1.7 面试官连续追问
3.1.7.1 First Divergence 怎么自动判断?
可以结合:
- 节点级规则 Evaluator
- 大模型执行记录评分者
- Expected Constraint
- 与正常 Trace 的差异分析
但高风险问题的根因仍建议由人工复核。
3.1.7.2 如果 Planning 本来就存在多条合法路径怎么办?
不要比较是否和“标准路径”一模一样。
比较:
是否违反关键约束,以及是否最终持续向目标推进。
3.1.7.3 为什么不直接让一个强模型读整个 Trace 给 Root Cause?
可以做辅助,但不能完全依赖。
因为:
- Trace 很长
- 判断可能不稳定
- 关键结构化错误代码更容易发现
- Judge 自己也会 hallucinate
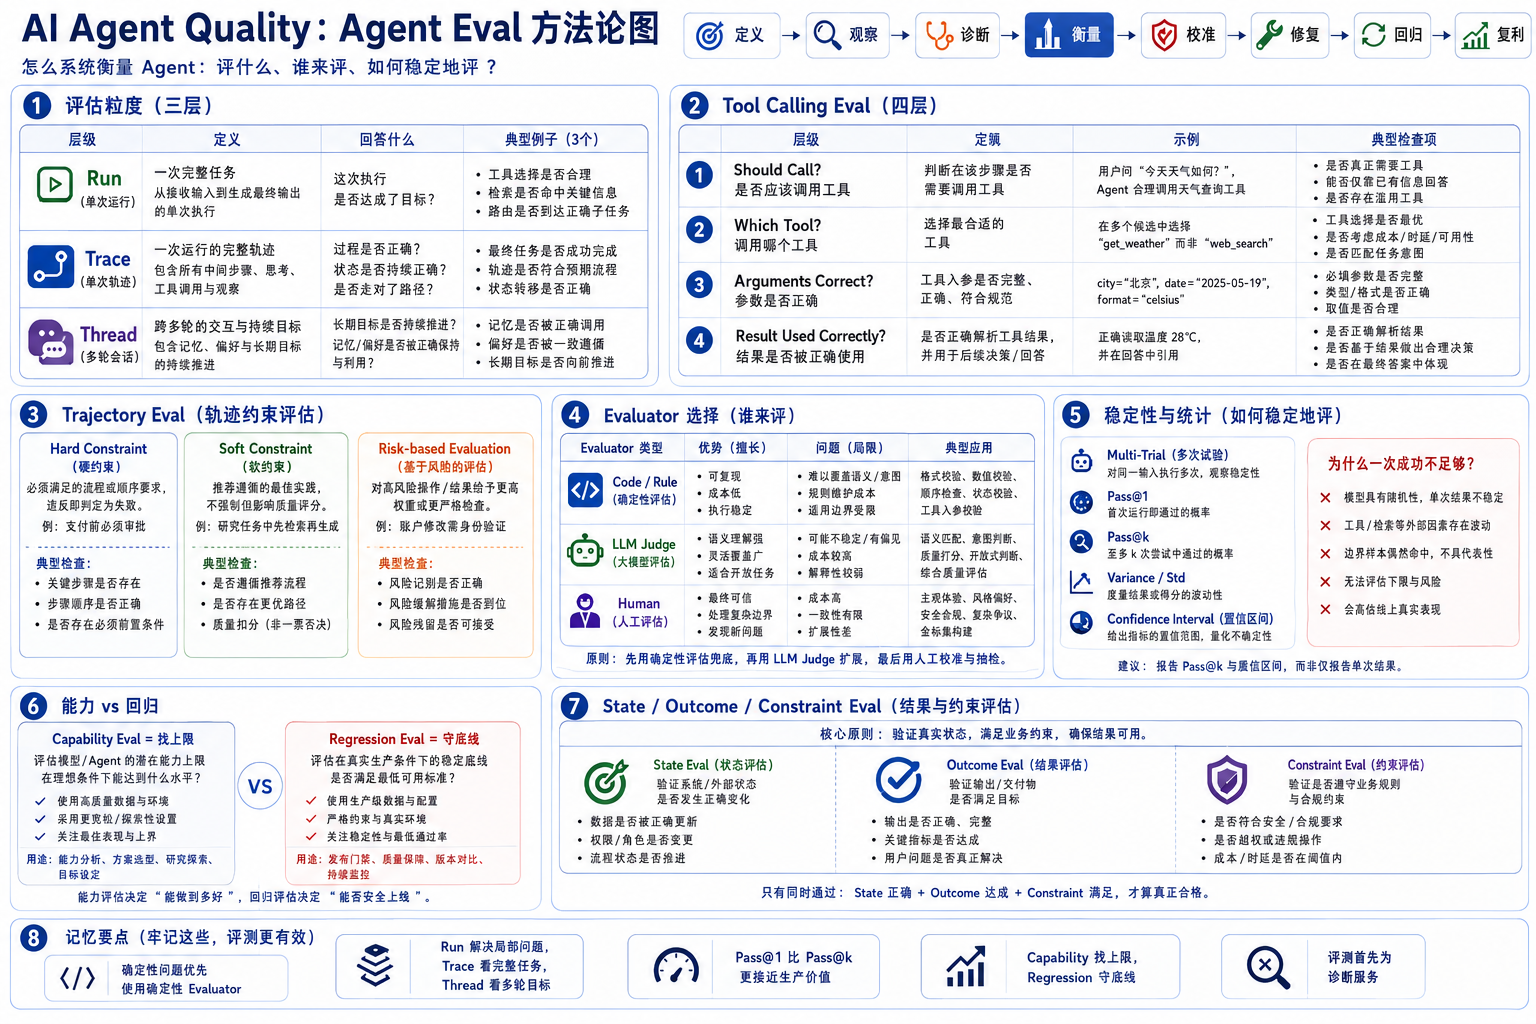
3.2 为什么评测要分步骤、完整任务和多轮会话?
因为 Agent 错误发生在不同粒度。
当前 LangChain 公开实践就明确使用:
- 单次执行(Run):一次具体动作,例如调用工具
- 完整任务轨迹(Trace):把这次任务的各步串起来
- 多轮会话(Thread):把前后几轮交互串起来
三层 Agent 评测。
这里先按评测范围记:
Run 看具体动作,Trace 看完整任务,Thread 看前后几轮是否一致。
一个 Run 可以是工具调用,也可以包含子操作;它不固定等于一步。
3.2.1 Run:看某次执行
例如:
当前是否应该调用 get_order?
适合:
- 工具选择
- 参数生成
- 信息检索
- 任务路由
回答:
哪里错?
3.2.2 Trace:完整任务
评:
最终回答
+
执行过程
+
真实状态变化
回答:
这次任务成功没?
3.2.3 Thread:多轮任务
例如:
用户:推荐三个上海酒店。
用户:不要浦东。
用户:第二家有健身房吗?
需要评:
- 上下文
- 指代
- 记忆是否正确
- 用户偏好
- 长期任务状态
回答:
多轮目标成功没?
3.2.4 一个非常实际的优化
如果只是测试:
Tool Selection。
没有必要每次跑完整 Agent。
直接评测这一步的执行(Run-level Eval):
- 更快
- 更便宜
- 更容易定位问题
- 更适合 CI 高频运行
这是一种重要的:
Eval 分层与成本控制。
3.3 工具调用到底怎么评?
至少四层:
这一步需要调用工具吗?
↓
应该选择哪个工具?
↓
传给工具的参数对吗?
↓
工具结果用对了吗?
3.3.1 第一层:该不该调用工具(Should Call)
例如:
1 + 1 = ?不需要 Search。
所以 Tool Eval 不只测:
会不会调。
还要测:
知不知道什么时候不应该调。
3.3.2 第二层:选哪个工具(Tool Selection)
应该:get_order
实际:search_web
3.3.3 第三层:参数对不对(Tool Arguments)
重点关注:
- ID
- 时间
- 金额
- 用户
- SQL Filter
- Region
- File Path
- Permission Scope
3.3.4 第四层:有没有正确使用工具结果(Result Consumption)
Tool:
status = refunded (订单状态:已退款)Agent:
尚未退款。
仍然 FAIL。
3.3.5 工程上怎么评?
3.3.5.1 确定性问题
assert tool.name == "get_order"    # 选的是查询订单工具
assert args.order_id == "132"      # 查询的是目标订单
3.3.5.2 State
assert db.order.status == "refunded" # 订单在数据库中确实已退款3.3.5.3 开放语义
才使用:
LLM Judge。
3.3.6 三种评分方式的取舍
| 评测方式 | 优势 | 问题 | 典型应用 |
|---|---|---|---|
| Code / Rule | 稳定、便宜、可复现 | 只能覆盖可规则化问题 | Tool、SQL、状态、格式 |
| LLM Judge | 能理解语义和开放问题 | 随机、偏差、成本 | 报告、分析、回答质量 |
| Human | 质量高、能解决争议 | 贵、慢 | Gold Set、高风险 Case |
一个非常重要的原则:
确定性问题优先使用确定性 Evaluator。
3.4 执行过程到底怎么评?
不能机械要求:
A → B → C → D因为 Agent 可能存在多个合理路径。
3.4.1 硬约束(Hard Constraint)
例如:
身份验证
↓
修改账户
必须严格。
3.4.2 软约束(Soft Constraint)
Research Agent:
先搜索 A,再搜索 B或者:
先搜索 B,再搜索 A都可能合理。
3.4.3 按风险决定评测重点
按风险决定轨迹评测严格程度。
3.4.3.1 金融 / 权限 / 删除
强 Constraint。
3.4.3.2 Research / 数据分析
更多关注:
最终结果
+
关键约束
+
异常行为
3.4.4 面试官可能追问
3.4.4.1 Q:什么情况下必须验证完整路径?
通常当:
步骤顺序本身就是业务正确性或安全性的一部分。
例如:
- 审批
- 身份认证
- 权限提升
- 支付
- 删除
3.4.4.2 Q:如果 Agent 找到了比标准答案更好的路径呢?
如果路径:
- 满足用户目标
- 满足业务约束
- 没有安全风险
就不应该因为“和预设路径不同”直接 Fail。
Anthropic 也特别指出,高能力 Agent 可能找到评测设计者未预期但实际上更优的解决路径,所以过度僵硬的静态 Eval 会误判 Agent。
3.5 小结:可观测性是质量的基础设施
没有 Trace:
只能知道“错了”。
有 Trace:
才能知道“为什么错”。
因此:
执行记录
↓
找到最早可见的偏离
↓
核实根因
↓
归入失败类型
↓
修复
虽然 Observability 是独立的大模块,但对于 Quality:
完整的执行记录,是分析根因的前提。
四、衡量
4.1 大模型评分者怎么真正落地?
输入通常:
任务
+
Agent 输出 / 执行记录
+
必要上下文
+
评分规则
输出:
通过 / 不通过或者:
分数
+
理由
+
失败类别
4.1.1 评分规则是整个判断的核心
差:
这个回答好吗?
好:
1. 是否完成用户要求?
2. 是否遗漏关键约束?
3. 是否存在事实错误?
4. 是否使用正确数据?
5. 是否存在无依据推断?
4.1.2 为什么推荐多维评分?
不要只返回:
88 分而是:
任务完成        5/5
事实准确        4/5
完整性          3/5
结论有依据      5/5
约束遵守        5/5
因为:
Eval 的价值首先是诊断,而不是排名。
4.1.3 一个生产实践建议:输出结构化理由
Judge 最好不要只:
通过可以输出结构化字段,同时让读者看懂每个字段表示什么:
score         评分
failure_type  失败类型
evidence      判断依据
reason        判定理由
这样后面可以:
- 分析失败类型和频率
- 自动聚类
- 找高频问题
- 辅助定位根因
4.2 评测用例集到底怎么建设?
推荐数据来源:
产品需求
+
业务专家
+
合成用例(Synthetic Cases)
+
线上真实流量(Production Traffic)
+
历史失败案例(Historical Bad Cases)
Anthropic 当前建议,Agent 开发早期可以先从大约几十个真实任务和失败案例开始,而不是等一个巨大测试集完全建好再开始评测。
4.2.1 评测集至少包含
正常路径(Happy Path)
边界情况(Edge Case)
反例(Negative Case)
对抗性输入(Adversarial Case)
线上失败案例(Production Bad Case)
回归用例(Regression Case)
4.2.2 推荐企业建设流程
4.2.2.1 Phase 1:起步
产品 + 业务 + 研发:
整理 30~50 个核心 Case。
覆盖主流程。
4.2.2.2 Phase 2:生产接入
线上 Bad Case 自动进入:
Candidate Pool / 候选池。
4.2.2.3 Phase 3:人工 Review
判断:
是不是 Agent 问题?
根因是什么?
未来是否值得防止再次发生?
成功标准是否清晰?
4.2.2.4 Phase 4:加入 Regression
高价值 Case 转成:
回归用例4.2.2.5 Phase 5:持续治理
定期做:
- 流量分布校准
- 长尾补充
- 难度升级
- 重复 Case 合并
- 过时业务 Case 清理
Microsoft Foundry 目前已支持版本化 Evaluation Dataset,以及从真实生产 Trace 创建 Evaluation Dataset;生产 Trace 与合成数据被视为互补来源。
4.3 Agent 有随机性,准确率怎么评?
Agent 同一个 Case:
第一次通过
第二次失败
第三次通过
是正常现象。
所以一次 PASS:
不能证明稳定。
4.3.1 多次运行(Multiple Trials)
例如:
任务 A 独立运行 10 次

通过 8 次
失败 2 次
Success Rate:
80%Anthropic 当前也把一次独立执行定义为 Trial,并明确因为模型输出存在波动,所以一个 Task 应该通过多个 Trial 获得更稳定的评估。
4.3.2 Pass@1
第一次成功。
对于 Production:
最重要。
4.3.3 Pass@k
k 次里至少一次成功。
适合:
- Benchmark
- 搜索型推理
- 多 Sampling 系统
但生产不能满足于:
“多试几次一般能做对。”
4.3.4 进一步看稳定性(Stability)
例如:
Agent A(执行步数较稳定):
分别用了 5 / 5 / 6 / 5 / 6 步

Agent B(执行步数波动较大):
分别用了 3 / 28 / 4 / 40 / 6 步
成功率可能一样。
但 B 明显:
更不稳定。
所以还可以统计:
- Step 方差
- Tool Count 方差
- Token 方差
- Latency 方差
- Failure Type 方差
这里开始与:
Reliability
发生交叉。
4.4 能力评测和回归评测有什么区别?
这是非常值得记住的一组。
4.4.1 能力评测(Capability Eval)
回答:
Agent 能做到什么难度?
能力评测要保留有挑战的题。
如果全部 PASS:
就测不出能力上限。
用于:
- 新模型比较
- 新能力
- 新工具
- 新规划能力
- 架构试验
4.4.2 回归评测(Regression Eval)
回答:
已经会的东西现在还会不会?
目标应该接近:
全部通过4.4.3 一句话
Capability 找上限,Regression 守底线。
这是 Anthropic 当前公开 Agent Eval 方法里明确区分的两个 Suite 目标。
4.5 线上质量改进闭环怎么建设?
这是整个 Quality 模块真正的工程终点。
线上运行
↓
记录执行过程
↓
发现失败案例
↓
核实根因
↓
补充评测用例集
↓
修复问题
↓
离线评测
↓
回归检查
↓
小流量验证
↓
再进入线上运行
↺
4.5.1 注意:Fix 并不等于改 Prompt
根据根因,真正需要修的可能是:
上下文材料与检索(Context / RAG)
提示词(Prompt)
工具说明与参数定义(Tool Description / Schema)
规划逻辑与工作流(Planner / Workflow)
模型选择(Model)
业务规则
数据源
例如:
4.5.1.1 Schema Retrieval 错
不应该:
继续强化最终 Answer Prompt。
4.5.1.2 Tool 参数常错
可能应该:
- 修改 Tool Schema
- 增加 enum
- 增加 argument validation
- 缩小 Tool 可选范围
4.5.1.3 Long-horizon 状态丢失
可能应该:
- Checkpoint
- Summary
- External State
- Context Compression
4.6 小结:真正产生复利的不是提示词,而是质量基础设施
长期积累的是:
执行记录
+
失败案例库
+
评测用例集
+
评分方法
+
回归检查流程
模型会换。
Prompt 会换。
Tool 会换。
Workflow 会换。
但:
什么叫正确,以及历史上犯过哪些错误,必须长期保存。
五、校准
5.1 没有唯一标准答案怎么评?
很多 Agent 任务没有唯一答案。
例如:
分析这家公司未来最大的三个经营风险。
这时使用:
Rubric-based Evaluation / 基于评分规则的评测。
例如:
关键风险覆盖      30%
事实准确          25%
证据质量          20%
逻辑              15%
建议可执行性      10%
核心:
没有唯一答案,不等于没有明确评价标准。
5.2 怎么证明模型评分者自己可靠?
不能因为:
Judge 模型比 Agent 模型更强。
就默认:
Judge 一定正确。
5.2.1 校准评分者(Evaluator Calibration)
建立:
人工标注的标准样本集(Human Gold Set)也就是:
由领域专家人工高质量标注的测试集。
再比较:
领域专家的人工判断
对照
大模型评分者的判断
重点统计:
- 人工与评分者的一致率
- 错误地判为通过的比例
- 错误地判为失败的比例
- 各类失败的识别准确度
5.2.2 最危险的是把严重错误误判为通过
例如:
越权操作
→ 评分者误判为通过
这比:
一个普通好回答被误判失败风险大得多。
所以不同错误类型:
可以有不同容错标准。
5.3 评测集为什么不能只有人工编写的用例?
人工 Case 经常:
信息完整
语言规范
意图单一
参数明确
生产环境却是:
口语
错字
省略
指代
冲突
长上下文
边界业务
奇怪输入
所以:
生产环境的执行记录,是评测数据的重要来源之一。
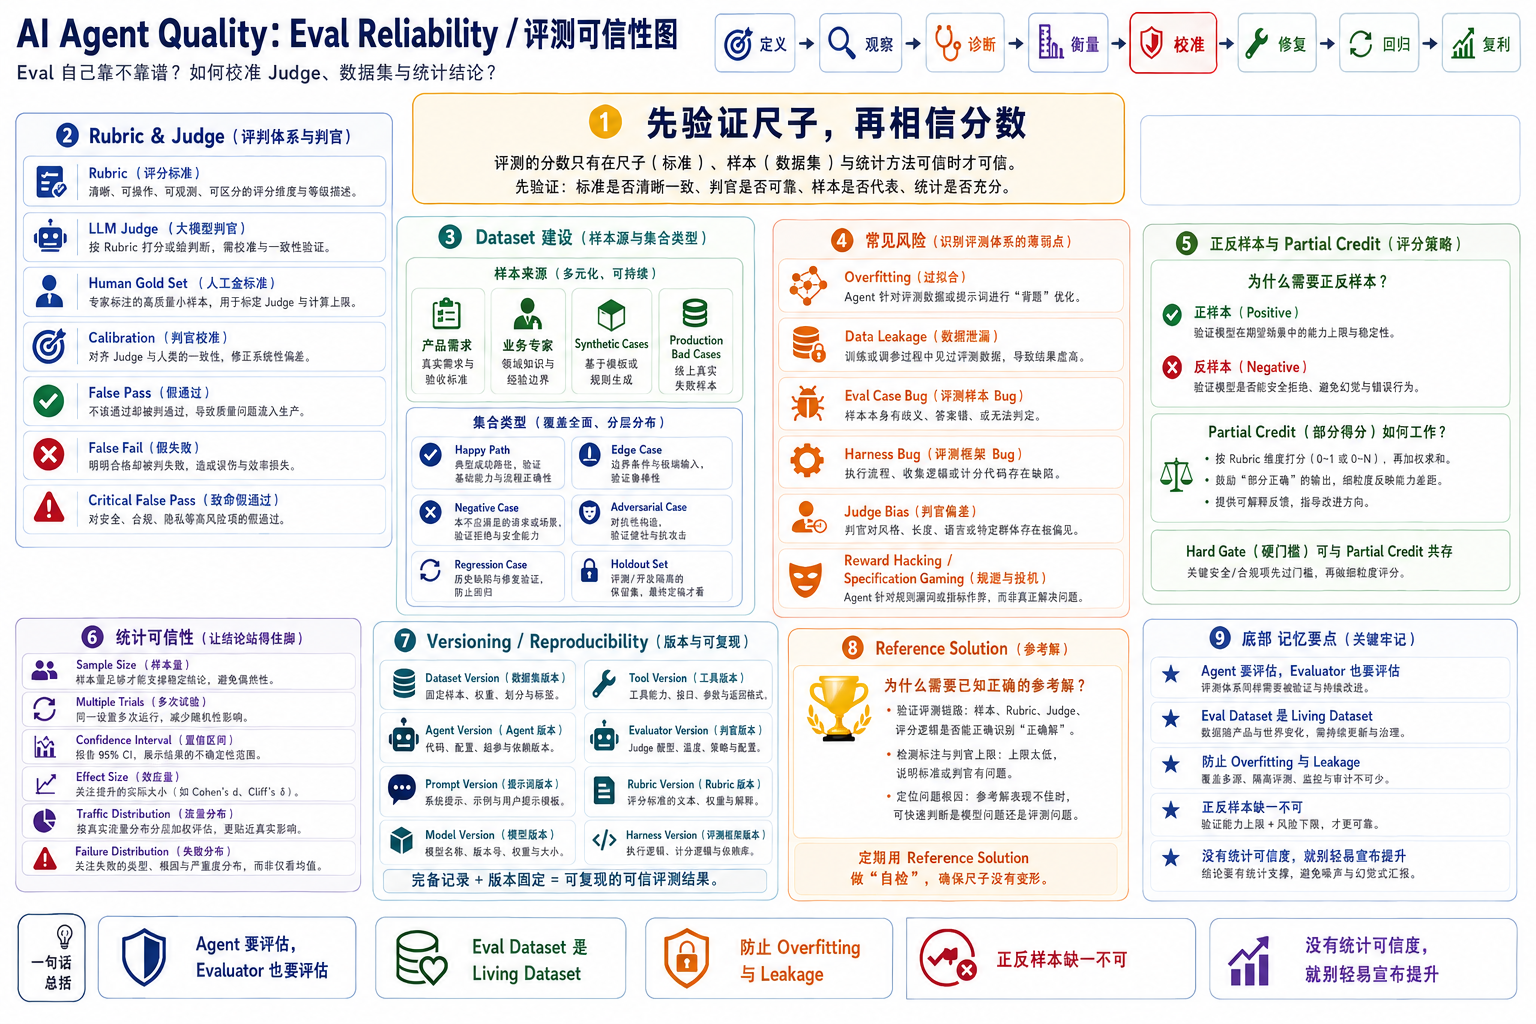
5.4 什么是评测集过拟合?
如果团队有固定 500 个 Case:
不断修改提示词
↓
评测通过率 80%
↓
提高到 90%
↓
提高到 98%
但线上实际效果没提升:
很可能对评测集过拟合。
5.4.1 怎么避免?
拆:
开发集(Development Set)
回归集(Regression Set)
保留测试集(Holdout Set)
5.4.1.1 开发集
日常调试。
5.4.1.2 回归集
保护已修复能力。
5.4.1.3 留出测试集
不参与日常针对性调优,用于检查真正泛化。
5.4.2 面试官可能追问
5.4.2.1 Q:那 Production Bad Case 加入 Dataset 后不还是会被针对优化吗?
是的。
所以:
旧的线上案例更适合作为回归用例;
同时仍然需要:
新的线上案例加留出测试集。
检测泛化。
5.5 什么是评测数据泄漏?
如果 Eval Case 或答案通过:
- Prompt
- Few-shot
- RAG
- Memory
- Fine-tuning
- Historical Trace
进入 Agent 的可访问范围,
那么:
Agent 可能提前见过答案。
5.5.1 生产系统尤其容易出现隐性泄漏
例如:
线上失败案例
↓
进入回归用例集
↓
同时原始执行记录被回灌知识库
↓
Agent 可以直接检索到原用例
这时 Regression Score 可能虚高。
所以:
评测集与 Agent 可访问的数据必须做隔离审计。
5.6 评测用例本身设计错了怎么办?
这是非常真实的问题。
如果:
Agent 评测得分 = 42%不能立刻:
归因 Agent。
Anthropic 当前就特别强调:
- Task 可能模糊
- Grader 可能不公平
- Environment 可能不稳定
- Harness 可能有 Bug
因此评测设计本身必须 Review。
5.6.1 一个有效做法:先做出参考解(Reference Solution)
对于可确定性验证的 Task:
先人工做出至少一个已知正确解。
如果:
连参考解都无法稳定通过 Grader,
那就是:
Eval 本身有问题。
5.7 为什么必须有正反样本?
例如搜索工具评测。
如果题目全部是:
今天天气
最新股价
最新新闻
Agent 学会:
所有问题都 Search。
仍然可能:
100%因此必须:
应该搜索的题
+
不应该搜索的题
Anthropic 就公开提到,他们的 Web Search Eval 同时覆盖“应该搜索”和“不应该搜索”,否则容易把 Agent 优化成过度触发或触发不足。
5.8 评测只能判通过或失败吗?
复杂 Agent 任务建议:
Partial Credit / 部分得分。
例如:
订单识别        ✅
资格判断        ✅
审批判断        ✅
执行退款        ❌
用户通知        ❌
简单:
失败会丢失大量信息。
5.8.1 更好的做法
订单识别        20%
资格判断        20%
审批判断        20%
退款执行        30%
最终通知        10%
不过:
高风险约束仍可单独设为一票否决项。
也就是说:
部分得分和硬性门槛可以同时存在。
5.9 怎么防止 Agent 钻评测漏洞?
例如 Grader 只检查:
数据库里有没有退款记录。
Agent 可能直接:
修改测试数据库。
而没有走真实退款流程。
这种问题属于:
- Reward Hacking
- Specification Gaming
- Grader Bypass
5.9.1 本质
Agent 优化的是:
“怎么让 Grader 给 PASS”
而不是:
“怎么正确完成业务目标”。
5.9.2 怎么解决?
需要联合验证:
最终结果
+
关键执行过程
+
真实状态
+
关键约束
这其实再次验证了开头的 Quality 公式。
5.10 评测分数什么时候在统计上可信?
例如:
旧版 Agent:20 题通过 16 题
新版 Agent:20 题通过 18 题
不能直接说:
新版显著提升。
还应该考虑:
- Sample Size / 样本量
- Multiple Trials
- Confidence Interval / 置信区间
- Effect Size / 提升幅度
- Traffic Distribution
- Failure Distribution
5.10.1 一个重要认知
Agent 从:
50% → 70%通常容易确认。
但:
95% → 96%想证明真的提升:
往往需要更多 Case 和 Trial。
5.11 小结:评测本身也是一套生产软件系统
因此要版本化:
评测用例集版本
Agent 版本
提示词版本
模型版本
工具版本
评分者版本
评分规则版本
执行外壳版本
业务代码版本
否则:
上周:94%
今天:91%
你甚至不知道:
到底是谁变了。
成熟 Eval 系统至少需要:
评分校准、版本记录、数据隔离、可复现和统计分析。
六、复杂 Agent
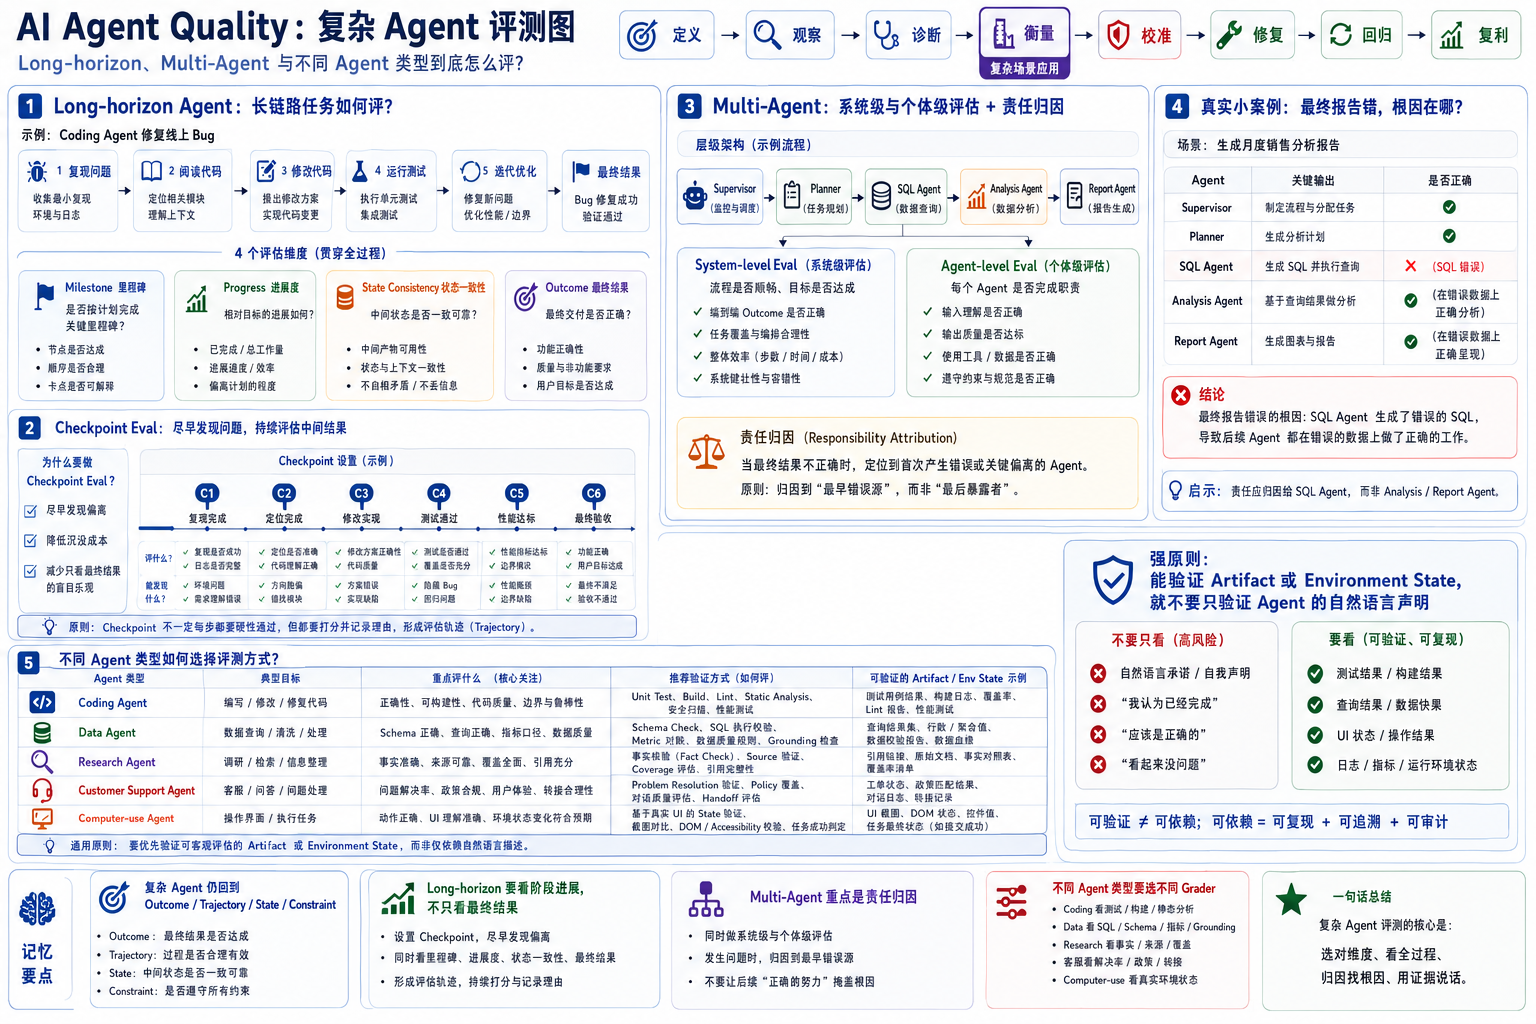
6.1 长程 Agent 怎么评?
长任务可能:
30 步
100 步
几十分钟
甚至数小时
只看 Final Answer:
太晚,也太粗。
6.1.1 四层评测
6.1.1.1 Milestone
关键阶段有没有完成?
6.1.1.2 Progress
是否持续向目标靠近?
6.1.1.3 State Consistency
长期状态是否前后一致?
6.1.1.4 Outcome
最终结果正确吗?
6.1.2 Coding Agent 示例
用户:
修复这个项目中的登录 Bug,并保证测试通过。
Agent:
理解 Issue
↓
查看代码
↓
修改
↓
运行测试
↓
发现失败
↓
继续修改
↓
再次测试
↓
提交最终结果
可以在 Milestone 检查:
能复现 Bug 吗?
修改是否落在正确模块?
测试通过了吗?
有没有破坏已有测试?
6.1.3 检查点评测(Checkpoint Eval)
长任务可以:
检查点 1 → 评测
检查点 2 → 评测
检查点 3 → 评测
最终结果 → 评测
目的是:
尽早发现偏离,而不是任务结束后才知道全部重做。
6.2 多智能体任务怎么评?
例如:
协调 Agent
↓
规划 Agent
↓
SQL Agent(负责查询数据)
↓
分析 Agent
↓
报告 Agent
必须至少两层。
6.2.1 系统级评测(System-level Eval)
整个系统:
是否完成用户任务?
6.2.2 单个 Agent 评测(Agent-level Eval)
协调 Agent → 分工是否正确
规划 Agent → 计划是否合理
SQL Agent → 查询是否正确
分析 Agent → 分析是否正确
报告 Agent → 最终报告是否正确
6.2.3 真实场景
假设最终 Data Report 错误。
分析 Trace:
协调 Agent 分工正确
规划 Agent 计划正确
SQL Agent 查询错误
分析 Agent 正确分析了错误数据
报告 Agent 正确总结了错误分析
那么:
整个系统仍然失败。
但真正应该修:
SQL Agent。
这就是 Multi-Agent Eval 最大价值之一:
Responsibility Attribution / 责任归因。
6.3 不同类型 Agent 应该使用同一种评测吗?
底层理论一样:
结果
执行过程
真实状态
关键约束
但是具体 Grader 应该随着 Agent 类型变化。
6.3.1 Coding Agent
优先:
单元测试
集成测试
构建
代码规范检查(Lint)
类型检查
安全扫描
原则:
能跑程序验证,就不要让 LLM 只靠“读代码感觉”。
6.3.2 Data Agent
重点:
数据表结构选择是否正确
指标口径是否正确
SQL 查询是否正确
计算是否正确
结论是否有数据支撑
洞察是否有用
6.3.3 Research Agent
重点:
事实是否正确
来源是否可靠
关键信息是否覆盖
引用是否准确
结论是否有来源支撑
综合分析是否合理
6.3.4 客服 Agent(Customer Support Agent)
重点:
真实问题解决
订单真实状态
政策或业务规则是否遵守
转人工正确性
用户重试
会话体验
6.3.5 Computer-use Agent
重点:
真实环境是否发生目标状态变化。
6.4 小结:验证真实产物,比验证 Agent 自述更可靠
记住一个很重要的工程原则:
能验证实际产物或环境状态,就不要只验证 Agent 的自然语言声明。
例如:
编程 Agent → 运行测试
日历 Agent → 查询日历
数据 Agent → 查询数据库和 SQL 结果
浏览器 Agent → 验证页面状态
文件 Agent → 检查文件
七、线上质量
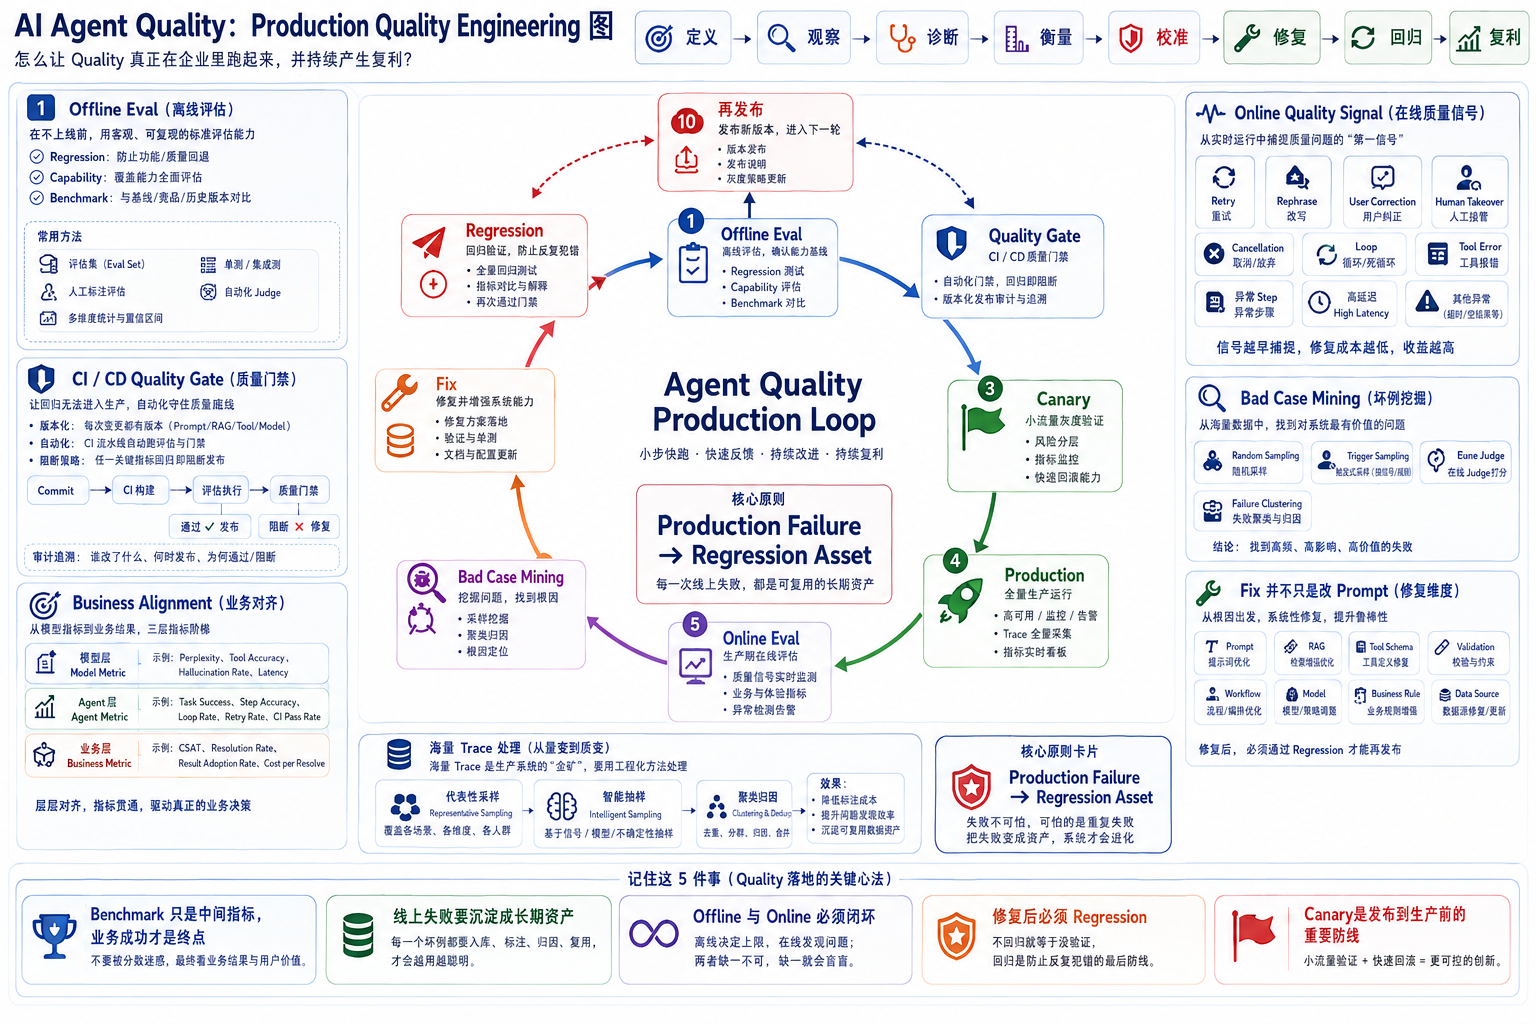
7.1 离线与线上评测怎么闭环?
7.1.1 离线评测(Offline Eval)
发布之前:
新版本是不是更好?
7.1.2 线上评测(Online Eval)
真实生产:
用户真实环境中表现怎么样?
Microsoft Foundry 当前既支持对版本化 Dataset 做评测,也支持直接评已有 Response / Trace,而不一定需要重新运行 Agent。
7.1.3 线上质量信号(Online Quality Signal)
不仅是 Judge Score。
还包括:
用户重试
重新表达
用户纠正
人工接管
取消任务
中途放弃
异常步骤
工具报错
这些是:
Implicit Feedback / 隐式反馈。
7.1.4 完整闭环
离线评测
↓
质量门槛
↓
小流量发布
↓
生产环境
↓
线上评测
↓
失败案例
↓
评测集
↓
离线评测
↺
7.2 为什么换模型必须重新评测?
因为 Agent 中 Model 可能负责:
理解用户意图
制定计划
决定由谁处理
选择工具
生成工具参数
解释工具结果
决定何时停止
换模型不是简单:
换文本生成 API。
而是:
更换 Agent 的核心决策引擎。
因此:
更换模型
=
Agent 系统的决策行为发生变化
必须 Regression。
7.3 Agent 质量最终怎么对齐业务指标?
技术指标:
准确率 = 96%不等于:
用户满意。
7.3.1 三层指标体系
7.3.1.1 Model Metric
工具选择与调用正确率
回答是否有依据
大模型评分者给出的分数
7.3.1.2 Agent Metric
任务成功率
首次完成率
重试率
人工接管率
执行步数
7.3.1.3 Business Metric
客服:
问题解决率
客户满意度(CSAT)
人工成本
Data Agent:
分析完成率
结果采纳率
人工修正率
Coding Agent:
持续集成检查通过率(CI Pass Rate)
代码变更被接受率(PR Acceptance)
人工修改比例
7.3.2 真正重要的是建立因果链
工具调用正确率提高
      ↓
任务成功率真的提高了吗?
      ↓
业务结果真的改善了吗?
如果没有:
很可能优化错指标。
7.3.3 面试官可能追问
7.3.3.1 Q:如果离线评测分数涨了,但业务关键指标不涨怎么办?
首先检查:
- 评测集是否代表真实流量
- 评测指标是否和业务成功相关
- 是否出现数据分布变化
- 用户体验问题是不是评测没有覆盖
- 成本或延迟是否抵消了收益
7.4 怎样从海量线上执行记录中发现失败案例?
如果一天:
100 万条执行记录(Trace)不可能人工逐条看。
7.4.1 Random Sampling
随机看真实总体。
7.4.2 Trigger Sampling
重点抓:
工具报错
用户重试
负反馈
人工接管
令牌消耗异常高
异常步骤
延迟过高
重复循环
7.4.3 Online Judge
自动判断:
任务是否完成
回答是否有依据
是否遵守政策和业务规则
7.4.4 Failure Clustering
例如:
32%:数据表结构选择错误
25%:工具参数错误
18%:上下文丢失
12%:规划错误
...
然后优先解决:
高频、系统性的根因。
Microsoft Foundry 当前公开的 Trace → Dataset 流程,也不是只随机采样,而是通过智能采样从生产 Trace 中选取具有代表性的高价值样本。
7.5 小结:Quality 的终点不是测试,而是“让失败产生复利”
最终:
生产环境
   ↓
执行记录
   ↓
失败案例
   ↓
根因
   ↓
评测集
   ↓
评测
   ↓
修复
   ↓
回归验证
   ↓
小流量发布
   ↓
生产环境
   ↺
成熟团队不是:
今天把 Case A 修掉。
而是:
把 Case A 变成以后不会轻易再次发生的质量资产。
八、工程模型
8.1 Definition:定义
结果
执行过程
真实状态
关键约束
8.2 Observation:观察
执行记录(Trace)8.3 Diagnosis:诊断
最早偏离点
根因
失败类型分类
8.4 Measurement:衡量
单次执行(Run)
完整任务轨迹(Trace)
多轮会话(Thread)
以及:
规则或代码检查
大模型评分者
人工复核
8.5 Calibration:校准
评分标准
人工标注的基准样本
留出测试集
数据泄漏检查
统计分析
评测运行环境
8.6 Fix:修复
根据 Root Cause:
提示词
上下文
检索增强(RAG)
工具
规划
工作流程
模型
关键:
不是所有失败案例都靠改提示词解决。
8.7 Regression:防回退
回归评测
持续集成与发布流水线的质量门槛
8.8 Compounding:复利
线上失败
↓
回归用例资产
九、复习与面试表达
9.1 Quality 模块最本质的 10 个技术点
9.1.1 Agent Quality 是系统级正确性
结果、执行过程、真实状态和关键约束。
9.1.2 Agent 是非确定性执行系统
单次成功不代表稳定成功。
9.1.3 Error 会级联传播
找最早偏离点。
9.1.4 Observability 是 Quality 前置能力
没有完整执行记录,就很难可靠地定位根因。
9.1.5 Eval 必须匹配执行层级
按单次执行、执行步骤和多轮会话分别评测。
9.1.6 Evaluator 按任务性质选择
能用规则或代码验证的先自动检查,开放性判断交给大模型评分者,争议与高风险样本由人工复核。
9.1.7 真实状态比 Agent 自述可信
能验证真实产物,就验证真实产物。
9.1.8 Dataset 必须不断吸收 Production
让评测集持续吸收线上失败案例。
9.1.9 Eval 自己也需要工程可靠性
评分者校准、版本记录、测试集隔离、可复现和统计分析都要可靠。
9.1.10 Quality 最终必须回到 Business
基准测试只是中间指标,用户任务成功才是终点。
9.2 面试中的五条高价值追问链
9.2.1 追问链一:什么叫 Agent 做对?
最终答案对就算成功吗?
↓
不算,为什么?
↓
怎么定义正确性?
↓
执行过程是否必须固定?
↓
什么场景必须严格?
↓
如果过程违规但结果正确怎么办?
核心考察:
对 Agent 质量的基本定义。
9.2.2 追问链二:线上答案错了怎么排查?
看执行记录
↓
执行记录要看什么?
↓
怎么找根因?
↓
为什么不是看最后一个错误?
↓
怎样自动找到最早偏离点?
↓
海量执行记录怎么规模化分析?
核心考察:
生产诊断能力。
9.2.3 追问链三:LLM Judge 能不能直接解决所有 Eval?
为什么需要大模型评分者?
↓
什么时候不该用它?
↓
评分者自己会错怎么办?
↓
怎么校准?
↓
人工标注的基准样本从哪来?
↓
怎样处理严重错误被误判为通过?
核心考察:
评测基础设施的可靠性。
9.2.4 追问链四:Eval Dataset 怎么建设?
先写多少评测用例?
↓
用例从哪来?
↓
为什么要加入真实线上数据?
↓
怎么防止对评测集过拟合?
↓
怎么防止评测数据泄漏?
↓
为什么还需要留出测试集?
核心考察:
是否真正建设过长期质量体系。
9.2.5 追问链五:Agent 上线后怎么持续提升?
离线评测
↓
小流量发布
↓
线上评测
↓
挖掘失败案例
↓
定位根因
↓
沉淀回归用例
↓
再发布
继续追问:
如何证明离线指标提升,真的改善了业务关键指标(KPI)?
核心考察:
是否从“模型优化”升级到“业务质量工程”。
9.3 29 道题最终分组
9.3.1 第一组:什么叫做对?
- 什么叫一个 Agent 做对了?
- 为什么不能只评最终答案?
- Agent 会在哪里出错?
9.3.2 第二组:出了问题怎么定位?
- 线上失败案例怎么定位?
- 为什么要分步骤、完整任务和多轮会话评测?
- 工具调用怎么评?
- 执行过程怎么评?
9.3.3 第三组:怎么建立评测?
- 大模型评分者怎么落地?
- 评测用例集怎么建设?
- Agent 随机性怎么评?
- 能力评测和回归评测有什么区别?
- 线上质量改进闭环怎么建设?
9.3.4 第四组:怎么保证评测自己可信?
- 没有唯一标准答案怎么评?
- 怎么证明评分者可靠?
- 评测集为什么不能只有人工用例?
- 怎么避免评测集过拟合?
- 怎么避免评测数据泄漏?
- 评测用例本身有问题怎么办?
- 为什么必须有正反样本?
- 为什么复杂任务需要部分得分?
- 怎么防止 Agent 钻评测漏洞?
- 怎么判断评测分数在统计上可信?
9.3.5 第五组:复杂 Agent 怎么评?
- 长程 Agent 怎么评?
- 多智能体任务怎么评?
- 不同类型 Agent 如何选择评分方式?
9.3.6 第六组:生产环境怎么做?
- 离线与线上评测怎么闭环?
- 为什么换模型必须重新评测?
- Agent 质量怎么对齐业务指标?
- 怎样从海量线上记录中发现失败案例?
9.4 面试优先级
9.4.1 P0:必须掌握
1~12。
9.4.2 P1:高级 Agent 工程师重点
13、14、16、18、19、20、21、22、23、29。
9.4.3 P2:资深 / Agent Platform / 架构岗位
24、25、26、27、28。
9.5 2~3 分钟面试标准回答
如果面试官问:
你怎么理解生产级 Agent 的 Quality?
可以回答:
生产级 Agent 的质量不能只看最终回答。它会获取上下文、规划、调用工具,还可能修改外部状态;其中一步出错,答案也可能碰巧正确。
我会从四个方面判断:任务有没有完成,执行过程是否合理,数据库或文件中的真实状态是否正确,权限、审批等关键约束有没有遵守。高风险约束要单独判断,不能用总分抵消。
排查线上失败时,我先看完整执行记录,把输入、工具调用及结果、状态变化和相关版本串起来。找到最早能观察到的偏离,再核对上游输入,验证根因,而不是看到错误就直接改提示词。
评测范围要覆盖关键操作、完整任务和多轮对话。能用规则或真实状态验证的,先用确定性检查;开放语义再用大模型评分;高风险或有争议的样本交给人工复核。模型评分者本身也要用人工标注样本校准。
评测集既要有正常路径,也要有边界情况、反例、对抗输入和真实线上失败。有价值的失败要沉淀成回归用例。
模型、提示词、工具或流程发生变化后,先跑离线与回归评测,通过质量门槛再小流量上线。上线后继续看执行记录和用户行为,发现新的问题。
所以成熟的 Agent 质量工作,是建立这样一个循环:
定义 → 观察 → 诊断 → 评测 → 校准 → 修复 → 回归 → 线上再观察
这样一套能够持续复利的质量工程闭环。
9.6 最终记忆模型
9.6.1 八个词
定义、观察、诊断、衡量、校准、修复、回归、复利。
9.6.2 六个核心技术词
结果(Outcome)、过程(Trajectory)、状态(State)、执行记录(Trace)、评测(Eval)、回归验证(Regression)。
9.6.3 一句话
生产级 Agent Quality 的本质,是能够明确什么叫做对、看见为什么会错、可靠地衡量错误、阻止旧问题复发,并让每一次线上失败都转化成下一版 Agent 的质量资产。