生产级 AI Agent 面试手册
稳定性 - 如何让 Agent 稳定、可恢复地持续做对?
一、什么叫一个可靠的 Agent?
质量回答:
Agent 这一次有没有做对?
可靠性回答:
Agent 能不能稳定地一次又一次做对?
发生超时、限流、工具失败、工作进程崩溃或重新部署后,还能不能继续?
恢复以后会不会重复退款、重复发邮件、状态错乱,或者把整个系统拖垮?
因此,可靠性不是简单的:
重试 + 超时控制
而是一个完整的系统属性。
整个模块最重要的一句话:
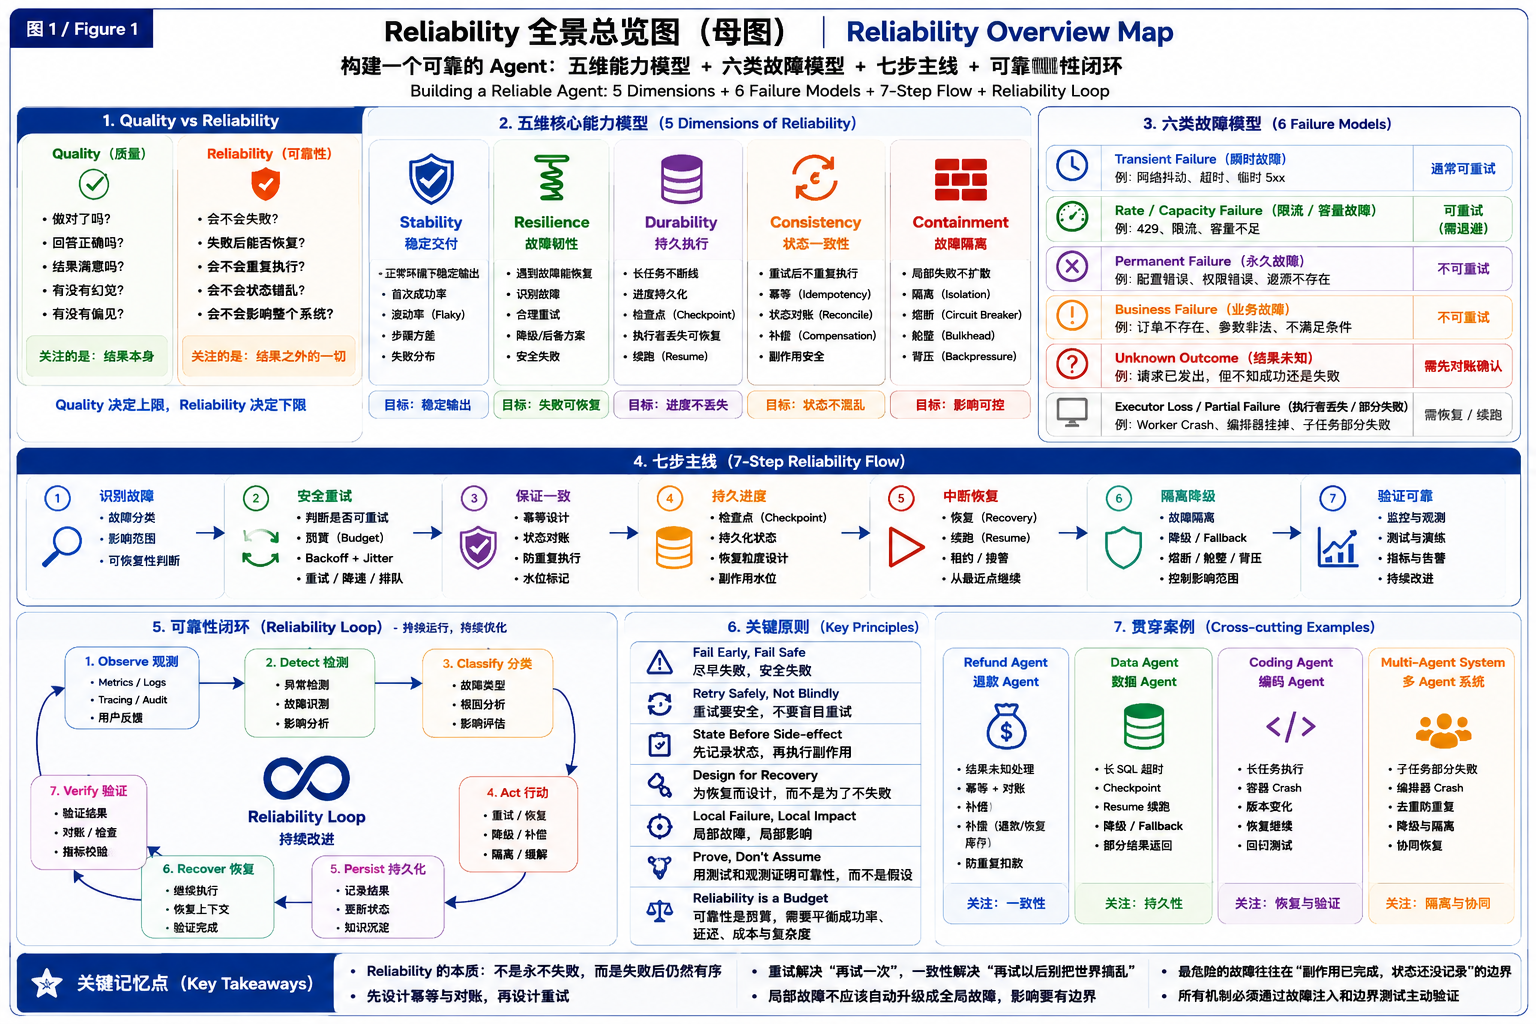
可靠的 Agent,不是永远不失败,而是在失败和中断发生以后,系统仍然有序:故障可判断、重试安全、进度不丢、状态不乱、局部失败不扩散。
1.1 为什么 Agent 比普通服务更容易不稳定?
普通请求经常是:
请求
  ↓
服务
  ↓
响应
Agent 却可能是:
用户目标
  ↓
规划
  ↓
模型
  ↓
工具 A
  ↓
模型
  ↓
数据库
  ↓
工具 B
  ↓
子 Agent
  ↓
模型
  ↓
最终结果
逐项注释(3)
- A
- A:示例标识 A。
- B
- B:示例标识 B。
- Agent
- Agent:智能体。
每一个节点都是潜在故障点。
假设 20 个关键步骤相互独立、每步成功率都是 99%,全部成功的概率约为:
0.99^20 ≈ 81.8%真实步骤并不一定独立,这个数字不能直接当作生产预测;它只是说明一个基本事实:
Agent 链路越长,局部小概率失败越容易累积成端到端失败。
而且 Agent 同时叠加了三类复杂性:
1.1.1 模型行为波动
同一个输入可能产生不同规划和工具路径。
1.1.2 分布式系统故障
模型 API、数据库、Tool、网络都可能超时、限流或失败。
1.1.3 长任务状态
Agent 可能运行几十分钟甚至数小时,中途遇到进程崩溃、内存不足、部署和缩容。
因此,生产级 Agent 的可靠性需要同时面对:
模型行为稳定性 + 分布式系统可靠性 + 长任务持久执行
的交集。
1.2 可靠性的五个核心维度
1.2.1 稳定交付(Stability)
正常环境下:
同一个能力重复执行是否稳定?
关注:
- First-pass Success(首次成功率)
- Flaky Rate(偶发失败率)
- Step Variance(步骤波动)
- Failure Distribution(失败分布)
1.2.2 故障韧性(Resilience)
遇到:
- Timeout(超时)
- 429(限流)
- 500 / 503
- 网络闪断
- 下游暂时不可用
是否可以合理:
- Retry(重试)
- Backoff(退避)
- Fallback(备用方案)
- Fail(安全失败)
1.2.3 持久执行(Durability)
如果:
Agent 已经跑了 40 分钟
↓
工作进程崩溃
↓
运行容器被回收
↓
系统重新部署
逐项注释(1)
- Agent
- Agent:智能体。
任务进度是否仍然存在?
是否能从:
Checkpoint(检查点)
继续,而不是从头重跑?
Microsoft Foundry 的长任务韧性说明(预览功能)区分后台执行和持久执行:后者需要稳定任务身份、输入持久化、通过租约检测执行进程丢失,以及重新进入处理程序。框架提供这些基础能力,应用仍需保存自身进度并防止副作用重复。
Google 对 Agent Executor 的介绍也把持久执行、事件日志和快照作为长任务运行时的能力。
1.2.4 状态一致性(Consistency)
Retry 和 Recovery 以后:
真实世界状态会不会乱?
例如:
退款接口已执行成功
↓
响应丢失
↓
Agent 只看到超时
↓
再次重试
↓
重复退款
逐项注释(1)
- Agent
- Agent:智能体。
这里 Reliability 的核心不是“能重试”,而是:
能安全重试。
1.2.5 故障隔离(Containment)
一个 Tool 或子 Agent 挂了:
会不会整个任务全部失败?
甚至:
会不会所有 Agent 一起疯狂 Retry,把平台拖垮?
因此需要:
- Failure Isolation(故障隔离)
- Circuit Breaker(熔断)
- Bulkhead(舱壁隔离)
- Backpressure(背压)
- Graceful Degradation(优雅降级)
AWS 的 Agentic AI 可靠性设计原则也强调持久消息、故障隔离、从最近的正确状态恢复、多 Agent 韧性协调和定期演练故障路径。
1.3 六类故障:可靠性的真正起点
在谈 Retry 之前,应该先判断:
到底发生了什么类型的失败?
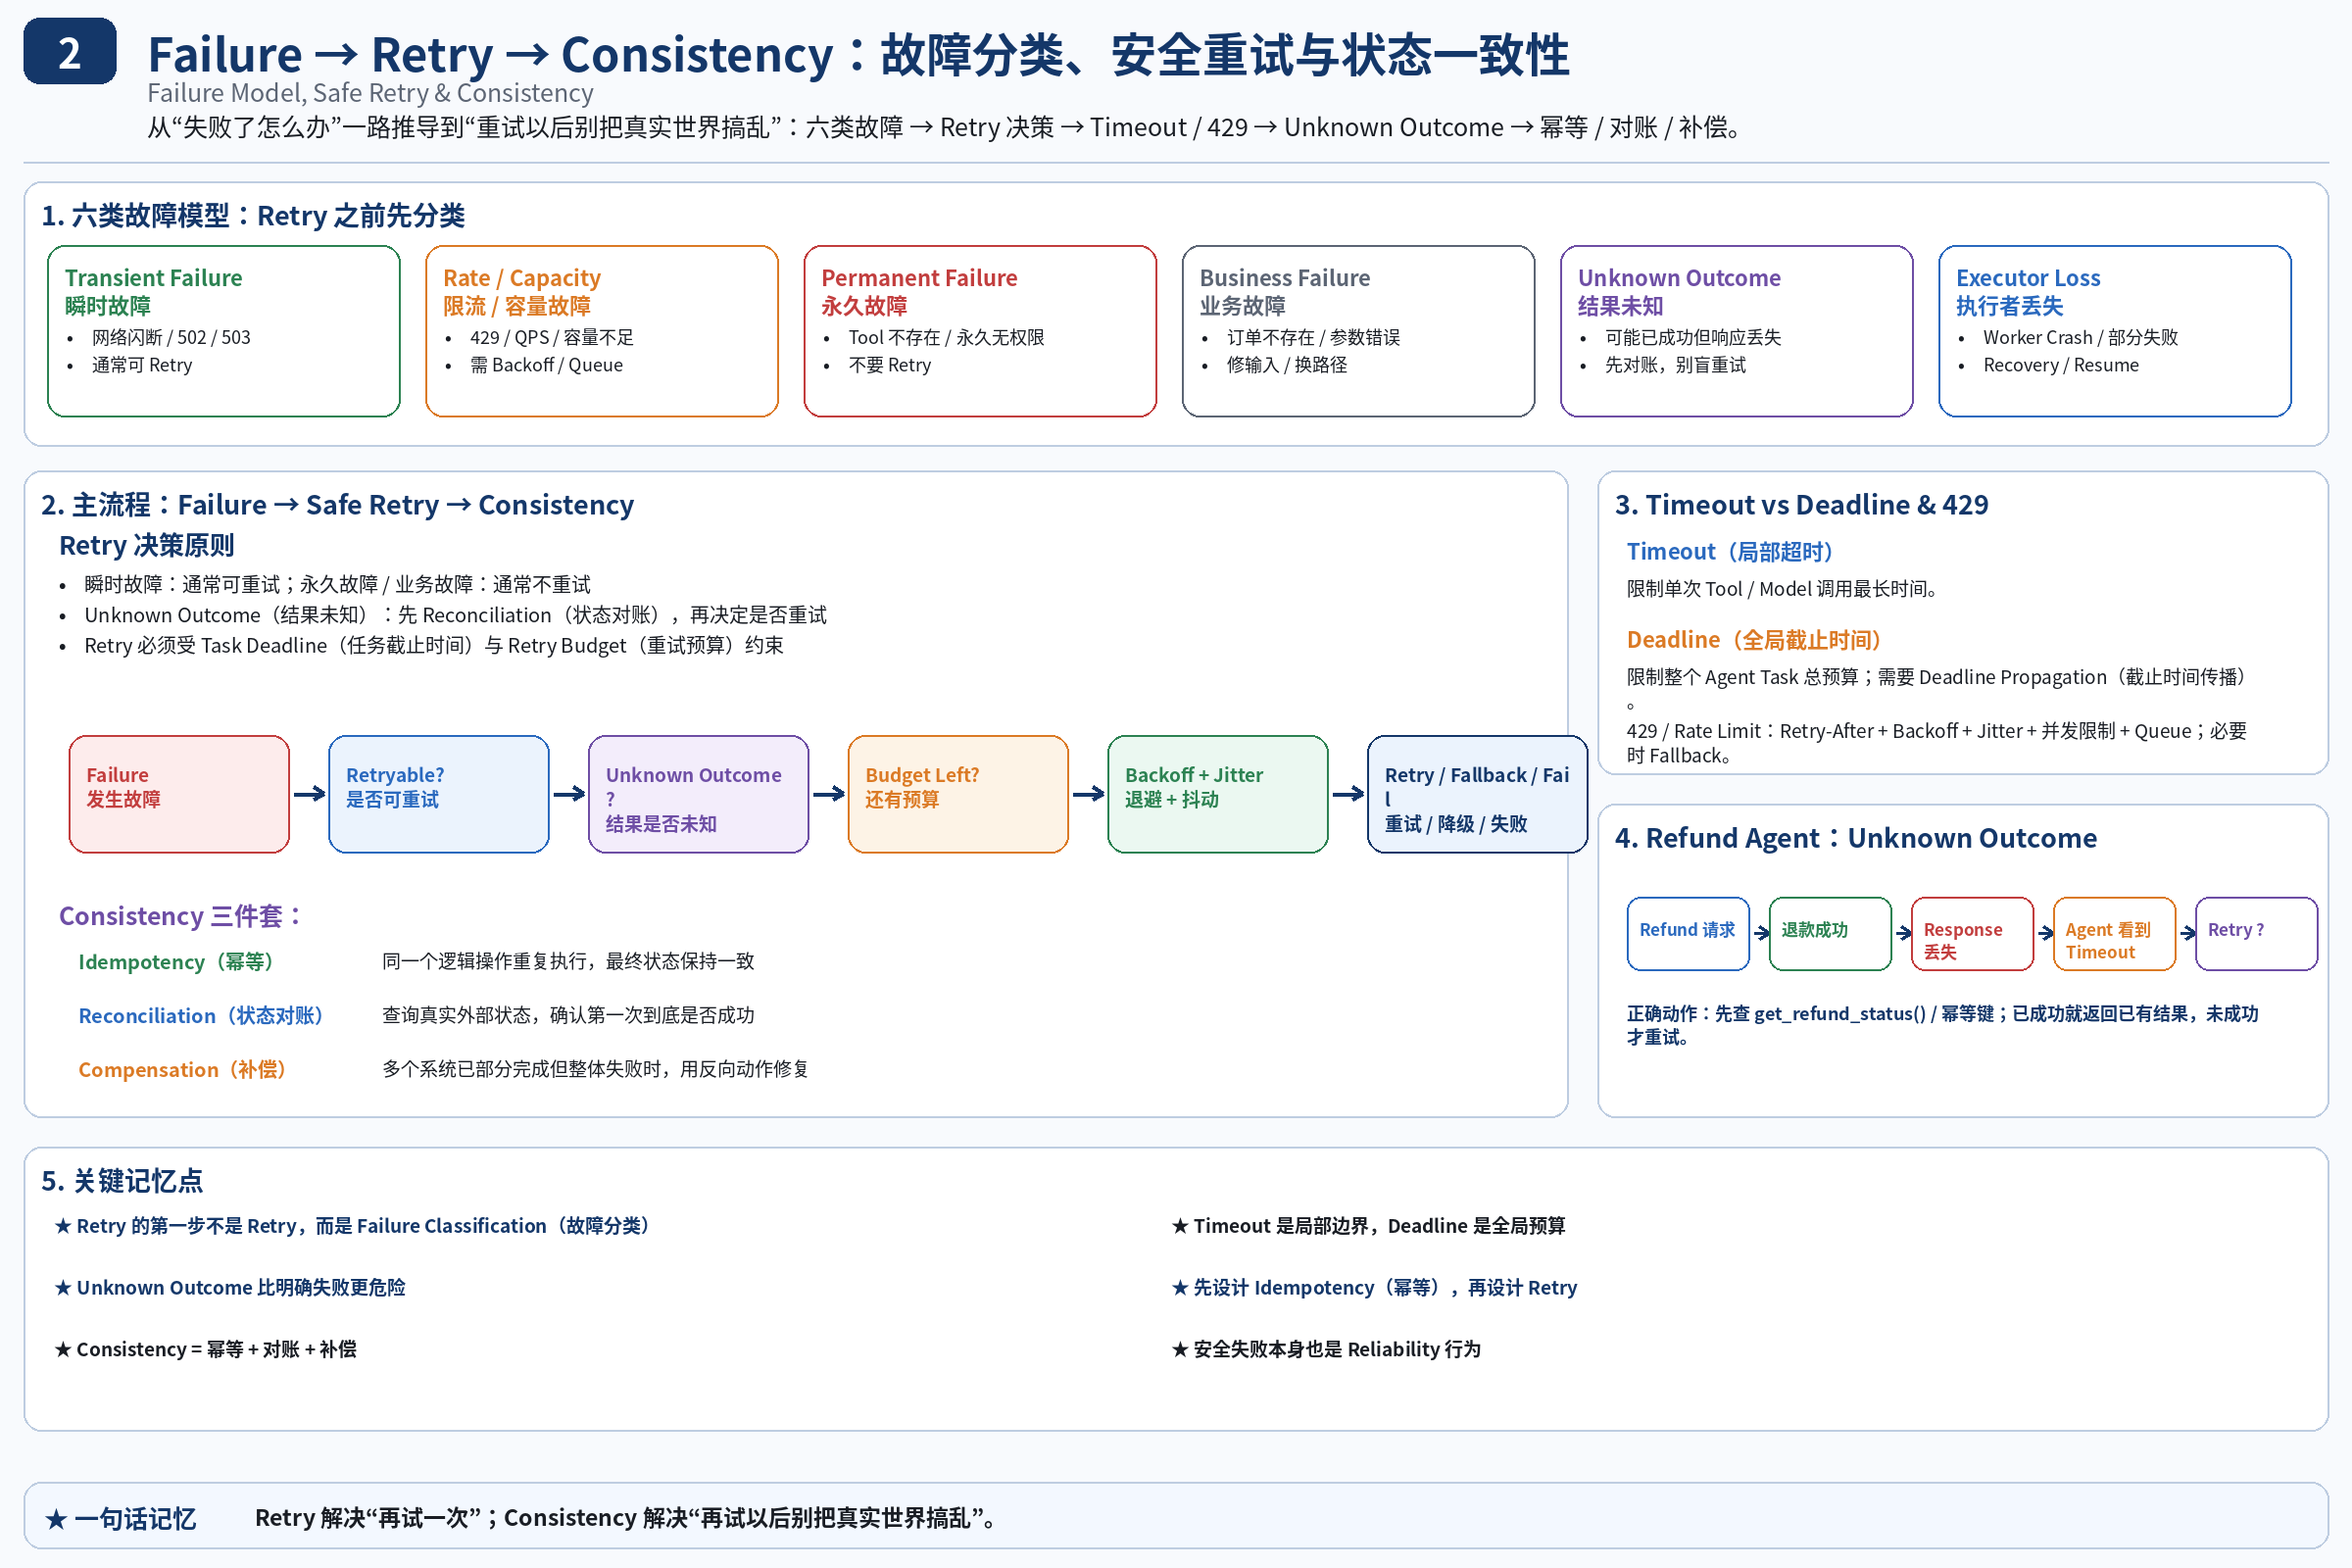
推荐把 Agent 故障归纳成六类。
1.3.1 瞬时故障(Transient Failure)
例如:
- 临时网络失败
- 502 / 503
- 短暂数据库连接异常
特点:
过一会再试可能恢复。
1.3.2 限流 / 容量故障(Rate / Capacity Failure)
例如:
- HTTP 429
- GPU 或模型服务容量不足
- Queue 堆积
核心不是立即重试,而是:
减速、等待、限并发。
1.3.3 永久故障(Permanent Failure)
例如:
- Tool 不存在
- API 已下线
- 永久无权限
Retry 没意义。
1.3.4 业务失败(Business Failure)
例如:
- 订单不存在
- 参数非法
- 不满足退款资格
这是业务路径问题,不是基础设施可靠性问题。
1.3.5 结果未知(Unknown Outcome)
最危险的一类:
Tool 请求发出
↓
外部系统可能已经执行
↓
网络断开
↓
Agent 不知道成功还是失败
逐项注释(2)
- Tool
- Tool:工具。
- Agent
- Agent:智能体。
此时不能盲目重试。
1.3.6 执行者丢失 / 部分失败(Executor Loss / Partial Failure)
例如:
- 工作进程崩溃
- 编排器崩溃
- 多 Agent 中部分子任务失败
这类问题需要:
故障恢复、从持久状态续跑,以及对部分失败的处理。
1.4 小结
可靠性的第一性问题不是:
“失败了重试几次?”
而是:
先识别故障类型,再决定恢复机制。
记住:
先做故障分类,再决定能否重试。
二、稳定交付(Stability)
2.1 可靠性和质量到底有什么区别?
核心:
质量看 Agent 能否做对;可靠性看它能否持续、安全地交付这个能力。
Data Agent 可能:
第 1 次:正确 ✅
第 2 次:正确 ✅
第 3 次:工具调用超时 ❌
第 4 次:429 ❌
第 5 次:服务重启状态丢失 ❌
此时问题不是:
“Agent 不会做。”
而是:
“Agent 无法可靠交付它会做的能力。”
2.1.1 面试追问
Q:95% 成功率能上线吗?
不能单看百分比。
内容生成 Agent 和金融操作 Agent 的容错完全不同。
所以,可靠性目标必须结合:
业务风险等级 + SLO(服务等级目标)
定义。
2.1.2 记忆点
成功过 ≠ 稳定成功。
2.2 Agent 为什么会偶发失败(Flaky)?
偶发失败指:
同一个 Case,有时成功、有时失败。
原因主要两类:
2.2.1 模型行为波动
同一个问题有时调用工具 A,有时调用工具 B。
2.2.2 工程随机故障
路径不变,但某个 Tool 随机 Timeout。
工程上应通过:
多次独立运行(Multiple Trials)
并同时查看:
- 成功率
- 执行步骤和工具调用的波动
- 延迟波动
- 失败发生的位置与类型
2.2.3 怎么区分模型问题和工程问题?
看执行记录(Trace):
- 决策路径变化大 → 更偏模型随机性
- 路径一致但固定节点随机失败 → 更偏工程稳定性
2.2.4 记忆点
稳定性不仅看成功率,还要看行为方差和失败分布。
2.3 可靠性应该看哪些指标?
建议至少分四层。
2.3.1 任务级(Task-level)
- Task Success Rate(任务成功率)
- First-pass Success Rate(首次成功率)
- Flaky Rate(偶发失败率)
2.3.2 依赖级(Dependency-level)
- Tool Error Rate(工具错误率)
- Model Error Rate(模型调用错误率)
- Timeout Rate(超时率)
- Rate-limit Rate(限流率)
2.3.3 恢复级(Recovery-level)
- Retry Success Rate(重试成功率)
- Recovery Success Rate(恢复成功率)
- Resume Success Rate(续跑成功率)
- Mean Recovery Time(平均恢复时间)
2.3.4 一致性级(Consistency-level)
- Duplicate Side-effect Rate(重复副作用率)
- State Conflict Rate(状态冲突率)
- Compensation Failure Rate(补偿失败率)
2.3.4.1 关键观点
Agent 的可靠性不能只看 API 是否返回 200。
API 200:
不代表任务可靠完成。
三、故障韧性(Resilience)
3.1 哪些错误可以重试,哪些不能?
判断原则:
瞬时故障
→ 判断操作能否安全重试

限流 / 容量不足
→ 退避 + 排队 + 限量重试

永久故障
→ 停止并报错

业务失败
→ 修正输入或调整业务路径

结果未知
→ 先对账,再决定下一步
例如:
503 Service Unavailable(服务暂不可用)逐项注释(2)
- Service
- Service:服务。
- Unavailable
- Unavailable:不可用状态。
在操作可安全重试且还有预算时,可以重试。
但:
Order Not Found(订单不存在)逐项注释(1)
- Order Not Found
- 订单不存在:查询不到目标订单的业务错误。
如果订单确实不存在:
重试 100 次也没意义。
3.1.1 记忆点
可恢复故障才重试,确定性错误不要重试。
3.2 重试策略应该怎么设计?
可靠的重试策略至少考虑五件事:
3.2.1 是否可重试(Retryability)
先判断错误类型。
3.2.2 最大次数(Retry Count)
不同操作不同。
3.2.3 指数退避(Exponential Backoff)
1s → 2s → 4s → 8s逐项注释(1)
- s
- s:秒或示例变量 S,依上下文确定。
3.2.4 随机抖动(Jitter)
避免大量 Agent 同一时刻再次冲击下游。
3.2.5 重试预算(Retry Budget)
例如:
任务截止时间 = 60 秒
重试预算 = 15 秒
预算耗尽后必须停止。
完整逻辑:
发生故障
↓
可安全重试?
↓
还有预算?
↓
退避 + 随机抖动
↓
重试
↓
备用方案 / 安全失败
3.2.5.1 面试追问
Q:为什么不固定重试 3 次?
因为:
- 错误类型不同
- 操作风险不同
- 任务剩余时间不同
- 下游健康状态不同
3.2.5.2 记忆点
重试要看故障类型、安全性和预算,不是简单循环几次。
3.3 局部超时和任务截止时间有什么区别?
3.3.1 局部超时(Timeout)
某一次局部调用最长多久。
3.3.2 任务截止时间(Deadline)
整个 Agent Task 最晚什么时候结束。
例如:
任务截止时间 = 60 秒

工具 A 超时 = 10 秒
工具 B 超时 = 20 秒
逐项注释(2)
- A
- A:示例标识 A。
- B
- B:示例标识 B。
如果任务只剩:
5 秒不能再给下游:
20 秒的调用时间应该做:
Deadline Propagation(截止时间传播)
3.3.2.1 记忆点
Timeout 是局部边界,Deadline 是全局预算。
3.4 遇到 HTTP 429(限流)怎么处理?
推荐组合:
- 优先遵守服务端的 Retry-After(建议等待时间)
- 指数退避,并加入随机抖动
- 限制并发,必要时排队
- 仍无法完成时,使用事先验证过的备用方案或安全失败
错误做法:
429
↓
立即重试
↓
再次收到 429
↓
更频繁地重试
这很容易形成雪崩。
3.4.1 取舍
备用模型可能提高可用性,但也可能降低回答质量。
所以需要预先定义:
哪些任务允许降级,哪些任务必须直接失败。
3.5 重试、备用方案和安全失败怎么选?
3.5.1 重试(Retry)
瞬时故障 + 重复执行安全。
3.5.2 备用方案(Fallback)
当前依赖不可用,但存在可接受替代。
3.5.3 安全失败(Fail)
不可恢复、业务错误、权限错误,或者继续执行风险更高。
3.5.3.1 核心认知
可靠性不等于“永远继续执行”。安全失败本身也是一种可靠行为。
3.6 小结
故障韧性的核心不是:
“多重试几次。”
而是:
让故障恢复变成一套有预算、有分类、有边界的决策。
四、状态一致性(Consistency)
4.1 为什么重试最危险的是重复副作用?
经典例子:
Agent → 退款接口
          ↓
       退款成功
          ↓
      网络断开
          ↓
Agent 看到超时
          ↓
        再次请求
          ↓
      再次退款
逐项注释(1)
- Agent
- Agent:智能体。
Agent 看到的是:
超时。
但真实世界可能已经成功。
这就是:
结果未知(Unknown Outcome)
4.1.1 记忆点
明确失败不可怕,结果未知最危险。
4.2 为什么幂等性是可靠性的核心?
幂等性:
同一个逻辑操作执行一次或多次,最终状态相同。
天然幂等:
set_status(active) # 将状态设为“启用”;重复设置结果相同逐项注释(2)
- set_status
- 函数名:设置任务或业务状态。
- active
- active:活跃状态。
非幂等:
refund_money()  # 退款:重复调用可能重复退钱
send_email()    # 发邮件:重复调用可能重复发送
charge_card()   # 扣款:重复调用可能重复扣钱
create_order()  # 创建订单:重复调用可能创建多个订单
逐项注释(4)
- refund_money
- 函数或动作名:执行退款。
- send_email
- 函数或工具名:发送电子邮件。
- charge_card
- 函数或动作名:向银行卡扣款。
- create_order
- 函数或工具名:创建订单。
因为 Agent 可能遇到:
- 重试
- 中断后续跑
- 工作进程恢复
- 消息重复投递
所以重复执行是常态风险。
AWS 的幂等执行建议也强调:同一逻辑操作的重试应使用稳定的幂等键,并把它传给支持幂等的下游系统。
4.2.1 记忆点
先设计幂等,再设计 Retry。
4.3 幂等键(Idempotency Key)怎么设计?
例如:
operation = refund          # 操作类型:退款
order_id = 456              # 订单编号
logical_request_id = abc123 # 本次逻辑请求的稳定编号
逐项注释(5)
- operation
- operation:操作。
- refund
- refund:退款。
- order_id
- 字段或变量名:订单的唯一标识。
- logical_request_id
- 字段或变量名:同一逻辑业务请求的稳定标识。
- abc123
- abc123:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
形成:
refund:456:abc123 # 由“操作类型:订单编号:逻辑请求编号”组成的幂等键逐项注释(2)
- refund
- refund:退款。
- abc123
- abc123:该纯文本块中的英文节点、参数、示例值或操作名称,具体语义由所在行及相邻流程共同确定。
第一次:
执行并保存结果。
后续使用相同幂等键:
返回第一次结果,不再次执行。
好的幂等键需要:
- 对同一逻辑操作稳定
- 不同操作不冲突
- 生命周期清晰
- 下游服务真正持久化结果
4.4 工具执行成功但响应丢失,怎么办?
优先:
Reconciliation(状态对账 / 状态确认)
例如:
发起退款
↓
请求超时
↓
查询退款状态
↓
状态已确认?
├─ 已完成 → 返回已有结果
├─ 确认未执行 → 在幂等保护下决定是否重试
└─ 仍不确定 → 暂停并继续对账或转人工
本质:
以权威业务状态为准;一次查询没查到,不等于操作一定没发生。
4.5 At-most-once、At-least-once、Exactly-once 怎么理解?
4.5.1 At-most-once(最多一次)
不重复,但可能遗漏。
4.5.2 At-least-once(至少一次)
在持续投递和处理的前提下会至少尝试一次,但可能重复。
4.5.3 Exactly-once(恰好一次)
理想上既不漏又不重复,但在真实分布式系统中很难天然保证。
生产上更常见:
At-least-once + Idempotency
在下游能够识别同一业务操作、持久保存结果等条件下,可以实现:
Business Exactly-once Effect(业务层恰好一次效果)。
4.6 副作用水位标记是什么?
对于无法安全重复的动作:
发送邮件
扣款
外部写操作
可以在副作用发生前持久化:
task_123:send_email = pending # 任务 123 的邮件操作:可能已开始,结果待确认逐项注释(3)
- task_123
- 示例任务标识。
- send_email
- 函数或工具名:发送电子邮件。
- pending
- pending:等待处理状态。
提交成功后更新:
completed # 已确认完成逐项注释(1)
- completed
- completed:已完成状态。
恢复时先检查这个标记。但 pending 只说明操作可能已经开始,不能据此判断外部动作没有发生;仍需幂等键或权威状态对账。
Microsoft 当前的长任务恢复设计也建议:对不可安全重复的副作用,持久保存执行水位和检查点元数据。
4.7 为什么有了幂等性,还需要补偿?
例如:
创建订单 ✅
扣库存   ✅
扣款     ✅
创建物流 ❌
前面三个系统已经发生真实动作。
不能靠回滚本地数据库撤销这些外部动作。
此时需要:
Compensation(补偿操作)
例如:
物流失败
↓
退款
↓
恢复库存
↓
取消订单
这就是 Saga(补偿事务)思想。
4.7.1 幂等、对账和补偿各做什么
- 幂等:防止同一操作重复生效
- 对账:确认外部真实状态
- 补偿:处理部分动作已经完成、整体任务却失败的情况
4.7.1.1 取舍
补偿本身也可能失败。
所以补偿动作也应该:
- 幂等
- 可重试
- 可追踪
- 必要时人工兜底
4.8 小结
状态一致性通常需要三种机制配合:
幂等
防重复
+
对账
确认真实状态
+
补偿
修复部分完成
一句话:
重试解决“能否再试”,一致性解决“再试之后别把真实世界搞乱”。
五、持久执行(Durability)
5.1 Agent 运行 30 分钟后崩溃,应该怎么办?
最差:
全部从头重跑。
问题:
- 已完成工作白费
- 时间浪费
- 重复调用工具
- 重复副作用
生产设计:
从最近安全恢复边界继续。
需要:
- Checkpoint(检查点)
- Durable State(持久状态)
- Resume(恢复执行)
Anthropic 对多 Agent Research 系统的复盘也提到:长任务从头重启代价高,因此结合重试和定期检查点,从已保存的进度恢复。
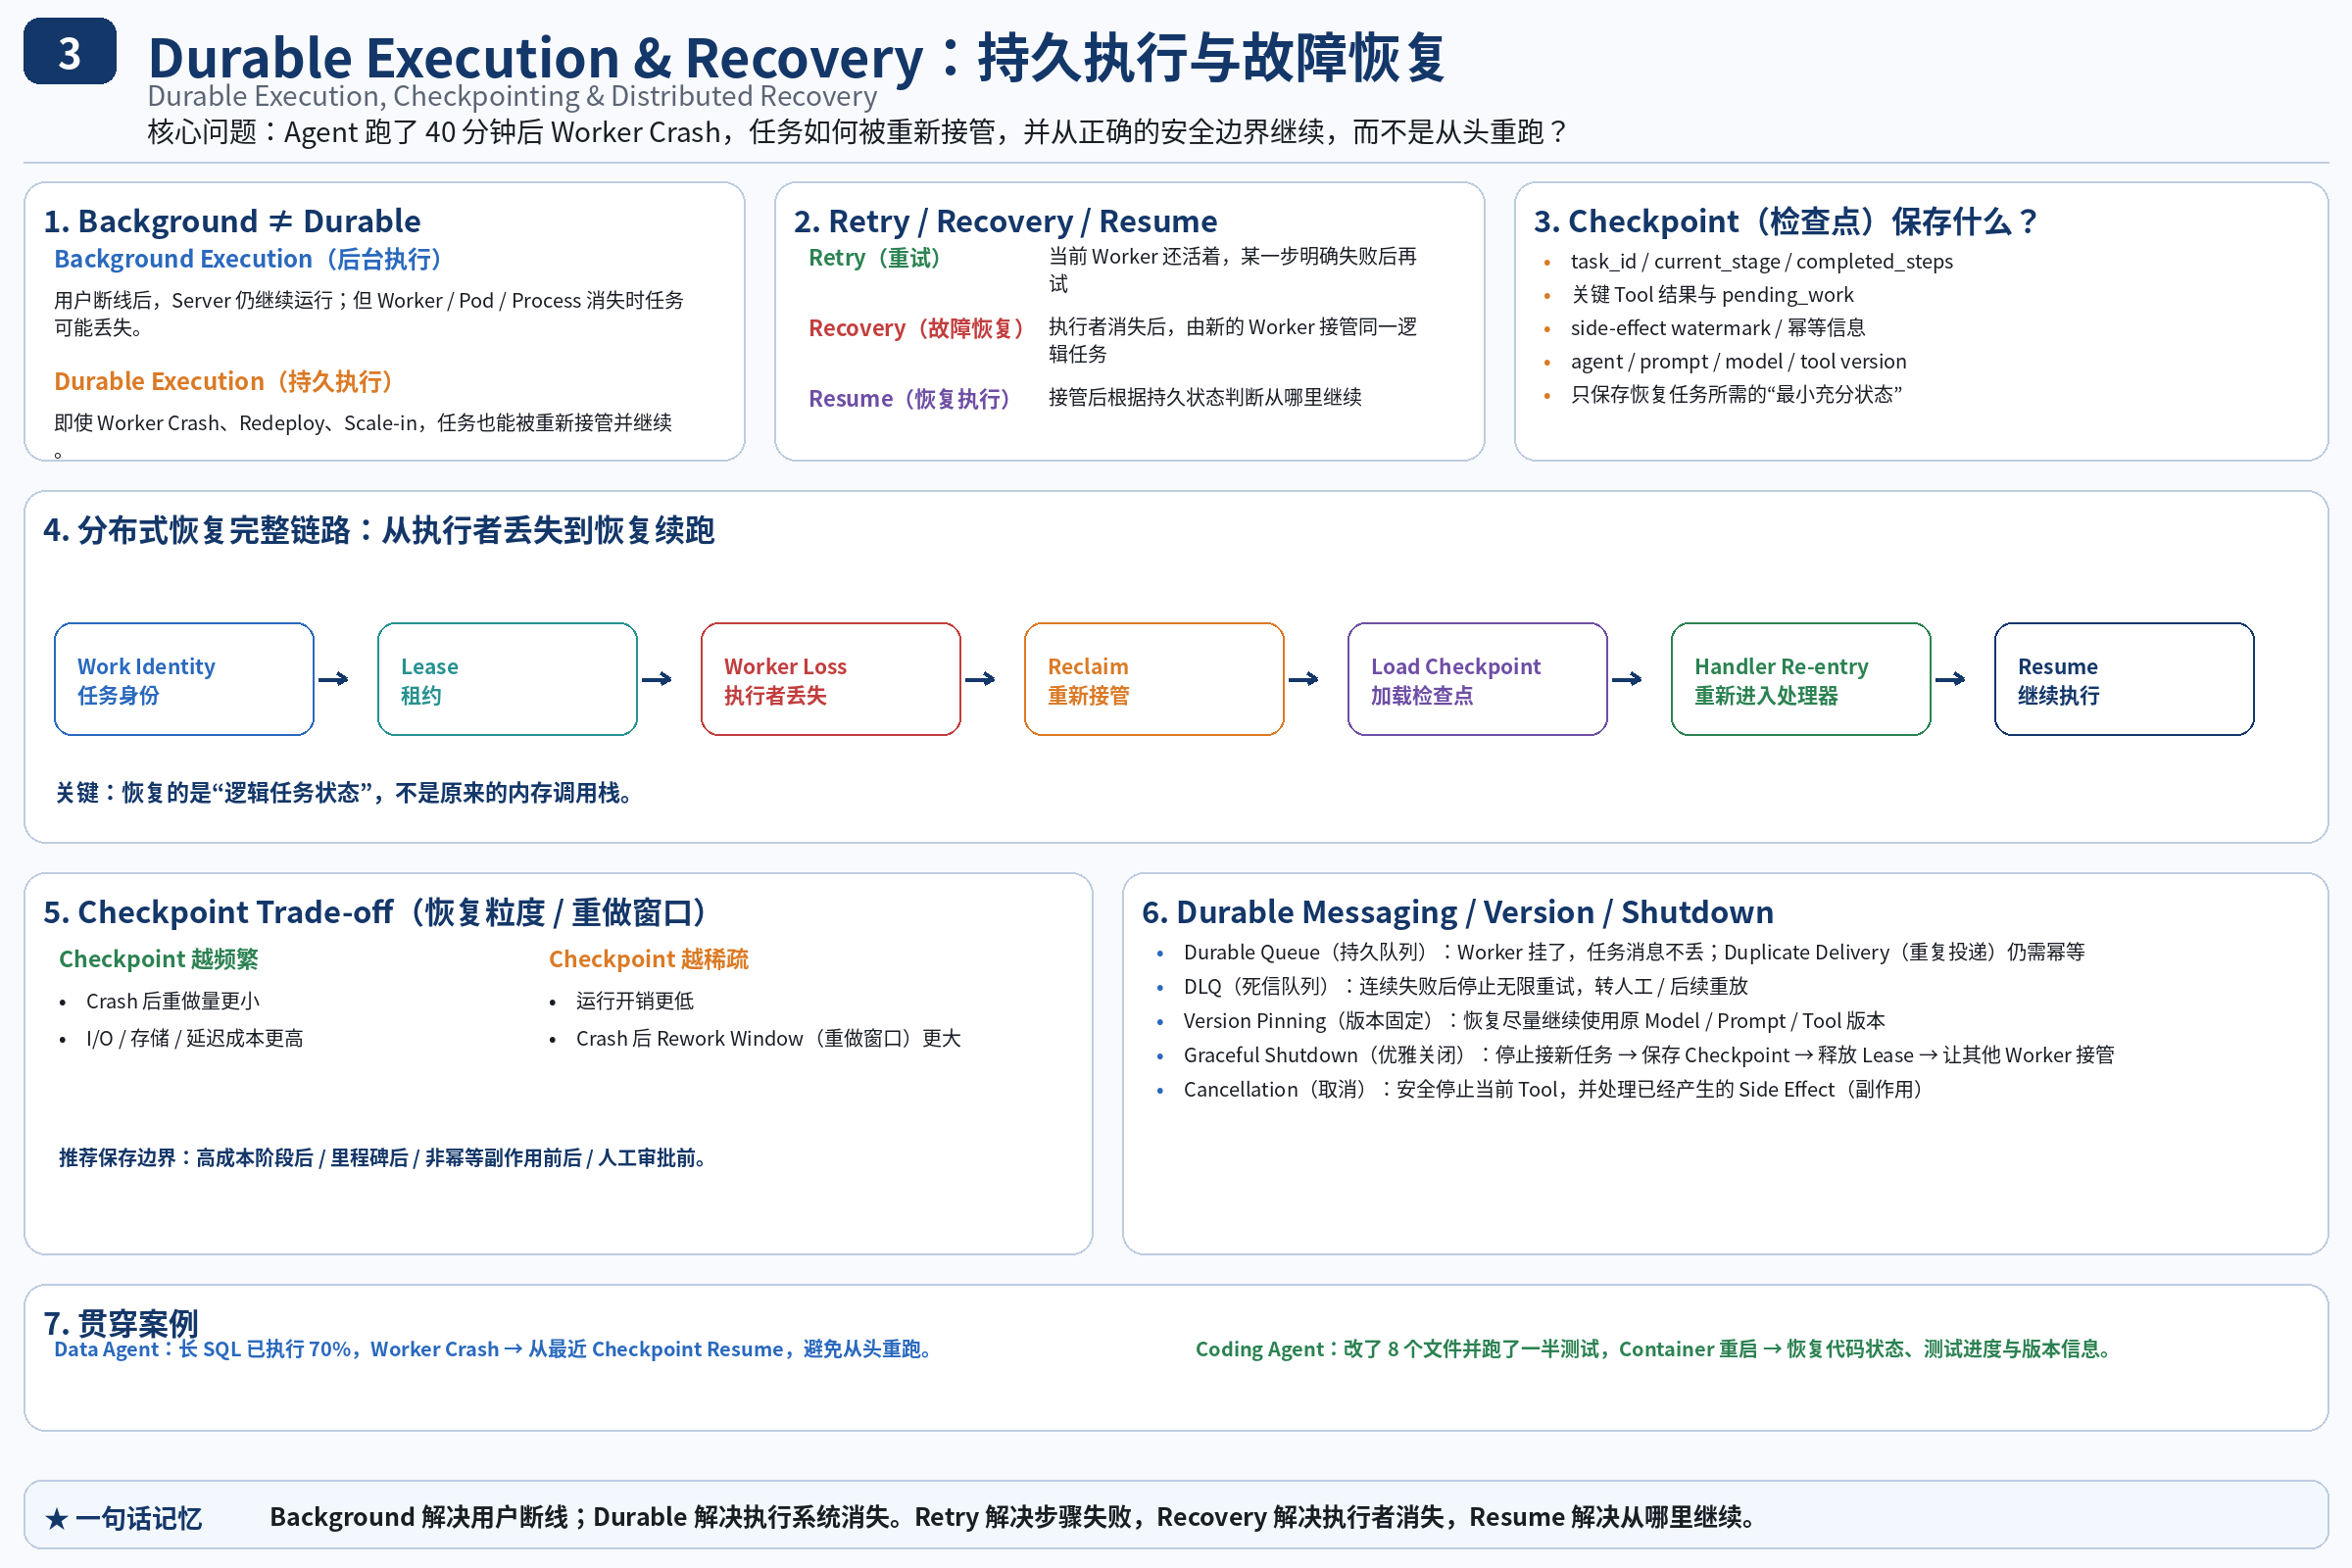
5.2 检查点(Checkpoint)应该保存什么?
不是:
dump 整个进程内存。
而是:
保存恢复任务所需的最小充分状态。
例如:
task_id                 # 任务 ID
current_stage           # 当前阶段
completed_steps         # 已完成步骤
important_tool_results  # 关键工具结果
pending_work            # 尚未处理的工作
side_effect_watermark   # 已触发副作用的水位标记
agent_version           # Agent 版本
prompt_version          # 提示词版本
tool_version            # 工具版本
checkpoint_pointer      # 检查点存储位置
逐项注释(12)
- task_id
- 字段或变量名:任务的唯一标识。
- ID
- ID:唯一标识符。
- current_stage
- 字段名:当前任务阶段。
- completed_steps
- 字段名:已经完成的步骤。
- important_tool_results
- 字段名:需要持久保留的重要工具结果。
- pending_work
- 字段名:尚未完成的工作。
- side_effect_watermark
- 字段名:已经完成的外部副作用水位。
- agent_version
- 字段名:智能体版本。
- Agent
- Agent:智能体。
- prompt_version
- 字段名:提示词版本。
- tool_version
- 字段名:工具版本。
- checkpoint_pointer
- 字段名:指向最近检查点的位置。
Microsoft 当前也建议小型 runtime metadata 只保存 checkpoint reference(检查点引用)、最后完成阶段、幂等键等,大型中间结果放到应用或框架自己的持久存储。
5.3 检查点多久保存一次?
这里要权衡恢复成本与运行成本。
Checkpoint 越频繁:
- 恢复重做量越小
- I/O / 存储成本越高
Checkpoint 越稀疏:
- 正常运行成本越低
- 崩溃后需要重做越多
推荐在:
- 高成本阶段结束后
- Milestone(里程碑)后
- 非幂等副作用前后
- 人工审批前
- 长阶段边界
做 Checkpoint。
这里真正要设计的是:
Recovery Granularity(恢复粒度)
和:
Rework Window(重做窗口)
例如每个 phase(阶段)后 checkpoint:
如果阶段结果和外部副作用也能安全恢复,崩溃后最多重做一个阶段。
Microsoft 当前示例同样推荐在干净的 phase boundary(阶段边界)保存恢复点。
5.4 重试、故障恢复和续跑到底有什么区别?
这是必须讲清楚的一题。
5.4.1 重试(Retry)
当前 Worker 还活着,某一步明确失败,再试一次。
5.4.2 故障恢复(Recovery)
当前 Worker / Process 消失,需要新的执行者重新接管。
5.4.3 续跑(Resume)
重新接管以后,从持久状态决定从哪里继续。
记:
重试处理步骤失败;故障恢复处理执行者消失;续跑决定从哪里继续。
Microsoft 当前明确指出 Recovery 不等于 Retry:Recovery 是同一个 durable attempt(持久任务尝试)的重新接管,不应该简单消耗普通 Retry Budget。
5.5 后台执行和持久执行有什么区别?
后台执行(Background Execution):
用户断线后任务还能继续。
持久执行(Durable Execution):
运行任务的 Process / Worker 消失后任务仍能恢复。
所以:
Background ≠ Durable
Microsoft 当前把这两者明确区分。
5.6 故障恢复会恢复原来的内存调用栈吗?
通常不会。
更现实的是:
工作进程 A 崩溃
↓
工作进程 B 接管
↓
读取检查点
↓
重新进入处理程序
↓
判断哪些阶段已完成
↓
续跑
逐项注释(2)
- A
- A:示例标识 A。
- B
- B:示例标识 B。
所以:
恢复的是逻辑任务状态,不是内存调用栈。
Microsoft Foundry 当前 resilient work model 也是 Handler Re-entry(重新进入处理器),而不是恢复局部变量和原调用栈。
5.7 任务身份、租约和重新接管解决什么?
假设 Worker A 正在执行:
task_123 # 一个稳定的任务编号,接管进程据此找到同一任务逐项注释(1)
- task_123
- 示例任务标识。
工作进程 A 崩溃。
系统要解决:
- 怎么知道 A 已经挂?
- B 什么时候能接管?
- 怎么避免 A 和 B 同时执行?
典型方式:
任务身份(Work Identity)
稳定任务 ID
↓
租约(Lease)
工作进程 A 获得执行租约
↓
租约过期
↓
工作进程 B 接管
↓
读取检查点
↓
续跑
逐项注释(5)
- Work Identity
- 工作身份:用于稳定标识同一业务工作的键,支持防重和恢复。
- ID
- ID:唯一标识符。
- Lease
- Lease:有期限的执行租约。
- A
- A:示例标识 A。
- B
- B:示例标识 B。
这也是 Microsoft 当前持久任务恢复模型的核心机制之一。
5.8 持久消息和死信队列为什么重要?
如果多个 Agent 全部同步 RPC 串联:
Agent A → Agent B → Agent C → 工具调用逐项注释(4)
- Agent
- Agent:智能体。
- A
- A:示例标识 A。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
任何一个慢或挂:
故障容易级联传播。
更加可靠的设计:
发起任务的 Agent
↓
持久队列(Durable Queue)
↓
工作进程 / Agent
逐项注释(3)
- Agent
- Agent:智能体。
- Durable
- Durable:持久的。
- Queue
- Queue:队列。
消息持久化以后:
工作进程崩溃后,任务不会直接消失。
如果一条消息重复失败:
进入死信队列(DLQ)等待处理
而不是无限 Retry。
AWS 当前的 Agent 设计建议也把持久消息、重试和死信处理列为可靠性的基础设计原则。
5.8.1 还要注意
持久消息通常意味着:
可能重复投递。
因此仍必须:
配合幂等设计。
5.9 恢复时版本已经变化怎么办?
任务开始:
模型 V1
提示词 V10
工具 V3
逐项注释(3)
- V1
- V1:该纯文本块中的状态、决策或错误枚举值。
- V10
- V10:该纯文本块中的状态、决策或错误枚举值。
- V3
- V3:该纯文本块中的状态、决策或错误枚举值。
恢复时:
模型 V2
提示词 V11
工具 V4
逐项注释(3)
- V2
- V2:该纯文本块中的状态、决策或错误枚举值。
- V11
- V11:该纯文本块中的状态、决策或错误枚举值。
- V4
- V4:该纯文本块中的状态、决策或错误枚举值。
直接继续可能让前后执行语义不一致。
三种策略:
5.9.1 版本固定(Version Pinning)
任务生命周期内尽量使用原版本。
5.9.2 状态迁移(State Migration)
显式把旧状态迁移成新版本可理解格式。
5.9.3 安全失败(Fail Safe)
无法确认兼容时,不盲目继续。
5.10 优雅关闭和取消任务怎么处理?
意外崩溃:
突然死亡。
优雅关闭(Graceful Shutdown):
系统提前知道要退出,例如发布、缩容、SIGTERM。
应该:
停止接受新任务
↓
保存检查点
↓
释放租约
↓
让其他工作进程接管取消任务(Cancellation):
用户主动取消。
此时要处理:
- 当前 Tool 是否能停止
- 已发生的副作用怎么办
- 是否需要补偿
- 是否返回部分结果
Microsoft 当前也明确区分崩溃恢复、正常关闭和主动取消任务。
5.11 小结
持久执行不只是:
“存一个检查点”。
而是:
任务身份
↓
持久状态
↓
检查点
↓
租约
↓
检测执行进程丢失
↓
重新接管
↓
重新进入处理程序
↓
续跑
一句话:
持久执行的目标,不是保存程序,而是保证逻辑任务不会因为执行进程死亡而消失。
六、故障隔离(Containment)
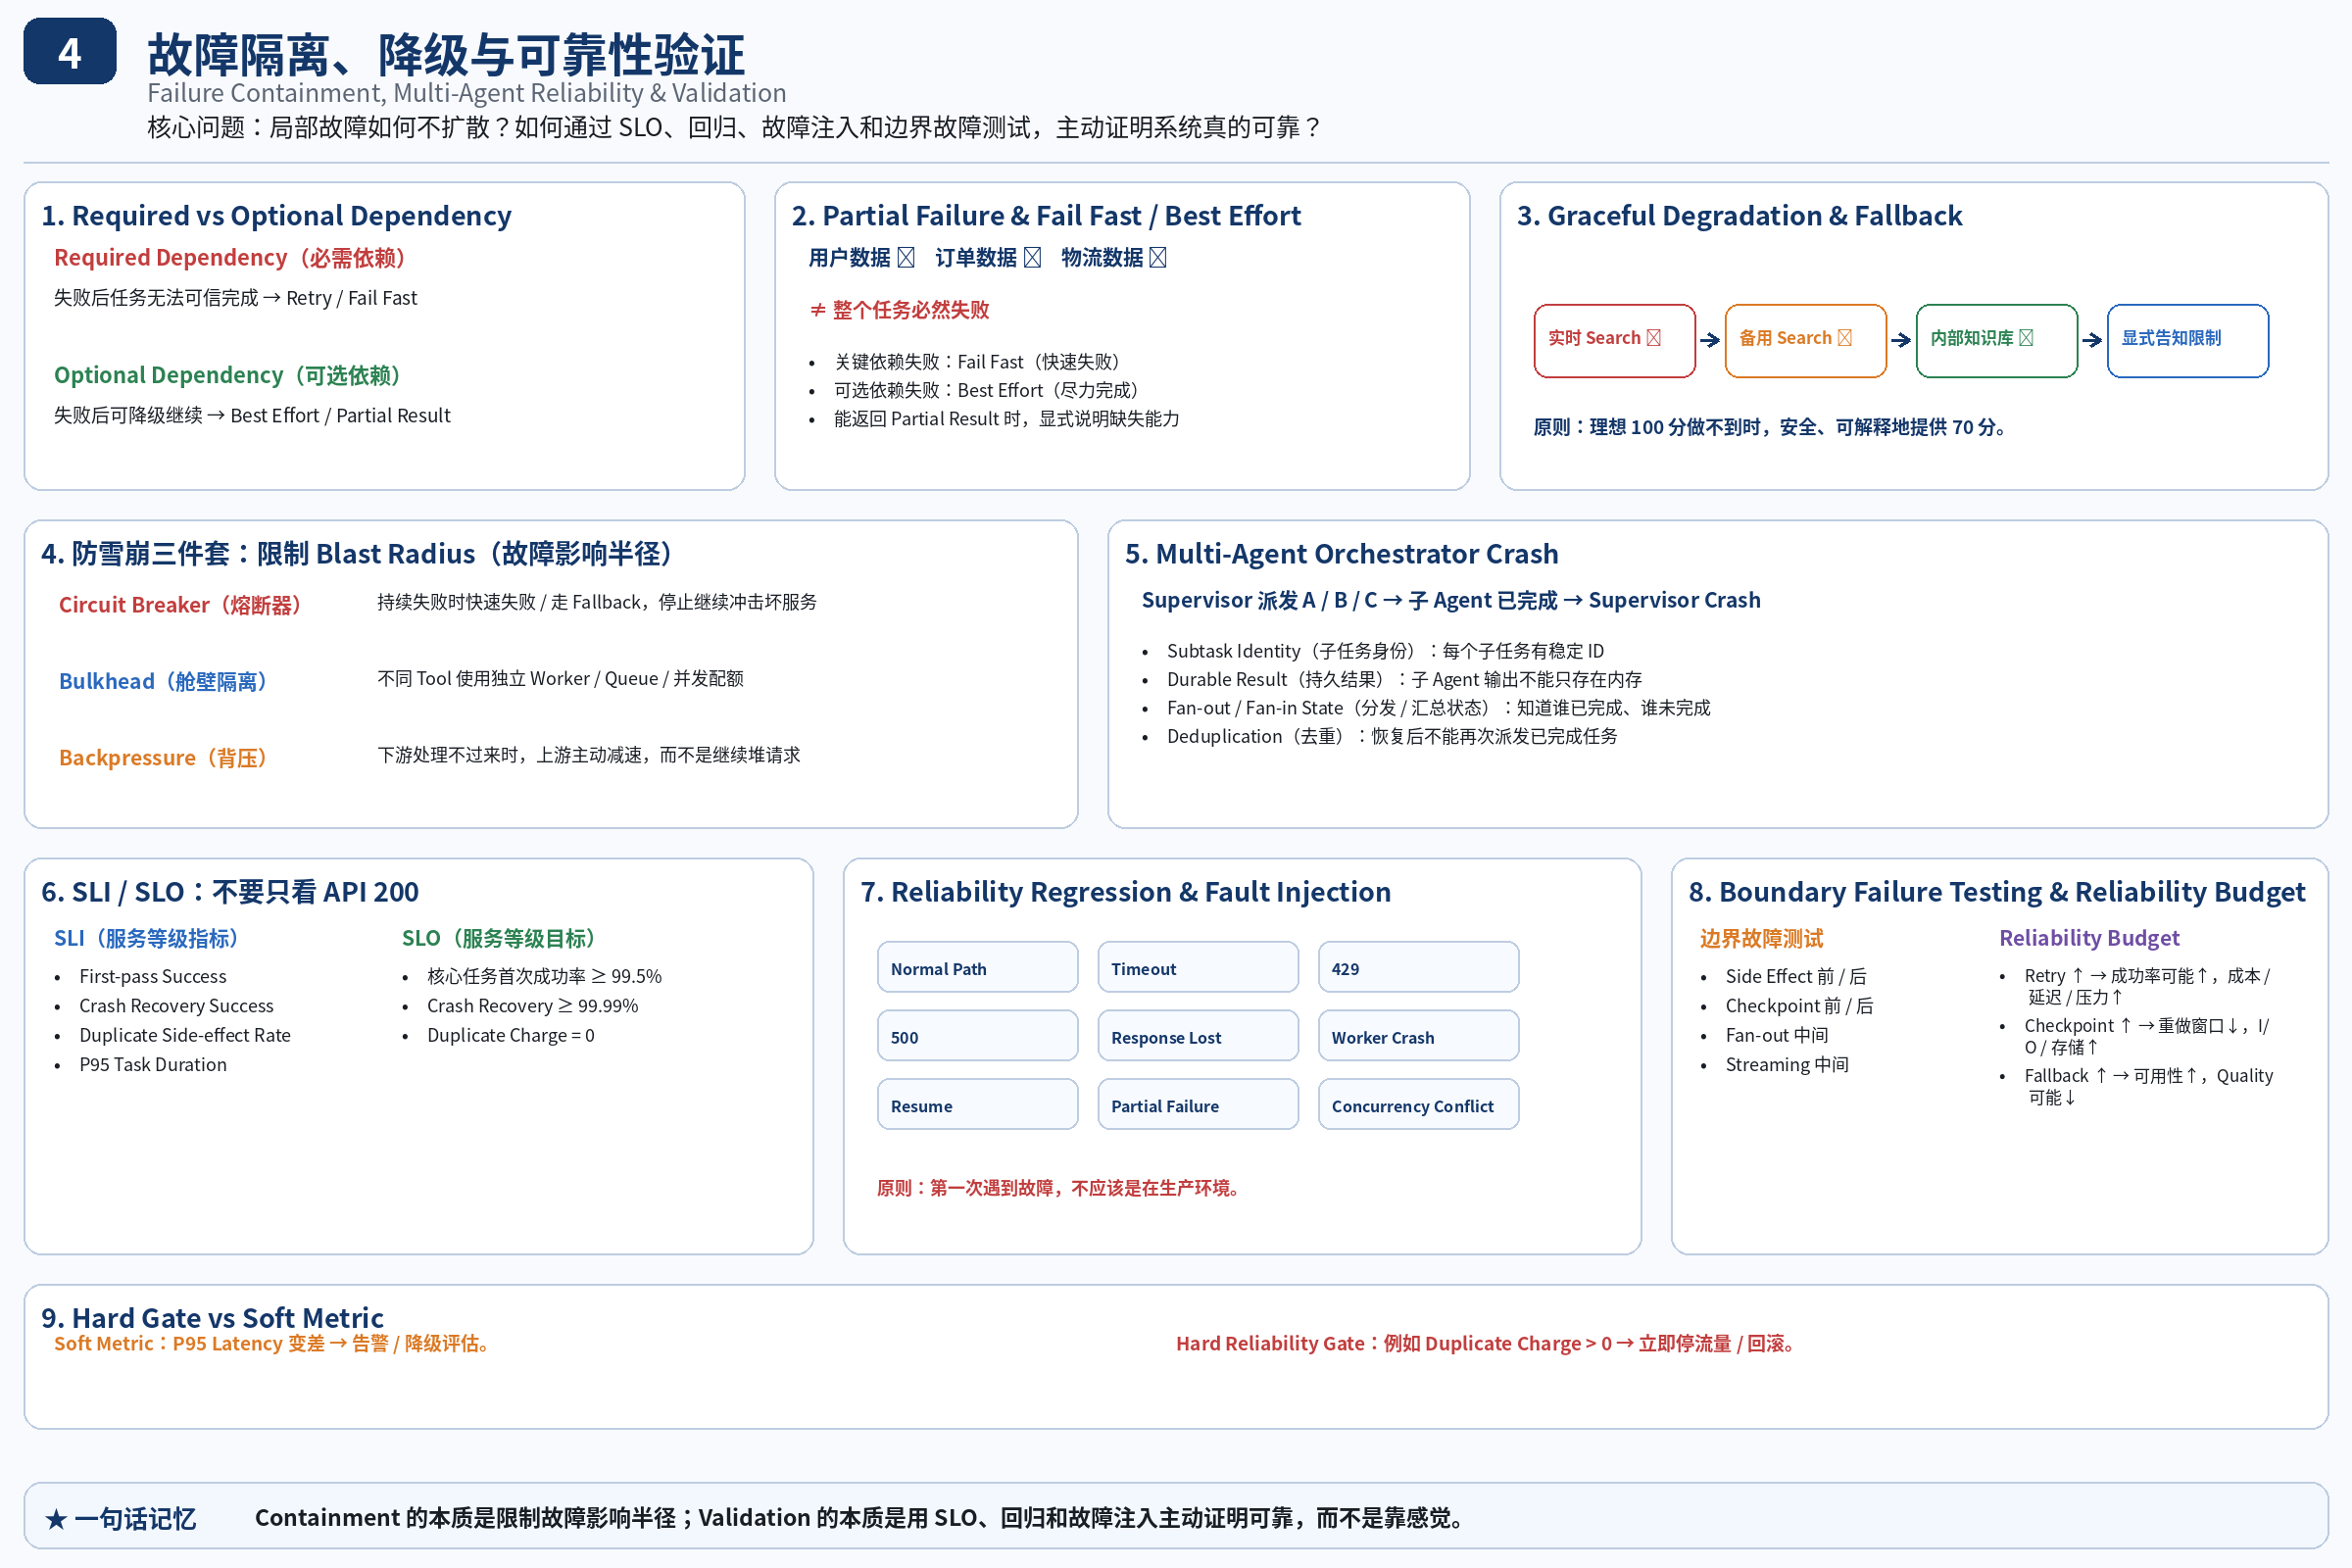
6.1 多 Agent 中一个子 Agent 失败,整个任务应该失败吗?
先区分:
6.1.1 必需依赖(Required Dependency)
缺失后任务无法可信完成。
6.1.2 可选依赖(Optional Dependency)
缺失后可以降级继续。
例如:
协调 Agent
├─ SQL Agent      必需
├─ 搜索 Agent     可选
└─ 报告 Agent     必需
逐项注释(2)
- Agent
- Agent:智能体。
- SQL
- SQL:结构化查询语言。
Search Agent 挂了:
可以输出“缺少外部实时信息”的降级版本。
SQL Agent 挂了:
如果缺少它就无法可信地完成任务,应明确失败。
6.2 并行工具调用出现部分失败,怎么办?
例如:
用户数据 ✅
订单数据 ✅
物流数据 ❌
不是机械全部失败。
应该判断:
- 物流信息是不是必须
- 是否能安全重试
- 是否能稍后补
- 是否能返回部分结果,并说明缺失内容
可靠的行为可能是:
“订单和用户信息已确认,但物流系统暂时不可用,因此暂时无法确认配送时间。”
6.3 快速失败和尽力完成怎么选?
6.3.1 快速失败(Fail Fast)
核心依赖失败后继续执行没有意义或存在风险。
例如:
身份校验失败
↓
停止支付
6.3.2 尽力完成(Best Effort)
部分结果仍然有价值。
例如 Research Agent:
10 个来源
8 个成功
2 个失败
如果这 8 个来源足以支撑结论,可以完成报告,但要说明覆盖范围;否则应继续补充来源或明确无法回答。
原则:
关键依赖失败就及时报错;可选依赖可以在说明限制后尽力完成。
6.4 优雅降级和备用方案怎么设计?
优雅降级(Graceful Degradation):
完整能力暂时不可用时,在可接受范围内提供受限结果。
例如:
实时搜索不可用
↓
备用搜索不可用
↓
只用企业内部知识库
↓
明确告诉用户“实时信息暂不可用”
关键:
降级必须显式、可解释。
不能把低质量数据偷偷伪装成实时数据。
6.5 熔断、舱壁隔离和背压分别解决什么?
6.5.1 熔断器(Circuit Breaker)
下游持续失败时,暂时停止请求。
6.5.2 舱壁隔离(Bulkhead)
不同工具使用不同 Worker / Queue / 并发配额,避免互相拖死。
6.5.3 背压(Backpressure)
下游处理不过来时,上游主动减速。
核心目的:
限制 Blast Radius(故障影响半径)。
AWS 当前 Reliability 设计同样强调模块化故障隔离和避免同步依赖导致级联失败。
6.6 编排器自己崩溃怎么办?
Multi-Agent 最容易遗漏的一点:
子 Agent 全部成功,协调层也可能失败。
例如:
协调 Agent 派发任务 A/B/C
↓
A ✅ B ✅ C ✅
↓
协调 Agent 崩溃
↓
恢复后不知道三个任务已完成
↓
再次派发
逐项注释(4)
- Agent
- Agent:智能体。
- A
- A:示例标识 A。
- B
- B:示例标识 B。
- C
- C:示例标识 C。
因此 Multi-Agent Reliability 要持久化:
- Subtask Identity(子任务身份)
- Fan-out State(分发状态)
- Durable Result(持久结果)
- Fan-in State(汇总状态)
- Deduplication(去重)
本质:
协调状态本身也必须持久化。
6.7 小结
故障隔离的目标不是:
每个组件永不失败。
而是:
局部故障不自动升级成全局故障。
记:
必需依赖失败
→ 安全重试 / 明确失败

可选依赖失败
→ 显式降级

持续失败
→ 熔断

资源耗尽
→ 背压 / 舱壁隔离
七、可靠性验证(Validation)
7.1 可靠性的 SLI / SLO 应该怎么定义?
SLI(Service Level Indicator,服务等级指标):
实际测什么。
例如:
- 首次任务成功率
- 崩溃后恢复成功率
- 重复副作用率
- 任务耗时的 P95
SLO(Service Level Objective,服务等级目标):
要达到什么。
下面的数值只用于说明目标写法,不能直接作为所有 Agent 的上线标准:
核心任务首次成功率 ≥ 99.5%
崩溃后恢复成功率 ≥ 99.99%
重复扣款次数 = 0
关键:
Agent 的服务目标应该面向任务结果,不能只看接口可用率。
7.2 可靠性回归测试应该覆盖什么?
至少:
正常路径
+
超时
+
429(请求过多,被限流)
+
500(服务器内部错误)
+
响应丢失
+
网络断开
+
工作进程崩溃
+
恢复续跑
+
防止重复执行
+
部分步骤失败
+
并发执行冲突
每次:
- 更换模型
- 升级运行环境
- 修改工具
- 调整重试策略
都应该跑。
7.3 为什么要主动注入故障?
主动模拟:
- Tool Timeout
- 429
- 500
- Network Failure
- Kill Worker
- DB Slowdown
- Queue Saturation
然后观察:
- 是否安全重试
- 是否恢复
- 是否重复产生副作用
- 是否降级
- 是否产生雪崩
AWS 当前 Reliability 原则也明确强调:故障路径必须定期演练,第一次遇到故障不应该是在生产环境。
7.4 为什么要测试副作用与状态落盘之间的故障?
Agent 最危险的故障常发生在:
“事情已经做了,但状态还没记下来”
这种边界。
例如:
退款成功
↓
检查点写入前
↓
工作进程崩溃
所以应该主动在:
- 副作用发生前
- 副作用发生后
- 检查点写入前
- 检查点写入后
- 并行任务派发过程中
- 流式输出过程中
主动终止工作进程。
7.4.1 记忆点
最危险的崩溃往往发生在“副作用已完成、持久状态尚未更新”的那一瞬间。
7.5 怎么验证崩溃后真的能正确恢复?
设计测试:
步骤 1 ✅
步骤 2 ✅
外部副作用已发生 ✅
检查点已写入 ✅
步骤 4 执行中
↓
终止工作进程
↓
工作进程 B 接管
↓
从检查点续跑
逐项注释(1)
- B
- B:示例标识 B。
验证:
- 任务是否还在
- 租约是否安全转移
- 检查点是否正确读取
- 已完成步骤是否跳过
- 副作用是否重复发生
- 最终任务是否正确
7.6 模型升级为什么也要重新测试可靠性?
新模型可能:
- Tool 调用更激进
- Retry 意愿更强
- Step 数变多
- Loop 概率变化
- Stop Decision 变化
- Fallback 行为不同
例如:
模型“更坚持不懈”
可能导致:
下游坏掉时不断换 Tool、不断重试,反而降低可靠性。
所以:
模型升级也可能改变系统的可靠性。
7.7 什么时候应该自动降级、回滚或停止流量?
例如:
任务失败率明显上升
恢复成功率明显下降
重复副作用次数 > 0
可以触发:
- 切换备用方案(Fallback)
- Rollback(回滚)
- Disable Tool(禁用工具)
- Stop Traffic(停止流量)
特别是:
重复扣款 > 0属于:
Hard Reliability Gate(可靠性硬门禁)
不能被总体成功率掩盖。
7.8 小结
可靠性不能靠:
“我感觉这个 Agent 挺稳定。”
必须通过:
正常路径
+
重试
+
超时
+
限流
+
结果未知
+
进程崩溃
+
恢复续跑
+
幂等
+
补偿
+
部分失败
+
边界故障
主动证明。
八、可靠性的“预算观”
这是本章一个非常重要的高级认知。
可靠性不是:
越强越好,不计成本。
每种可靠性机制都有代价。
8.1 重试更多
- 成功率可能提高
- 延迟和成本也提高
- 下游压力提高
8.2 检查点更频繁
- 恢复重做更少
- I/O 和存储成本更高
8.3 更多备用方案
- 可用性可能提高
- 结果质量可能下降
8.4 更强的冗余
- 可靠性可能提高
- 系统复杂度和成本提高
所以,设计时需要一起看任务成功率、故障恢复时间、延迟、成本和运维复杂度,而不能只提高某一个指标。
一句话:
可靠性是有预算的工程,不是无限重试、无限保存检查点、无限增加冗余。
九、可靠性与其他模块的边界
9.1 质量(Quality)
做对了吗?
9.2 可靠性(Reliability)
出故障后还能不能安全、稳定、可恢复地继续?
9.3 可控性(Controllability)
Agent 的行为能不能被规则、审批、人类限制和干预?
9.4 可观测性(Observability)
系统到底发生了什么,我们看不看得见?
边界例子:
9.4.1 以超时为例
- 怎么发现 → 可观测性
- 要不要重试 → 可靠性
- 最多允许执行几步 → 可控性
- 重试后结果对不对 → 质量
这样边界最干净。
十、四个贯穿案例
10.1 退款 Agent(Refund Agent)
用于理解:
- Unknown Outcome
- Idempotency
- Reconciliation
- Watermark
- Compensation
核心问题:
退款已成功,但响应丢了,要不要 Retry?
10.2 数据 Agent(Data Agent)
用于理解:
- Tool Timeout
- Long-running SQL
- Checkpoint
- Resume
- Fallback
- Partial Failure
10.3 代码 Agent(Coding Agent)
用于理解:
- Long-running Task
- Container Crash
- Checkpoint
- Version Pinning
- Resume
- Regression Test
10.4 多 Agent(Multi-Agent)
用于理解:
- Partial Failure
- 必需依赖与可选依赖
- Orchestrator Crash
- Durable Coordination
- Degradation
十一、P0 / P1 / P2
11.1 P0:必须掌握
- 可靠性与质量的区别
- Agent 的偶发失败
- 可靠性指标
- 故障分类
- 重试策略
- 局部超时与任务截止时间
- 限流处理
- 重试、备用方案与安全失败
- 结果未知
- 幂等性
- 幂等键
- 状态对账
- 至少一次投递与幂等
- 检查点
- 重试、故障恢复与续跑
- 后台执行与持久执行
- 崩溃后恢复
- 部分失败
- 快速失败与尽力完成
- 优雅降级
- 可靠性回归测试
- 故障注入与边界测试
11.2 P1:高级工程师
- 补偿与 Saga
- 副作用水位标记
- 恢复粒度
- 持久消息与死信队列
- 任务身份、租约与重新接管
- 版本固定
- 编排器恢复
- 熔断、舱壁隔离与背压
- 可靠性 SLO
11.3 P2:平台 / 架构岗位
- 分布式故障恢复
- 事件日志与快照
- 跨工作进程续跑
- 业务层恰好一次效果
- 持久化协调状态
- 混沌工程
- 跨 Agent 状态一致性
十二、高价值连续追问链
12.1 追问链 1:Retry
什么错误可以重试?
↓
429 呢?
↓
为什么需要退避?
↓
为什么还要随机抖动?
↓
重试预算是什么?
↓
如果第一次其实已经成功怎么办?
↓
怎么保证不重复副作用?
最后自然进入:
幂等 + 对账。
12.2 追问链 2:退款 Timeout
退款请求超时
↓
直接重试吗?
↓
为什么不能?
↓
怎么判断第一次是否成功?
↓
下游支持幂等键时怎么做?
↓
不支持怎么办?
↓
已经部分执行怎么办?
最后进入:
水位标记 + 对账 + 补偿。
12.3 追问链 3:长任务 Crash
Agent 运行 40 分钟后崩溃
↓
为什么不能从头跑?
↓
检查点保存什么?
↓
多久保存一次?
↓
谁发现工作进程挂了?
↓
谁接管?
↓
从哪里续跑?
↓
版本变了怎么办?
逐项注释(1)
- Agent
- Agent:智能体。
最后进入:
任务身份 + 租约 + 重新接管 + 版本固定。
12.4 追问链 4:Multi-Agent
一个子 Agent 挂了怎么办?
↓
全部失败吗?
↓
怎么区分必需 / 可选依赖?
↓
并行工具部分失败怎么办?
↓
编排器自己挂了呢?
↓
怎么避免子任务重复?
逐项注释(1)
- Agent
- Agent:智能体。
最后进入:
持久化协调状态 + 部分失败处理 + 去重。
十三、12 个本质技术点
- 可靠性不是永不失败,而是失败后仍然有序。
- 先识别故障,再决定能否重试。
- 超时是局部边界,截止时间是全局预算。
- 重试需要退避、随机抖动和预算约束。
- 结果未知时先对账,不能把超时当成明确失败。
- 先设计幂等,再设计重试。
- 幂等防重复,对账查状态,补偿处理部分完成。
- 后台执行不等于持久执行。
- 重试、故障恢复和续跑解决三件不同的事。
- 检查点保存逻辑状态,不恢复原来的内存调用栈。
- 故障隔离要限制局部故障的影响范围。
- 可靠性要靠故障注入和边界测试主动验证。
十四、2~3 分钟面试标准回答
如果面试官问:
你怎么理解生产级 Agent 的 Reliability?
可以回答:
生产级 Agent 的可靠性,不只是设置超时和重试。它可能连续调用模型和工具、运行很长时间,还可能修改真实业务状态。因此,我会从五个方面看:正常情况下能否稳定完成任务,故障发生时能否合理处理,进程消失后进度能否恢复,重试后业务状态会不会出错,以及局部故障会不会扩散。
处理故障时,我会先分类。短暂故障可以在安全且有预算的前提下重试;遇到限流要退避并控制并发;权限或业务条件不满足时,应明确失败,不能靠多试几次解决。
最需要小心的是结果未知。比如退款已经成功,但响应丢了,Agent 只看到超时。这时不能直接再退一次,要用幂等键和权威业务状态确认结果;如果多个系统只完成了一部分,还要考虑补偿和人工处理。
长任务还需要保存可恢复的进度。工作进程崩溃后,新进程能接管同一个任务,读取检查点,从安全的位置继续。这里要区分某一步失败后的重试、执行者消失后的故障恢复,以及接管后的续跑。
多 Agent 场景中,我会区分必需和可选依赖:必需结果缺失时明确失败,可选结果缺失时才考虑说明限制后继续。同时用熔断、资源隔离和背压限制故障扩散。
最后,这些能力要通过回归测试和故障注入验证,尤其测试“外部动作已完成、状态还没记下来”的时刻。可靠的 Agent 允许失败,但故障要可识别、恢复要安全、状态不能乱,影响也要有边界。
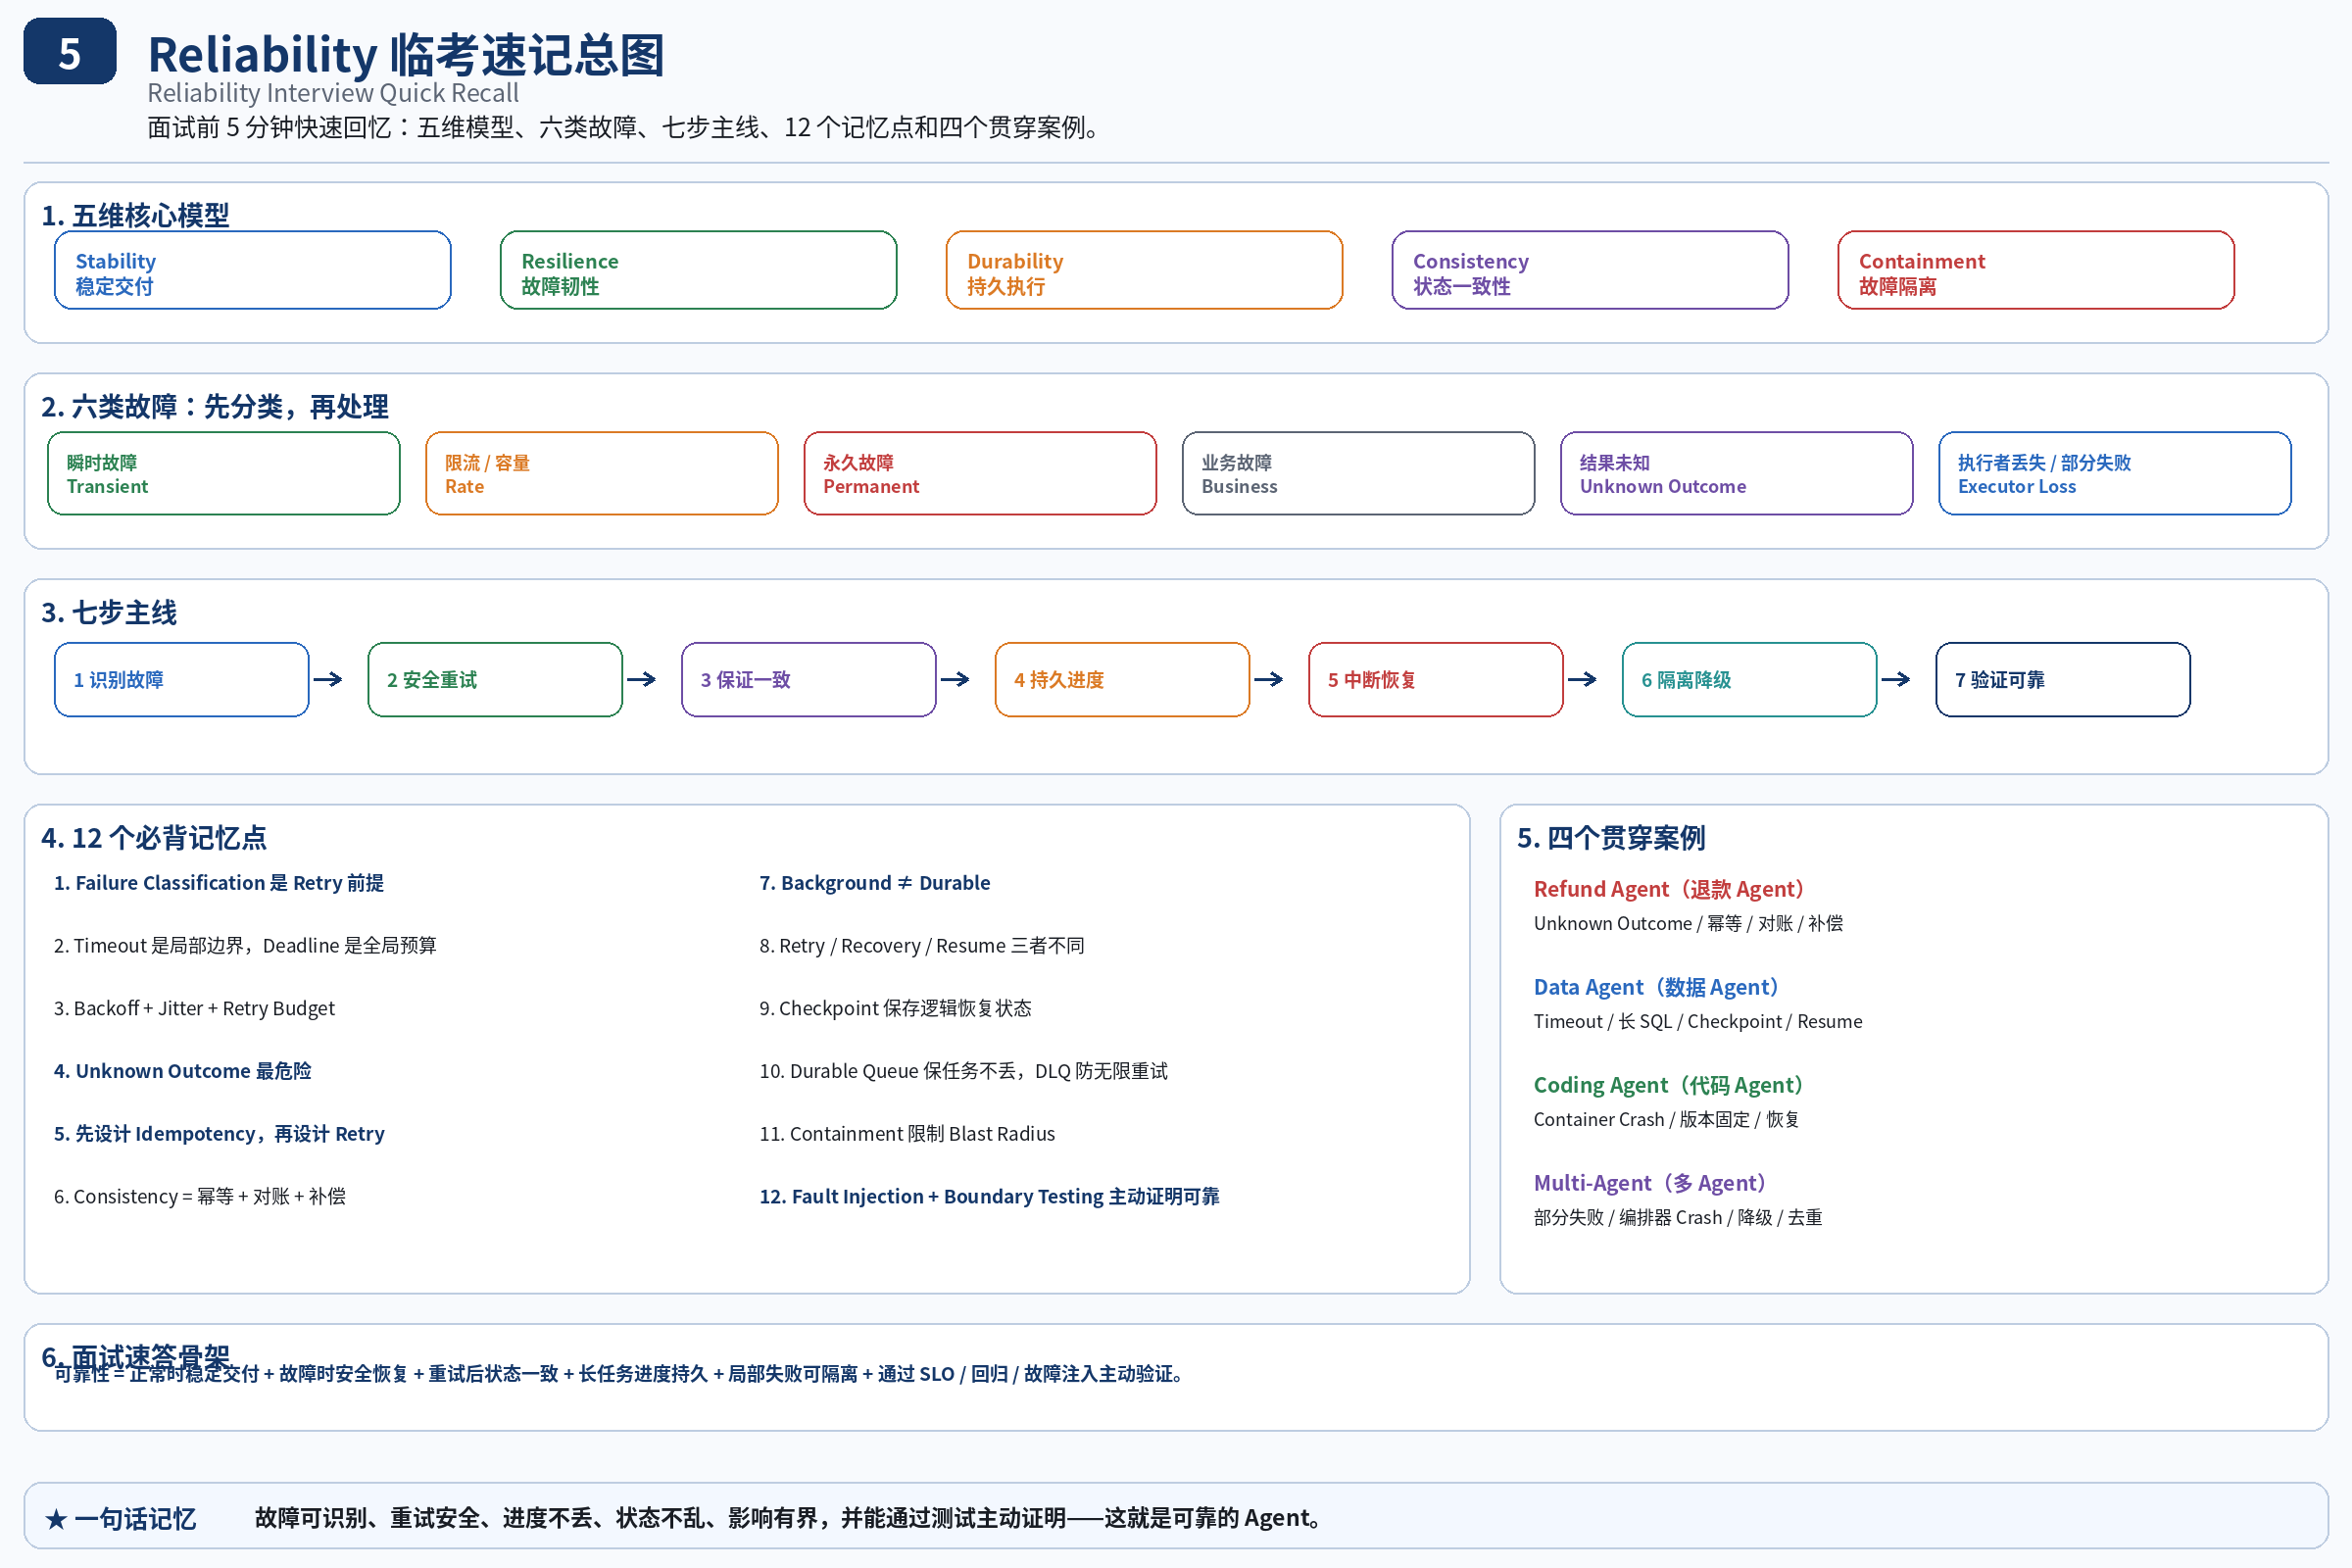
十五、最终记忆模型
15.1 五个核心维度
稳定交付(Stability) 故障韧性(Resilience) 持久执行(Durability) 状态一致性(Consistency) 故障隔离(Containment)
15.2 七步主线
识别故障 → 安全重试 → 保证一致 → 持久进度 → 中断恢复 → 隔离降级 → 验证可靠
15.3 十个关键术语
故障(Failure) 重试(Retry) 幂等(Idempotency) 对账(Reconciliation) 补偿(Compensation) 检查点(Checkpoint) 故障恢复(Recovery) 续跑(Resume) 隔离(Isolation) 验证(Validation)
15.4 一句话
Agent 可靠性的本质,不是永远不失败,而是让失败可识别、恢复安全、状态不乱、进度不丢、影响有界,并且这些能力能够被主动验证。